
gpu-unlock : doubler les TFLOPS d'une RTX 4090 avec deux valeurs
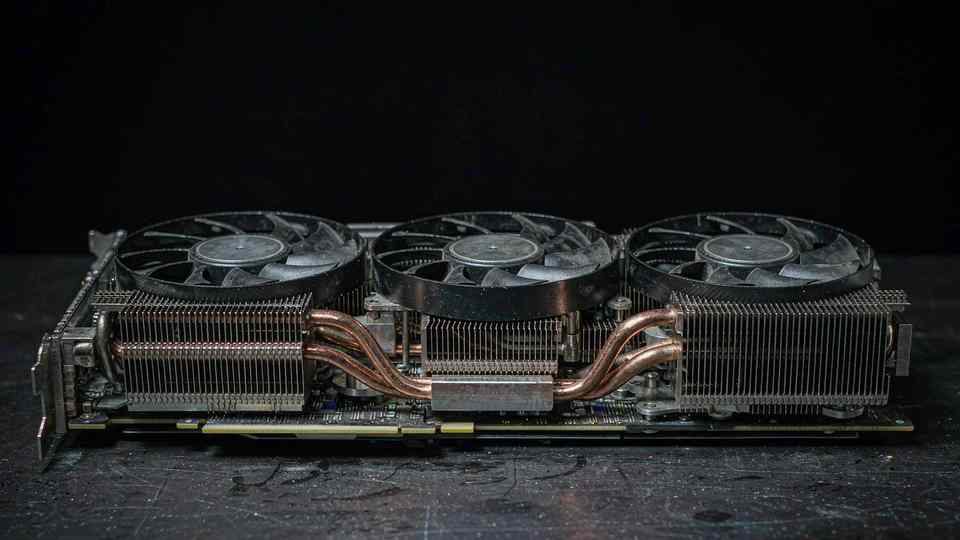
Il y a un chiffre dans le README de gpu-unlock qui m'a fait poser ma tasse : une RTX 4090 passe de 165 à 329 TFLOPS en calcul matriciel BF16. Pas par overclocking. Pas par un VBIOS trafiqué. En écrivant deux valeurs dans les sélecteurs de vitesse de la carte avant le chargement du pilote NVIDIA.
Le projet grimpe dans les tendances mensuelles de GitHub depuis le début de l'automne et tourne autour de 17 700 étoiles. C'est un module noyau Linux, en GPL-2.0, maintenu par une seule personne qui conclut son README en demandant qu'on l'aide à acheter d'autres GPU.
Ce que NVIDIA livre réellement
Les cartes GeForce sont livrées avec leurs cœurs tenseurs bridés à la moitié du débit pour le calcul FP16, BF16 et TF32 avec accumulation FP32. Ce n'est pas un jeu d'instructions de niche : c'est ce qu'utilisent presque toute l'inférence non quantifiée et la quasi-totalité du fine-tuning. Le même silicium vendu en RTX A-series ou en carte de datacenter tourne au débit plein.
Ce n'est un secret pour personne. C'est de la segmentation de marché, et le README le dit en une ligne quand un utilisateur demande pourquoi NVIDIA a bridé la carte : « ils veulent que les entreprises achètent les cartes professionnelles sans ces limitations, à des prix nettement plus élevés ».
Le débridage n'est ni un patch de pilote ni un flash de firmware. C'est un module qui s'exécute dans l'initramfs, avant que nvidia ne lie la carte, écrit les sélecteurs de vitesse (SS0 0x88888888 sélectionne le débit BF16 complet, un SS1 de 4 bits à 0x8 active IMLA4) puis effectue une réinitialisation au niveau fonction. La technique combine une approche de débridage existante et un minutage soigné. Comme rien sur le disque n'est modifié, une nouvelle version du pilote NVIDIA ne l'annule pas.
Les gains sont réels mais inégaux
Les chiffres de tête concernent le débit en matrices denses, et ils sont importants. Une RTX 3060 passe de 27 à 51 TFLOPS. Une 3090 de 75 à 125. Une 4090 double en pointe — avec la réserve, clairement énoncée, que la 4090 manque de puissance avant de manquer de cœurs tenseurs, si bien que les charges réelles gagnent bien moins que la pointe ne le suggère.
Les charges réelles, justement, sont plus intéressantes, parce que l'écart est énorme :
- Prefill LLM / traitement du prompt (FP16, BF16, AWQ, GPTQ) : +25 à 55 %
- Temps jusqu'au premier token : 25 à 30 % de moins
- LoRA et fine-tuning complet en BF16 : +25 à 50 %
- Génération d'images (SDXL, SD 1.5, modèles DiT dans ComfyUI) : +30 à 55 %
- Génération vidéo avec calcul BF16 (Wan 2.2) : +15 à 20 %
- Kernels FlashAttention et SDPA : +50 à 60 %
- llama.cpp / Ollama avec GGUF quantifié : 0 à 15 %, surtout en contexte long
- Décodage token par token, INT8/FP8/INT4, jeu vidéo, CUDA FP32 simple : aucun changement
C'est la dernière ligne qu'on oublie. Si votre charge est un décodage limité par la bande passante mémoire — ce qui est le cas de la plupart de l'inférence de chat sur une seule carte — vous ne gagnez rien. Le débridage achète du débit matriciel, pas de la bande passante. Quiconque fait tourner un modèle 4 bits avec un lot de taille un peut fermer l'onglet.
Là où ça paie, c'est le prefill, le fine-tuning et la diffusion. Un gain de 30 à 55 % en génération d'images change concrètement le nombre d'itérations qu'on peut s'offrir dans un après-midi, et cela ne coûte rien au mur à part de la chaleur.
Pourquoi « identique au bit près » est l'affirmation intéressante
Le README indique que les sorties sont identiques au bit près avant et après ; seule la vitesse change. Cette seule phrase sépare le projet de l'overclocking d'une manière qui compte, juridiquement et pratiquement.
L'overclocking modifie les résultats, peut corrompre de longs entraînements et annule la garantie d'une façon que les fabricants savent détecter. Retirer un limiteur de débit ne change pas l'arithmétique : les mêmes instructions s'exécutent dans le même ordre, simplement plus nombreuses par cycle. Si vous avez une exigence de reproductibilité, vous la conservez.
Cela signifie aussi que les seuls risques réels sont thermiques et électriques. La réponse du README est mesurée : le throttling standard et la gestion d'énergie restent intacts, la carte devrait donc réduire sa fréquence plutôt que griller. C'est plausible pour un bureau bien ventilé. Ce n'est évidemment pas une garantie sur laquelle parier une station de travail louée.
L'installer, et ce qui casse
Linux uniquement, et l'installation tient en trois étapes si votre distribution est Arch, Debian/Ubuntu ou Fedora :
git clone https://github.com/Zagitta/gpu-unlock
cd gpu-unlock
make install
Ajoutez ensuite gpu_unlock.targets=all à la ligne de commande du noyau — ou une liste d'adresses PCI séparées par des virgules si vous ne visez que certaines cartes — puis redémarrez. La vérification se fait avec journalctl -k -b | grep gpu_unlock.
Le support des cartes est l'endroit où le projet reconnaît ses limites. Ampere (RTX 30) est marqué stable, avec plus de cent retours d'utilisateurs. Ada (RTX 40) et Turing (RTX 20) sont expérimentaux. Blackwell (RTX 50) n'est pas pris en charge et, selon l'auteur, ne le sera probablement jamais.
Deux modes de défaillance valent la peine d'être connus avant d'essayer. Les portables perdent le débridage dès que le GPU dédié s'éteint, ce que beaucoup font au repos ; désactiver la gestion d'énergie à l'exécution aide sur certains modèles, pas sur d'autres. Et la mise en veille sur RAM réinitialise les sélecteurs, même si le module réapplique le débridage au réveil par défaut, au prix d'une seconde environ.
Windows n'existe que sous forme de portage tiers, que le README lie avec un « vos résultats peuvent varier ». Il prévient aussi, du ton plat de quelqu'un qui a vu la chose se produire, que des cryptomonnaies et des installateurs circulent sous le nom du projet, et qu'aucun n'est de lui.
La partie que personne ne veut écrire
La moitié du calcul IA des PC de joueurs de la planète se trouve derrière un interrupteur firmware qui existe pour protéger un palier de prix. Voilà la vraie découverte, et elle dépasse un dépôt.
Une fois qu'on le sait, d'autres choses changent d'aspect. Le prix des GPU cloud est fixé face à des cartes dont le limiteur est désactivé. Une 3090 d'occasion vaut discrètement plus que son prix affiché depuis deux ans. Et tout l'argument « il faut un GPU de datacenter pour faire de l'inférence sérieuse » s'assouplit un peu quand un module noyau récupère 65 % du débit tenseur sur une carte dix fois moins chère.
Il existe une objection légitime, et je vais la formuler : la segmentation est ce qui finance chez NVIDIA la pile logicielle qui rend ces cartes utilisables. CUDA ne s'est pas payé tout seul. Débrider une carte grand public n'est pas du vol, mais ce n'est pas gratuit non plus — le coût est porté par tous ceux qui achètent la version professionnelle.
C'est un débat sur l'équité, pas sur l'existence de l'interrupteur. Et les débats sur l'équité n'arrêtent généralement pas les gens qui ont une machine Linux de rechange et un fine-tuning à terminer pour vendredi.
Si vous voulez essayer
Faites-le sur une machine que vous pouvez vous permettre de réinstaller. Vérifiez d'abord la génération — c'est sur Ampere que les retours existent. Mesurez avant et après avec la charge que vous utilisez vraiment, pas avec un GEMM synthétique, parce que toute l'histoire tient à ceci : le gain dépend entièrement du fait que vous soyez limité par le calcul matriciel ou par la bande passante mémoire.
Et lisez la FAQ. L'auteur répond à « est-ce que cela abîme mon GPU » par un non argumenté, et à « pourquoi NVIDIA a-t-il fait ça » par une phrase plus utile que la plupart des livres blancs de fabricants.
Articles associés
Une feuille de calcul communautaire de clics pour couper les publicités des Android chinois
Il ne touche pas au système, ne déverrouille rien, ne flashe rien. Il bascule un à un les interrupteurs que les fabricants ont déjà prévus. Le prix à payer, c'est la liste qu'il faut continuer d'écrire.
GPT Image 2.6 a tenu le prix des tokens et fait monter la facture
GPT Image 2.6 reprend chaque tarif au token de 2.5 et coûte malgré tout plus cher par image, parce qu'une part plus grande du travail se paie en tokens de sortie. Onze jours après le lancement, la grille tarifaire dit plus que le classement.
Quelqu'un a reconstruit IDM de l'extérieur et a écrit ce qu'il n'a pas touché
Une réimplémentation en Rust d'Internet Download Manager revendique 5 fois la vitesse et 86 langues. Le document le plus intéressant est le paragraphe qui explique comment elle a été construite sans rien copier.
Rune est un framework UI Rust conçu pour qu'un agent puisse vérifier son propre travail
Rune rend en headless, vide son arbre d'éléments et accepte des entrées scriptées, ce qui donne à un agent de codage un signal différable qu'aucune capture d'écran ne fournit. Le framework est en préversion et n'accepte pas de pull requests.