
La tua GeForce fa girare l'AI a metà velocità, di proposito
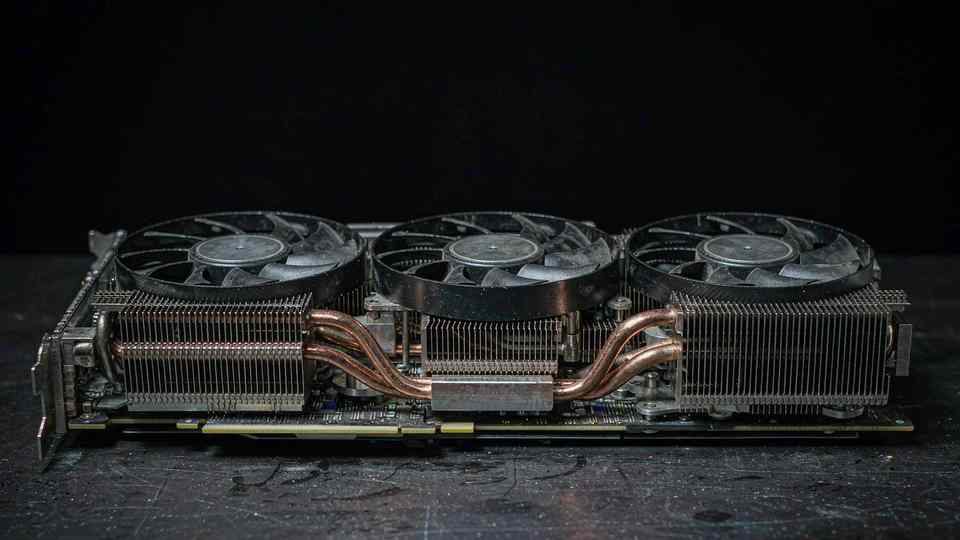
C'è un numero nel README di gpu-unlock che mi ha fatto posare la tazza: una RTX 4090 passa da 165 a 329 TFLOPS di matematica matriciale BF16. Non con l'overclock. Non con un VBIOS modificato. Scrivendo due valori nei selettori di velocità della scheda prima che il driver NVIDIA si carichi.
Il progetto è salito per tutto l'autunno nella classifica mensile di GitHub e sta intorno alle 17.700 stelle. È un modulo del kernel Linux, GPL-2.0, mantenuto da una persona sola che chiude il README chiedendo aiuto per comprare altre GPU.
Che cosa vende davvero NVIDIA
Le schede GeForce escono con i tensor core limitati a metà velocità per la matematica FP16, BF16 e TF32 con accumulo FP32. Non è un set di istruzioni di nicchia: è quello che usa quasi tutta l'inferenza non quantizzata e praticamente tutto il fine-tuning. Lo stesso silicio venduto come RTX A-series o come scheda da datacenter gira a piena velocità.
Non è un segreto. È segmentazione di mercato, e il README lo dice in una riga quando un utente chiede perché NVIDIA abbia handicappato la scheda: «vogliono che le aziende comprino le schede professionali senza queste limitazioni a prezzi molto più alti».
Lo sblocco non è una patch al driver né un flash del firmware. È un modulo che gira nell'initramfs, prima che nvidia agganci la scheda, scrive i selettori di velocità (SS0 0x88888888 seleziona la velocità BF16 piena, un SS1 a 4 bit 0x8 abilita IMLA4) ed esegue un reset a livello di funzione. La tecnica combina un approccio di sblocco già esistente con un timing accurato. Poiché nulla su disco viene modificato, un nuovo rilascio del driver NVIDIA non lo annulla.
I guadagni sono reali ma non uniformi
I numeri di copertina sono throughput su matrici dense, e sono grandi. Una RTX 3060 passa da 27 a 51 TFLOPS. Una 3090 da 75 a 125. Una 4090 raddoppia alla velocità di picco — con l'avvertenza, dichiarata apertamente, che la 4090 finisce la potenza prima dei tensor core, quindi i carichi reali guadagnano molto meno di quanto il picco suggerisca.
I carichi reali sono la parte interessante, perché la forbice è enorme:
- Prefill LLM / elaborazione del prompt (FP16, BF16, AWQ, GPTQ): +25–55%
- Tempo al primo token: 25–30% in meno
- LoRA e fine-tuning completo in BF16: +25–50%
- Generazione di immagini (SDXL, SD 1.5, modelli DiT in ComfyUI): +30–55%
- Generazione video con calcolo BF16 (Wan 2.2): +15–20%
- Kernel FlashAttention e SDPA: +50–60%
- llama.cpp / Ollama con GGUF quantizzato: 0–15%, soprattutto su contesti lunghi
- Decode token per token, INT8/FP8/INT4, gaming, CUDA FP32 puro: nessun cambiamento
L'ultima riga è quella che sfugge ai più. Se il tuo carico è decode limitato dalla banda di memoria — cioè la maggior parte dell'inferenza chat su una singola scheda — non ottieni niente. Lo sblocco compra throughput matriciale, non banda. Chi fa girare un modello a 4 bit con batch size uno può chiudere la scheda del browser.
Dove conviene è prefill, fine-tuning e diffusione. Un 30–55% di velocità in più sulla generazione di immagini cambia quanti tentativi puoi permetterti in un pomeriggio, e alla presa non costa nulla tranne calore.
Perché «bit-identical» è l'affermazione interessante
Il README afferma che gli output sono identici bit per bit prima e dopo; cambia solo la velocità. Quella singola frase separa tutto questo dall'overclock in un modo che conta, legalmente e praticamente.
L'overclock cambia i risultati, può corrompere run di training lunghe e invalida la garanzia in modi che i produttori sanno rilevare. Rimuovere un limitatore di velocità non cambia l'aritmetica: le stesse istruzioni vengono eseguite nello stesso ordine, solo più volte per ciclo. Se hai un requisito di riproducibilità, lo mantieni.
Significa anche che gli unici rischi reali sono termici ed elettrici. La risposta del README è calibrata: il throttling standard e la gestione della potenza restano intatti, quindi la scheda dovrebbe abbassare la frequenza invece di cuocersi. È plausibile per un desktop con buon flusso d'aria. Ovviamente non è una garanzia su cui puntare una workstation noleggiata.
Installarlo, e cosa si rompe
Solo Linux, e l'installazione è in tre passi se la tua distribuzione è Arch, Debian/Ubuntu o Fedora:
git clone https://github.com/Zagitta/gpu-unlock
cd gpu-unlock
make install
Poi aggiungi gpu_unlock.targets=all alla command line del kernel — o una lista di indirizzi PCI separati da virgole se vuoi solo schede specifiche — e riavvia. La verifica è journalctl -k -b | grep gpu_unlock.
Il supporto alle schede è il punto in cui il progetto è onesto sui propri limiti. Ampere (RTX 30) è marcata stabile, con oltre cento segnalazioni degli utenti. Ada (RTX 40) e Turing (RTX 20) sono sperimentali. Blackwell (RTX 50) non è supportata e, secondo l'autore, difficilmente lo sarà.
Due modalità di fallimento vale la pena conoscerle prima di provare. I portatili perdono lo sblocco ogni volta che la GPU discreta si spegne, cosa che molte fanno in idle; disattivare la gestione della potenza a runtime aiuta su alcuni modelli e non su altri. E la sospensione su RAM resetta i selettori, anche se il modulo riapplica lo sblocco al risveglio per default, aggiungendo circa un secondo.
Windows esiste solo come port di terze parti, linkato nel README con un «i risultati possono variare». Avverte anche, con il tono piatto di chi ha visto la cosa accadere, che in giro ci sono criptomonete e installer che usano il nome del progetto, e nessuno di loro è suo.
La parte che nessuno vuole scrivere
Metà del calcolo AI nei PC da gaming del mondo sta dietro un interruttore del firmware che esiste per proteggere una fascia di prezzo. È il vero risultato di questa storia, ed è più grande di un singolo repository.
Una volta che lo sai, altre cose sembrano diverse. Il prezzo delle GPU cloud è fissato su schede che hanno il limitatore spento. Una 3090 usata vale sottobanco più del suo prezzo di listino da due anni. E tutto l'argomento «serve una GPU da datacenter per l'inferenza seria» si ammorbidisce un po' quando un modulo del kernel recupera il 65% del throughput tensor su una scheda che costa un decimo.
C'è un'obiezione legittima, e la faccio io: la segmentazione è come NVIDIA finanzia lo stack software che rende utilizzabili queste schede. CUDA non si è pagata da sola. Sbloccare una scheda consumer non è rubare, ma non è nemmeno gratis: il costo lo porta chi compra la parte professionale.
È un argomento sulla correttezza, non sull'esistenza dell'interruttore. E gli argomenti sulla correttezza di solito non fermano chi ha un box Linux libero e un fine-tuning da finire per venerdì.
Se vuoi provarci
Fallo su una macchina che puoi permetterti di reinstallare. Controlla prima la generazione: Ampere è dove stanno le segnalazioni. Misura prima e dopo con il carico che usi davvero, non con un GEMM sintetico, perché tutta la storia qui è che il guadagno dipende interamente dal fatto che tu sia limitato dalla matematica matriciale o dalla banda di memoria.
E leggi le FAQ. L'autore risponde alla domanda «questo danneggia la mia GPU» con un no ragionato, e alla domanda «perché NVIDIA l'ha fatto» con una risposta di una frase più utile della maggior parte dei white paper dei vendor.
Articoli correlati
Il consiglio si è costruito un comitato sull'export
In nove giorni il consiglio di Nvidia ha prodotto un'indagine, una presidenza e un comitato sull'export. Solo la trimestrale è finita in prima pagina.
Nvidia non ha mai costruito una seconda fila
Il problema di Nvidia non è lo scandalo, è la struttura: nessun presidente del consiglio fino alla settimana scorsa, nessun vice con mandato aziendale, nessuna successione.
Nvidia ha messo un prezzo al suo fondatore
In nove giorni Nvidia ha cambiato CEO e consiglio senza perdere un trimestre. Il mercato, intanto, ha dato un prezzo a quello che valeva un solo uomo.
Un foglio di calcolo comunitario di tocchi che spegne la pubblicità negli Android cinesi
Non tocca il sistema, non sblocca niente, non flasha niente. Ribalta solo gli interruttori che i produttori hanno già previsto. Il prezzo è una lista che qualcuno deve continuare a scrivere.