
Die GeForce läuft absichtlich mit halber KI-Geschwindigkeit
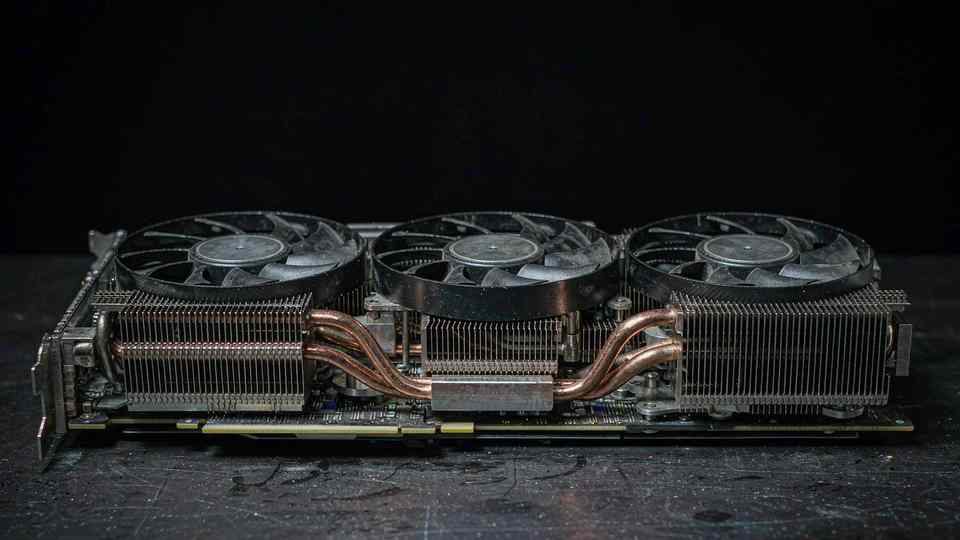
Im README von gpu-unlock steht eine Zahl, wegen der ich die Kaffeetasse abgesetzt habe: Eine RTX 4090 geht bei BF16-Matrixmathematik von 165 auf 329 TFLOPS. Nicht durch Übertakten. Nicht durch ein gepatchtes VBIOS. Sondern indem zwei Werte in die Speed-Selector der Karte geschrieben werden, bevor der NVIDIA-Treiber lädt.
Das Projekt klettert den ganzen Herbst über die GitHub-Trendliste und steht bei rund 17.700 Sternen. Es ist ein Linux-Kernelmodul, GPL-2.0, gepflegt von einer Person, die das README mit der Bitte unterzeichnet, ihr beim Kauf weiterer GPUs zu helfen.
Was NVIDIA tatsächlich ausliefert
GeForce-Karten kommen mit Tensor Cores, die für FP16-, BF16- und TF32-Mathematik mit FP32-Akkumulation auf halbe Rate gedeckelt sind. Das ist keine Nischen-Instruktion – es ist das, was fast jede unquantisierte Inferenz und praktisch jedes Fine-Tuning nutzt. Dieselbe Siliziumbasis läuft als RTX A-Serie oder als Datacenter-Teil mit voller Rate.
Das ist kein Geheimnis. Es ist Marktsegmentierung, und das README sagt es in einem Satz, als ein Nutzer fragt, warum NVIDIA die Karte kastriert hat: „Sie wollen, dass Firmen die professionellen Karten ohne diese Einschränkungen zu deutlich höheren Preisen kaufen.“
Das Unlock ist kein Treiber-Patch und kein Firmware-Flash. Es ist ein Modul, das in der Initramfs läuft, bevor nvidia die Karte bindet, die Speed-Selector schreibt (SS0 0x88888888 wählt die volle BF16-Rate, ein 4-Bit-SS1 0x8 aktiviert IMLA4) und einen funktionsbezogenen Reset ausführt. Die Technik kombiniert einen bestehenden Unlock-Ansatz mit sorgfältigem Timing. Weil auf der Platte nichts verändert wird, macht ein neuer NVIDIA-Treiber das Ganze nicht rückgängig.
Die Gewinne sind echt, aber nicht gleichmäßig
Die Schlagzeilenzahlen betreffen Dense-Matrix-Durchsatz, und sie sind groß. Eine RTX 3060 geht von 27 auf 51 TFLOPS. Eine 3090 von 75 auf 125. Eine 4090 verdoppelt sich auf dem Spitzenwert – mit dem ausdrücklichen Hinweis, dass der 4090 die Leistungsaufnahme ausgeht, bevor die Tensor Cores ausgehen, weshalb echte Workloads deutlich weniger gewinnen, als der Spitzenwert suggeriert.
Bei echten Workloads wird es interessant, weil die Streuung enorm ist:
- LLM-Prefill / Prompt-Verarbeitung (FP16, BF16, AWQ, GPTQ): +25–55 %
- Time to First Token: 25–30 % niedriger
- LoRA und volles Fine-Tuning in BF16: +25–50 %
- Bildgenerierung (SDXL, SD 1.5, DiT-Modelle in ComfyUI): +30–55 %
- Videogenerierung mit BF16-Compute (Wan 2.2): +15–20 %
- FlashAttention- und SDPA-Kernel: +50–60 %
- llama.cpp / Ollama mit quantisiertem GGUF: 0–15 %, überwiegend bei langem Kontext
- Token-für-Token-Decode, INT8/FP8/INT4, Gaming, reines FP32-CUDA: keine Veränderung
Die letzte Zeile wird gern übersehen. Wer einen Workload hat, der bandbreitenbegrenzt dekodiert – also die meiste Chat-Inferenz auf einer einzelnen Karte –, gewinnt nichts. Das Unlock kauft Matrizedurchsatz, keine Bandbreite. Wer ein 4-Bit-Modell mit Batch-Größe eins laufen lässt, kann den Tab schließen.
Es zahlt sich bei Prefill, Fine-Tuning und Diffusion aus. 30 bis 55 Prozent mehr Tempo bei der Bildgenerierung verändern, wie viele Iterationen man sich an einem Nachmittag leisten kann, und an der Steckdose kostet es nichts außer Wärme.
Warum „bit-identisch“ die interessante Behauptung ist
Das README hält fest, dass die Ausgaben vorher und nachher bit-identisch sind; nur die Geschwindigkeit ändert sich. Dieser eine Satz trennt das Verfahren vom Übertakten, und zwar juristisch wie praktisch relevant.
Übertakten verändert Ergebnisse, kann lange Trainingsläufe beschädigen und führt zu Garantieverlust, den Hersteller erkennen können. Einen Ratenbegrenzer zu entfernen ändert die Arithmetik nicht – dieselben Instruktionen laufen in derselben Reihenfolge, nur mehr davon pro Takt. Wer Reproduzierbarkeit braucht, behält sie.
Es heißt auch, dass die einzigen echten Risiken thermisch und elektrisch sind. Die Antwort im README ist abgewogen: Standard-Throttling und Power-Management bleiben intakt, die Karte sollte also heruntertakten statt zu kochen. Für einen Desktop mit Luftstrom ist das plausibel. Es ist, natürlich, keine Garantie, auf die man eine gemietete Workstation verwetten sollte.
Installation und was kaputtgeht
Nur Linux, und die Installation sind drei Schritte, wenn die Distribution Arch, Debian/Ubuntu oder Fedora ist:
git clone https://github.com/Zagitta/gpu-unlock
cd gpu-unlock
make install
Dann gpu_unlock.targets=all an die Kernel-Kommandozeile anhängen – oder eine kommagetrennte Liste von PCI-Adressen, wenn nur bestimmte Karten gemeint sind – und neu starten. Die Prüfung läuft über journalctl -k -b | grep gpu_unlock.
Bei der Kartenunterstützung ist das Projekt ehrlich über die eigenen Grenzen. Ampere (RTX 30) gilt mit über hundert Nutzerberichten als stabil. Ada (RTX 40) und Turing (RTX 20) sind experimentell. Blackwell (RTX 50) wird nicht unterstützt und kommt laut Autor wahrscheinlich auch nicht.
Zwei Fehlerbilder sollte man kennen, bevor man es versucht. Bei Laptops geht das Unlock verloren, sobald die diskrete GPU abschaltet, was viele im Leerlauf tun; Runtime-Power-Management abzuschalten hilft bei manchen Modellen, bei anderen nicht. Und Suspend-to-RAM setzt die Selector zurück, wobei das Modul das Unlock beim Aufwachen standardmäßig neu anwendet – das kostet etwa eine Sekunde.
Windows existiert nur als Fremd-Port, auf den das README mit einem „your mileage may vary“ verlinkt. Es warnt außerdem, im nüchternen Ton von jemandem, der das schon beobachtet hat, dass Kryptomünzen und Installer unter dem Projektnamen kursieren – und keiner davon von ihm stammt.
Der Teil, den niemand schreiben will
Die Hälfte der KI-Rechenleistung in den Gaming-PCs dieser Welt sitzt hinter einem Firmware-Schalter, der eine Preisklasse schützt. Das ist der eigentliche Befund, und er ist größer als ein Repo.
Wenn man das einmal weiß, sehen andere Dinge anders aus. Cloud-GPU-Preise werden gegen Karten gesetzt, bei denen der Begrenzer aus ist. Eine gebrauchte 3090 ist seit zwei Jahren still mehr wert als ihr Listenpreis. Und das ganze Argument „für ernsthafte Inferenz braucht man eine Datacenter-GPU“ wird weicher, wenn ein Kernelmodul 65 Prozent des Tensor-Durchsatzes auf einer Karte zurückholt, die ein Zehntel kostet.
Es gibt ein legitimes Gegenargument, und ich mache es: Segmentierung ist der Weg, über den NVIDIA den Software-Stack finanziert, der diese Karten überhaupt nutzbar macht. CUDA hat sich nicht selbst bezahlt. Eine Consumer-Karte freizuschalten ist kein Diebstahl, aber auch nicht kostenlos – die Kosten tragen alle, die das professionelle Teil kaufen.
Das ist ein Argument über Fairness, nicht darüber, ob der Schalter existiert. Und Fairness-Argumente halten selten jemanden auf, der eine übrige Linux-Kiste und einen Fine-Tuning-Job hat, der bis Freitag fertig sein muss.
Wer es versuchen will
Auf einer Maschine, die man notfalls neu installieren kann. Zuerst die eigene Generation prüfen – Ampere ist die, für die Berichte vorliegen. Vorher und nachher mit dem Workload benchmarken, den man tatsächlich fährt, nicht mit einem synthetischen GEMM, denn die ganze Geschichte hängt davon ab, ob Matrixmathematik oder Speicherbandbreite der Engpass ist.
Und die FAQ lesen. Der Autor beantwortet „schadet das meiner GPU“ mit einem begründeten Nein und „warum hat NVIDIA das getan“ mit einem Satz, der nützlicher ist als die meisten Hersteller-Whitepaper.
Verwandte Artikel
Eine community-gepflegte Tabelle von Taps, die Werbung in chinesischen Android-Builds abschaltet
Es fasst das System nicht an, entsperrt nichts, flasht nichts. Es legt nur die Schalter um, die die Hersteller ohnehin vorgesehen haben. Der Preis ist eine Liste, die jemand weiterführen muss.
GPT Image 2.6 hielt den Tokenpreis und erhöhte die Rechnung
GPT Image 2.6 übernimmt jeden Tokenpreis von 2.5 und kostet pro Bild dennoch mehr, weil ein größerer Teil der Arbeit in Ausgabe-Token landet. Elf Tage nach dem Start sagt die Preisstruktur mehr als jede Rangliste.
Jemand hat IDM von außen nachgebaut und aufgeschrieben, was er nicht angefasst hat
Eine Rust-Neuimplementierung von Internet Download Manager verspricht 5x Tempo und 86 Sprachen. Das interessantere Dokument ist der Absatz, der erklärt, wie sie ohne jede Kopie entstanden ist.
Rune ist ein Rust-UI-Framework, das gebaut wurde, damit ein Agent seine eigene Arbeit prüfen kann
Rune rendert headless, gibt seinen Elementbaum aus und nimmt geskriptete Eingaben an. Damit bekommt ein Coding-Agent ein Signal zum Diffen, das ein Screenshot nie liefert. Das Framework ist Pre-Release und nimmt keine Pull Requests an.