
A tira de três quadros é o primeiro formato de IA com estilo próprio
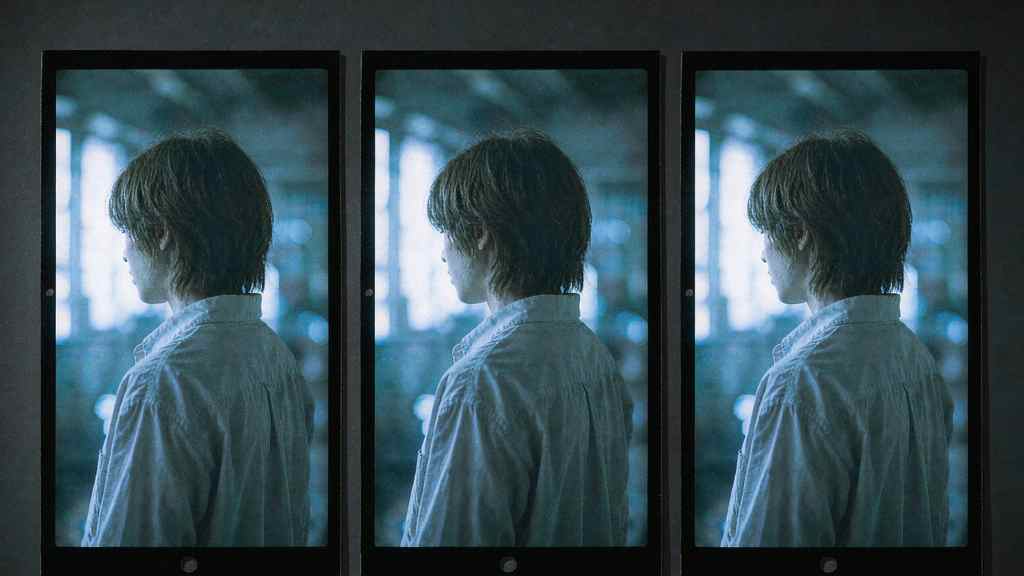
Se você passar uma noite no Douyin ou no Xiaohongshu, vai ver o mesmo layout de imagem se repetindo: três quadros verticais lado a lado, uma pessoa em cada um, tom frio, levemente superexposto, granulação de filme e uma linha de texto bilíngue gravada na base do quadro.
Os criadores chineses chamam isso de 电影感三宫格 — o tríptico cinematográfico. O prompt que produz o efeito costuma circular como um bloco de texto, e o bloco é notavelmente específico. Envie uma foto. Peça três quadros da mesma cena. Quadro um: close-up por trás, meio corpo, vento no cabelo, legenda 山的后面是什么? / What's beyond the mountain? Quadro dois: plano médio, de lado, segurando flores, olhando para baixo, legenda 你不用告诉我 / You don't have to tell me. Quadro três: plano aberto, a figura pequena contra o céu. Paleta fria, filme Fuji, altas luzes estouradas, grão grosso, sombras ainda com detalhe, luz suave e difusa, sem arestas duras, legendas centralizadas na base, componha os três num único quadro em 2:3.
Parece um ensaio fotográfico. É um template, e o template é o objeto interessante.
Por que três, e por que vertical
Três quadros é o menor número capaz de contar uma história sem virar sequência. Dois soam como antes e depois. Quatro soam como grade, e grade se lê como folha de contato — evidência, não emoção. Três se leem como tira de filme: um momento de estabelecimento, uma virada, um desfecho.
O vertical é uma restrição de plataforma que virou estética. Um quadro 9:16 é o que o celular oferece, então três deles lado a lado num canvas 2:3 produzem uma imagem larga feita de janelas altas. É a forma de uma tela de cinema cortada em três telas de celular, que é exatamente a piada visual que faz funcionar: gramática de cinema, entregue no formato que o feed já premia.
E depois vem a parte prática que ninguém diz em voz alta. Uma imagem de três painéis é um objeto deslizável. Dá para publicar como uma imagem que se lê no tamanho da miniatura, cortar em três posts, ou usar como capa mais duas fotos de detalhe. Uma geração, vários lugares.
O texto é que faz o trabalho emocional
A legenda bilíngue gravada no quadro é a parte que a maioria dos imitadores erra. Copiam a composição e pulam a tipografia, e o resultado parece foto de banco de imagens com uma frase colada em cima.
O que faz o formato funcionar é que as palavras são curtas, levemente melancólicas e traduzidas. Chinês em cima, inglês embaixo, mesmo peso, centralizado na base. A tradução não está ali para um público internacional. Está ali porque duas linhas de texto em dois idiomas se leem como fotograma de filme, enquanto uma linha se lê como meme. A segunda língua é textura, não mensagem.
É também por isso que o formato resiste a ser transportado para outros mercados. Troque os idiomas e vira exercício de legenda. Mantenha o par e ele parece um post chinês, porque é. A estética não é universal; é uma solução específica para um feed específico.
Consistência é o problema técnico de verdade
Repare no que o prompt está realmente pedindo. O mesmo rosto em três quadros, em três distâncias focais. A mesma camisa. A mesma direção de luz, apesar de a câmera ter se deslocado noventa graus. Cabelo que pareça ao vento nos três. E texto pequeno legível na base de cada quadro, sem cobrir o sujeito.
Cada um desses itens é um ponto fraco conhecido. Desvio de identidade entre gerações é o problema que sistemas de múltiplas referências existem para resolver, e a safra de modelos de imagem de 2026 melhorou muito nisso — o Seedream 5.5 promete preservação em nível de pixel de regiões não editadas ao longo de cem edições, que é o mesmo problema dito de outra forma. Mas «mesmo rosto, outro ângulo, mesma camisa, três vezes, numa composição só» continua sendo mais difícil do que parece, e o modo de falha é óbvio para qualquer espectador: um quadro em que a pessoa é levemente outra pessoa, e tudo desmorona.
Texto pequeno é a outra falha. Caracteres chineses do tamanho de legenda na base de um quadro vertical comprimido chegam perto do pior caso para modelos de imagem: traços densos, resolução baixa, contraste alto contra um fundo ocupado. Os lançamentos deste outono que se gabam de taxas de corrupção de caracteres estão, digam ou não, competindo exatamente por este caso de uso.
A economia do template
Esta é a terceira onda do mesmo padrão. Primeiro um prompt circula. Depois um template o transforma em um toque. Depois as ferramentas de edição da própria plataforma absorvem aquilo, e o template vira infraestrutura invisível.
O efeito de câmera lenta da «entrada do chefe» no Douyin seguiu esse caminho, assim como os templates de dança do CapCut que transformam uma foto num clipe de doze segundos e já foram usados dezenas de milhares de vezes. O tríptico ainda está no começo do ciclo — em boa parte movido a prompt, copiado de post em post, com as versões boas se distinguindo pelo gosto, não pela ferramenta.
A pergunta interessante é o que acontece quando ele for transformado em produto. Um template que garante três quadros consistentes a partir de um único envio eliminaria a única parte que hoje exige habilidade. O que sobra é elenco, figurino e as duas linhas de texto. É uma superfície criativa bem menor, e é também exatamente onde a atenção do público de fato vai.
O indício é aquilo que as pessoas pararam de pedir
Seis meses atrás, os prompts que circulavam nessas plataformas eram sobre objetos: um gato de terno, uma cidade de vidro, uma pessoa feita de fumaça. O prompt de três painéis é sobre encenação. Ele especifica distância de câmera, orientação do corpo, de onde vem a luz, onde fica o texto e o que a pessoa está sentindo em cada quadro.
Isso é uma mudança de letramento, não de modelo. Quem está obtendo bons resultados é quem aprendeu a escrever como diretor, não como cliente. São também os que menos reclamam da ferramenta, porque pararam de esperar que ela adivinhe.
O que isso diz sobre o mercado
A cobertura ocidental de imagem com IA é obcecada pela imagem-herói única: o pôster, a foto de produto, o keyframe. As plataformas chinesas foram para o outro lado, na direção de layouts com múltiplos quadros que se comportam como uma publicação — três painéis, uma grade, uma tira de stills com legendas.
É uma diferença de distribuição, não de gosto. Um feed construído sobre deslizar e salvar recompensa objetos que sobrevivem a recorte e repetição. Uma composição de três painéis são quatro ativos num único arquivo. Ela é otimizada para o lugar onde vai ser vista, que é a regra mais antiga do design editorial e a que as ferramentas de IA passaram dois anos ignorando.
Se você quiser experimentar, o conselho honesto é começar pela sua própria foto, manter o texto curto e contar com cinco ou seis gerações antes que os três quadros concordem sobre quem é a pessoa. O prompt não é a parte difícil. A parte difícil é o segundo quadro, onde o modelo precisa lembrar de um rosto que só consegue ver de costas.
Artigos relacionados
Uma planilha comunitária de toques que desliga os anúncios dos Android chineses
Não mexe no sistema, não desbloqueia nada, não faz flash de nada. Só vira os botões que os fabricantes já deixaram à mostra. O preço é uma lista que alguém precisa continuar escrevendo.
GPT Image 2.6 manteve o preço por token e elevou a fatura
O GPT Image 2.6 mantém cada tarifa por token do 2.5 e mesmo assim custa mais por imagem, porque boa parte do trabalho acontece agora nos tokens de saída. Onze dias após o lançamento, a estrutura de preços diz mais que o ranking.
Alguém reconstruiu o IDM por fora e anotou o que não tocou
Uma reimplementação em Rust do Internet Download Manager promete 5 vezes a velocidade e 86 idiomas. O documento mais interessante é o parágrafo que explica como ela foi feita sem copiar nada.
Rune é um framework de UI em Rust feito para que um agente possa verificar o próprio trabalho
Rune renderiza sem interface, despeja sua árvore de elementos e aceita entrada roteirizada, o que dá a um agente de código um sinal diffável que um screenshot nunca oferece. O framework está em pré-lançamento e não aceita pull requests.