
Der dreiteilige Filmstreifen ist das erste KI-Format mit eigenem Stil
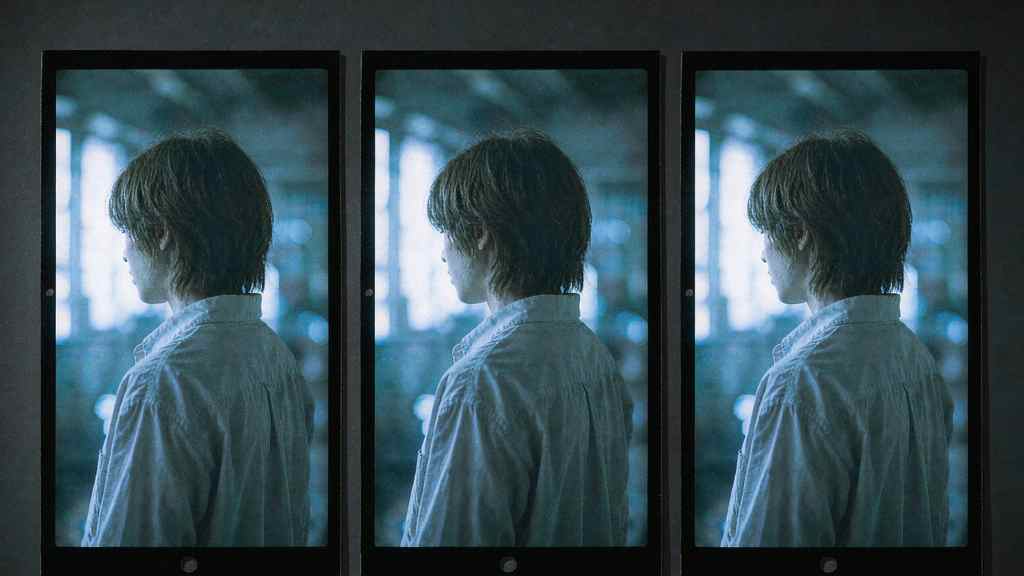
Wer einen Abend auf Douyin oder Xiaohongshu verbringt, sieht dieselbe Anordnung immer wieder: drei hochformatige Rahmen nebeneinander, in jedem eine Person, kühle Farben, leicht überbelichtet, Filmkorn, und unten im Bild eine Zeile zweisprachigen Text, fest eingebrannt.
Chinesische Creator nennen es 电影感三宫格 – das filmische Dreifeld. Der Prompt, der es erzeugt, wird meist als Textblock weitergegeben, und der Block ist bemerkenswert konkret. Ein Foto hochladen. Drei Frames aus derselben Szene verlangen. Frame eins: Nahaufnahme von hinten, Oberkörper, Wind im Haar, Untertitel 山的后面是什么? / What's beyond the mountain? Frame zwei: Halbtotale von der Seite, Blumen im Arm, Blick gesenkt, Untertitel 你不用告诉我 / You don't have to tell me. Frame drei: weit, die Figur klein gegen den Himmel. Kühle Palette, Fuji-Filmmaterial, ausgefressene Lichter, grobes Korn, Schatten noch durchgezeichnet, weiches diffuses Licht, keine harten Kanten, Untertitel unten mittig, die drei zu einem Bild im Format 2:3 zusammensetzen.
Es sieht aus wie ein Fotoshooting. Es ist eine Vorlage, und die Vorlage ist das interessante Objekt.
Warum drei, und warum hochkant
Drei Frames sind die kleinste Zahl, mit der sich eine Geschichte erzählen lässt, ohne eine Sequenz zu sein. Zwei wirkt wie Vorher und Nachher, und Vorher-Nachher ist ein Vergleich, keine Erzählung. Vier wirkt wie ein Raster, und ein Raster liest sich als Kontaktabzug – Beweis, nicht Gefühl. Drei liest sich als Filmstreifen: ein etablierender Moment, eine Wendung, eine Auflösung.
Hochkant ist eine Plattformbeschränkung, die zur Ästhetik wurde. Ein 9:16-Rahmen ist das, was das Telefon hergibt; drei davon nebeneinander auf einer 2:3-Fläche ergeben ein breites Bild aus hohen Fenstern. Es ist die Form einer Kinoleinwand, zerschnitten in drei Telefonbildschirme – und genau das ist der visuelle Witz, der funktioniert: Filmgrammatik, geliefert in dem Format, das der Feed ohnehin belohnt.
Und dann ist da der praktische Teil, den niemand laut sagt. Ein dreiteiliges Bild ist ein wischbares Objekt. Man kann es als ein Bild posten, das in Miniaturgröße lesbar bleibt, oder in drei Posts zuschneiden, oder als Titelbild plus zwei Detailaufnahmen verwenden. Eine Generierung, mehrere Platzierungen, ohne dass jemand nachschneiden muss.
Der Text leistet die emotionale Arbeit
Der eingebrannte zweisprachige Untertitel ist der Teil, den die meisten Nachahmer falsch machen. Sie kopieren die Komposition und lassen die Typografie weg, und das Ergebnis sieht aus wie ein Stockfoto mit aufgeklebter Bildunterschrift.
Was das Format funktionieren lässt, ist, dass die Worte kurz sind, leicht melancholisch und übersetzt. Chinesisch oben, Englisch darunter, gleiches Gewicht, unten mittig. Die Übersetzung ist nicht für ein internationales Publikum da. Sie ist da, weil zwei Textzeilen in zwei Sprachen wie ein Filmstill lesen, während eine Zeile wie ein Meme liest. Die zweite Sprache ist Textur, keine Botschaft.
Deshalb lässt sich das Format auch schlecht in andere Märkte übertragen. Tauscht man die Sprachen, wird daraus eine Untertitelübung. Behält man die Paarung, sieht es wie ein chinesischer Post aus, weil es einer ist. Die Ästhetik ist nicht universell; sie ist eine spezifische Lösung für einen spezifischen Feed.
Konsistenz ist das eigentliche technische Problem
Schauen wir, was der Prompt wirklich verlangt. Dasselbe Gesicht in drei Frames, bei drei Brennweiten. Dasselbe Hemd. Dieselbe Lichtrichtung, obwohl die Kamera sich um neunzig Grad bewegt hat. Haare, die in allen drei Bildern windzerzaust wirken. Und lesbarer kleiner Text am unteren Rand jedes Frames, ohne das Motiv zu verdecken.
Jeder dieser Punkte ist eine bekannte Schwachstelle. Identitätsdrift über Generationen hinweg ist genau das, wofür Mehrfachreferenz-Systeme existieren, und die Bildmodelle des Jahrgangs 2026 sind darin deutlich besser geworden – Seedream 5.5 behauptet pixelgenaue Erhaltung unveränderter Bereiche über hundert Bearbeitungen, was dasselbe Problem anders formuliert ist. Aber „dasselbe Gesicht, anderer Winkel, dasselbe Hemd, dreimal, in einem Composite“ ist weiterhin schwieriger, als es aussieht, und der Fehlerfall ist für jeden Betrachter offensichtlich: ein Frame, in dem die Person leicht jemand anderes ist, und das Ganze kippt.
Kleine Schrift ist der andere Fehlerfall. Chinesische Schriftzeichen in Untertitelgröße am unteren Rand eines komprimierten Hochformat-Frames sind nahe am Worst Case für Bildmodelle: dichte Striche, niedrige Auflösung, hoher Kontrast gegen einen unruhigen Hintergrund. Die Veröffentlichungen dieses Herbstes, die mit ihren Fehlerraten bei Schriftzeichen prahlen, konkurrieren – ob sie es sagen oder nicht – genau um diesen Anwendungsfall.
Die Vorlagenökonomie
Das ist die dritte Welle desselben Musters. Erst zirkuliert ein Prompt. Dann macht eine Vorlage daraus einen Tipp. Dann absorbieren die Bordwerkzeuge der Plattform das Ganze, und die Vorlage wird unsichtbare Infrastruktur.
Douyins Zeitlupen-Effekt „Auftritt des Bosses“ ist diesen Weg gegangen, ebenso die CapCut-Tanzvorlagen, die aus einem Foto einen zwölfsekündigen Clip machen und zehntausendfach verwendet wurden. Der dreiteilige Still ist früher im Zyklus – überwiegend promptgetrieben, von Post zu Post kopiert, wobei sich die guten Versionen durch Geschmack unterscheiden und nicht durch Werkzeuge.
Die interessante Frage ist, was passiert, wenn es produktisiert wird. Eine Vorlage, die drei konsistente Frames aus einem Upload garantiert, würde den einzigen Teil entfernen, der derzeit Können verlangt. Übrig bleiben Casting, Garderobe und die zwei Textzeilen. Das ist eine viel kleinere kreative Fläche – und genau dorthin geht die Aufmerksamkeit des Publikums tatsächlich.
Der Hinweis liegt darin, wofür niemand mehr promptet
Vor einem halben Jahr drehten sich die Prompts, die auf diesen Plattformen zirkulierten, um Objekte: eine Katze im Anzug, eine Stadt aus Glas, eine Person aus Rauch. Der Drei-Felder-Prompt handelt von Inszenierung. Er legt die Kameradistanz fest, die Körperausrichtung, woher das Licht kommt, wo der Text sitzt und was die Person in jedem Frame fühlt.
Das ist eine Verschiebung der Kompetenz, nicht der Modelle. Die Leute, die gute Ergebnisse bekommen, haben gelernt, wie ein Regisseur zu schreiben statt wie ein Kunde. Sie sind auch die, die sich am wenigsten über das Werkzeug beschweren, weil sie aufgehört haben zu erwarten, dass es rät.
Was das über den Markt sagt
Die westliche Berichterstattung über KI-Bilder ist besessen vom einzelnen Heldenbild: das Poster, die Produktaufnahme, das Keyframe. Chinesische Plattformen gingen den anderen Weg, hin zu mehrteiligen Layouts, die sich wie eine Publikation verhalten – drei Felder, ein Raster, ein Streifen Stills mit Untertiteln.
Das ist ein Unterschied der Distribution, nicht des Geschmacks. Ein Feed, der auf Wischen und Speichern gebaut ist, belohnt Objekte, die Zuschnitt und Wiederholung überleben. Ein dreiteiliges Composite sind vier Assets in einer Datei. Es ist für den Ort optimiert, an dem es gesehen wird – die älteste Regel im Editorial Design und die, die KI-Werkzeuge zwei Jahre lang ignoriert haben.
Wer es ausprobieren will, dem sei ehrlich geraten: mit einem eigenen Foto anfangen, den Text kurz halten und damit rechnen, fünf- oder sechsmal zu generieren, bis alle drei Frames sich einig sind, wer die Person ist. Der Prompt ist nicht der schwierige Teil. Schwierig ist der zweite Frame, in dem das Modell sich an ein Gesicht erinnern muss, das es nur von hinten sieht.
Verwandte Artikel
Eine community-gepflegte Tabelle von Taps, die Werbung in chinesischen Android-Builds abschaltet
Es fasst das System nicht an, entsperrt nichts, flasht nichts. Es legt nur die Schalter um, die die Hersteller ohnehin vorgesehen haben. Der Preis ist eine Liste, die jemand weiterführen muss.
GPT Image 2.6 hielt den Tokenpreis und erhöhte die Rechnung
GPT Image 2.6 übernimmt jeden Tokenpreis von 2.5 und kostet pro Bild dennoch mehr, weil ein größerer Teil der Arbeit in Ausgabe-Token landet. Elf Tage nach dem Start sagt die Preisstruktur mehr als jede Rangliste.
Jemand hat IDM von außen nachgebaut und aufgeschrieben, was er nicht angefasst hat
Eine Rust-Neuimplementierung von Internet Download Manager verspricht 5x Tempo und 86 Sprachen. Das interessantere Dokument ist der Absatz, der erklärt, wie sie ohne jede Kopie entstanden ist.
Rune ist ein Rust-UI-Framework, das gebaut wurde, damit ein Agent seine eigene Arbeit prüfen kann
Rune rendert headless, gibt seinen Elementbaum aus und nimmt geskriptete Eingaben an. Damit bekommt ein Coding-Agent ein Signal zum Diffen, das ein Screenshot nie liefert. Das Framework ist Pre-Release und nimmt keine Pull Requests an.