
Le triptyque vertical est le premier format d'IA doté d'un style maison
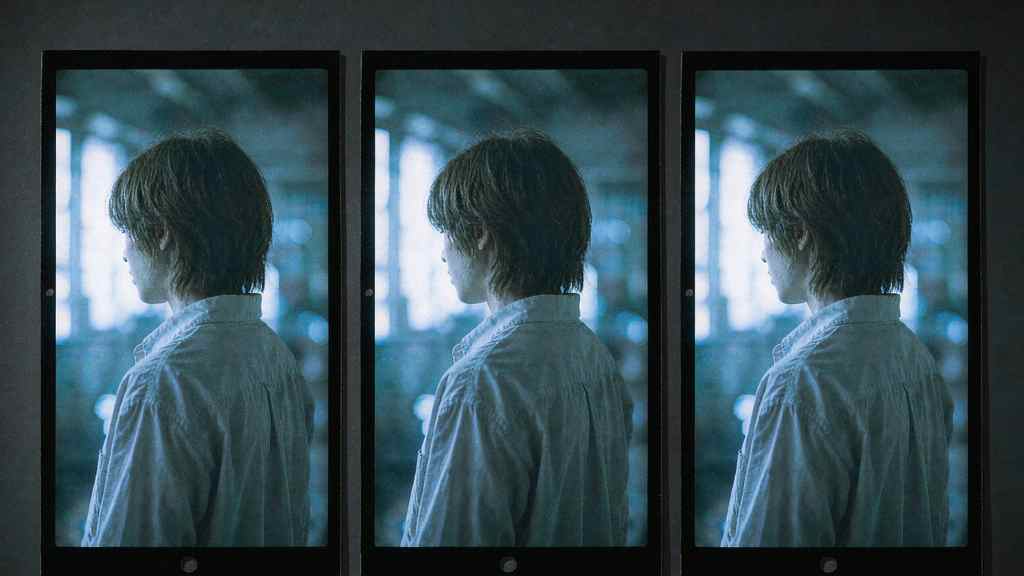
Si vous passez une soirée sur Douyin ou Xiaohongshu, vous verrez la même mise en page revenir en boucle : trois cadres verticaux côte à côte, une personne dans chacun, tons froids, légèrement surexposés, grain de film, et une ligne de texte bilingue incrustée en bas du cadre.
Les créateurs chinois appellent ça 电影感三宫格 — le triptyque cinématographique. Le prompt qui le produit circule en général sous forme de bloc de texte, et le bloc est remarquablement précis. Téléversez une photo. Demandez trois cadres de la même scène. Cadre un : gros plan de dos, buste, vent dans les cheveux, sous-titre 山的后面是什么? / What's beyond the mountain? Cadre deux : plan moyen, de profil, tenant des fleurs, regard baissé, sous-titre 你不用告诉我 / You don't have to tell me. Cadre trois : plan large, silhouette minuscule contre le ciel. Palette froide, pellicule Fuji, hautes lumières brûlées, grain grossier, ombres encore détaillées, lumière douce et diffuse, pas de bords nets, sous-titres en bas au centre, composez les trois en une image en 2:3.
Ça ressemble à une séance photo. C'est un gabarit, et le gabarit est l'objet intéressant.
Pourquoi trois, et pourquoi vertical
Trois cadres, c'est le plus petit nombre capable de raconter une histoire sans être une séquence. Deux ressemble à un avant-après. Quatre ressemble à une grille, et une grille se lit comme une planche-contact — une preuve, pas une émotion. Trois se lit comme une bande de film : un moment d'installation, un basculement, un relâchement.
Le vertical est une contrainte de plateforme devenue une esthétique. Un cadre 9:16, c'est ce que le téléphone donne, donc trois côte à côte dans un canevas 2:3 produisent une image large faite de fenêtres hautes. C'est la forme d'un écran de cinéma découpé en trois écrans de téléphone, et c'est précisément la blague visuelle qui fait marcher l'ensemble : une grammaire de film, livrée dans le format que le feed récompense déjà.
Et puis il y a la partie pratique que personne ne dit tout haut. Une image en trois panneaux est un objet que l'on fait glisser. On peut la publier comme une seule image lisible en vignette, ou la découper en trois posts, ou l'utiliser comme couverture plus deux détails. Une génération, plusieurs placements.
Le texte fait le travail émotionnel
Le sous-titre bilingue incrusté est la partie que la plupart des imitateurs ratent. Ils copient la composition et sautent la typographie, et le résultat ressemble à une photo de banque d'images avec une légende collée dessus.
Ce qui fait marcher le format, c'est que les mots sont courts, légèrement mélancoliques, et traduits. Chinois au-dessus, anglais en dessous, même graisse, en bas au centre. La traduction n'est pas là pour un public international. Elle est là parce que deux lignes de texte en deux langues se lisent comme une image de film, alors qu'une seule ligne se lit comme un meme. La seconde langue est une texture, pas un message.
C'est aussi pourquoi le format résiste à l'export vers d'autres marchés. Changez les langues et cela devient un exercice de sous-titrage. Gardez la paire et cela ressemble à un post chinois, parce que c'en est un. L'esthétique n'est pas universelle ; c'est une solution précise à un feed précis.
La cohérence est le vrai problème technique
Regardez ce que le prompt demande réellement. Le même visage dans trois cadres, à trois focales. La même chemise. La même direction de lumière, alors que la caméra a tourné de quatre-vingt-dix degrés. Des cheveux qui se lisent comme balayés par le vent dans les trois. Et un petit texte lisible placé en bas de chaque cadre sans couvrir le sujet.
Chacun de ces points est un point faible connu. La dérive d'identité d'une génération à l'autre est exactement ce que les systèmes multi-références existent pour résoudre, et la génération 2026 de modèles d'image y est bien meilleure — Seedream 5.5 revendique une préservation au pixel des zones non retouchées sur cent éditions, ce qui est le même problème dit autrement. Mais « même visage, autre angle, même chemise, trois fois, dans un composite » reste plus dur qu'il n'y paraît, et le mode d'échec est évident pour n'importe quel spectateur : un cadre où la personne est légèrement quelqu'un d'autre, et tout s'effondre.
Le petit texte est l'autre échec. Des caractères chinois de la taille d'un sous-titre, en bas d'un cadre vertical compressé, c'est proche du pire cas pour un modèle d'image : traits denses, basse résolution, fort contraste sur un fond chargé. Les sorties de cet automne qui se vantent de leurs taux de corruption de caractères sont, qu'elles le disent ou non, en compétition exactement pour ce cas d'usage.
L'économie du gabarit
C'est la troisième vague du même motif. D'abord un prompt circule. Puis un gabarit le ramène à un geste. Puis les outils de montage de la plateforme l'absorbent, et le gabarit devient une infrastructure invisible.
L'effet de slow motion « entrée du patron » de Douyin a suivi ce chemin, comme les gabarits de danse CapCut qui transforment une photo en clip de douze secondes et ont été utilisés des dizaines de milliers de fois. Le triptyque fixe est plus tôt dans le cycle — surtout piloté par le prompt, copié de post en post, les bonnes versions se distinguant au goût plutôt qu'à l'outillage.
La question intéressante, c'est ce qui se passe quand il sera produit. Un gabarit qui garantit trois cadres cohérents à partir d'un seul téléversement supprimerait la seule partie qui demande aujourd'hui du savoir-faire. Restent le casting, le vestiaire et les deux lignes de texte. C'est une surface créative bien plus petite, et c'est aussi exactement là que va l'attention du public.
L'indice, c'est ce que les gens ont cessé de prompter
Il y a six mois, les prompts qui circulaient sur ces plateformes portaient sur des objets : un chat en costume, une ville de verre, une personne de fumée. Le prompt du triptyque porte sur la mise en scène. Il précise la distance de caméra, l'orientation du corps, l'origine de la lumière, la place du texte, et ce que la personne ressent dans chaque cadre.
C'est un changement de littératie, pas de modèles. Ceux qui obtiennent de bons résultats sont ceux qui ont appris à écrire comme un réalisateur plutôt que comme un client. Ce sont aussi ceux qui se plaignent le moins de l'outil, parce qu'ils ont cessé d'attendre qu'il devine.
Ce que cela dit du marché
La couverture occidentale de l'imagerie IA est obsédée par l'image héros unique : l'affiche, la photo produit, la keyframe. Les plateformes chinoises sont allées dans l'autre sens, vers des mises en page multi-cadres qui se comportent comme une publication — trois panneaux, une grille, une bande d'images fixes avec sous-titres.
C'est une différence de distribution, pas de goût. Un feed bâti sur le swipe et l'enregistrement récompense les objets qui survivent au recadrage et à la répétition. Un composite en trois panneaux, c'est quatre éléments dans un seul fichier. Il est optimisé pour l'endroit où il sera vu, ce qui est la plus vieille règle du design éditorial et celle que les outils d'IA ont ignorée pendant deux ans.
Si vous voulez essayer, le conseil honnête est de partir de votre propre photo, de garder le texte court, et de prévoir cinq ou six générations avant que les trois cadres s'accordent sur l'identité de la personne. Le prompt n'est pas la partie difficile. La partie difficile, c'est le deuxième cadre, où le modèle doit se souvenir d'un visage qu'il ne voit que de dos.
Articles associés
Une feuille de calcul communautaire de clics pour couper les publicités des Android chinois
Il ne touche pas au système, ne déverrouille rien, ne flashe rien. Il bascule un à un les interrupteurs que les fabricants ont déjà prévus. Le prix à payer, c'est la liste qu'il faut continuer d'écrire.
GPT Image 2.6 a tenu le prix des tokens et fait monter la facture
GPT Image 2.6 reprend chaque tarif au token de 2.5 et coûte malgré tout plus cher par image, parce qu'une part plus grande du travail se paie en tokens de sortie. Onze jours après le lancement, la grille tarifaire dit plus que le classement.
Quelqu'un a reconstruit IDM de l'extérieur et a écrit ce qu'il n'a pas touché
Une réimplémentation en Rust d'Internet Download Manager revendique 5 fois la vitesse et 86 langues. Le document le plus intéressant est le paragraphe qui explique comment elle a été construite sans rien copier.
Rune est un framework UI Rust conçu pour qu'un agent puisse vérifier son propre travail
Rune rend en headless, vide son arbre d'éléments et accepte des entrées scriptées, ce qui donne à un agent de codage un signal différable qu'aucune capture d'écran ne fournit. Le framework est en préversion et n'accepte pas de pull requests.