
La striscia a tre pannelli è il primo formato AI con uno stile di casa
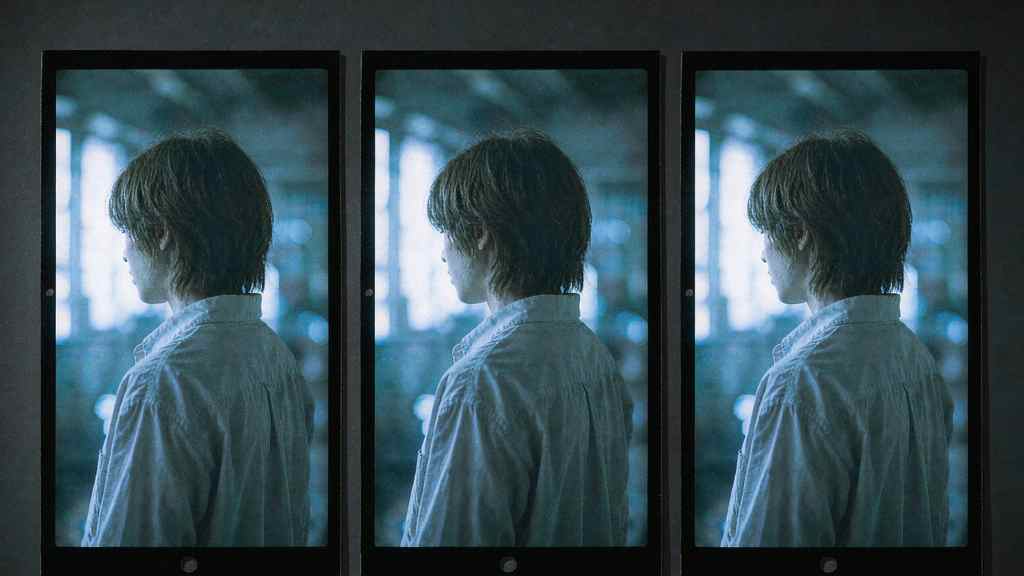
Se passi una serata su Douyin o Xiaohongshu, vedrai lo stesso layout di immagini ripetersi: tre riquadri verticali affiancati, una persona in ciascuno, tonalità fredde, leggermente sovraesposte, grana della pellicola e una riga di testo bilingue impressa in fondo al fotogramma.
I creatori cinesi lo chiamano 电影感三宫格, il trittico cinematografico. Il prompt che lo produce di solito circola come blocco di testo, e il blocco è straordinariamente specifico. Carica una foto. Chiedi tre riquadri della stessa scena. Riquadro uno: primo piano da dietro, mezzo busto, vento tra i capelli, sottotitolo 山的后面是什么? / What's beyond the mountain? Riquadro due: piano medio, di lato, con dei fiori in mano, sguardo basso, sottotitolo 你不用告诉我 / You don't have to tell me. Riquadro tre: campo largo, la figura piccola contro il cielo. Palette fredda, pellicola Fuji, alte luci bruciate, grana grossa, ombre ancora dettagliate, luce morbida e diffusa, nessun bordo netto, sottotitoli in basso al centro, componi i tre in un'unica immagine in 2:3.
Sembra uno shooting. È un template, e il template è l'oggetto interessante.
Perché tre, e perché verticale
Tre riquadri è il numero più piccolo che può raccontare una storia senza essere una sequenza. Due sembra un prima-e-dopo. Quattro sembra una griglia, e una griglia si legge come un contact sheet: prova, non emozione. Tre si leggono come una striscia di pellicola: un momento di ambientazione, una svolta, un rilascio.
Il verticale è un vincolo di piattaforma diventato estetica. Un fotogramma 9:16 è quello che ti dà il telefono, quindi tre affiancati in una tela 2:3 producono un'immagine larga fatta di finestre alte. È la forma di uno schermo cinematografico tagliato in tre schermi di telefono, che è esattamente la battuta visiva che lo fa funzionare: grammatica del cinema, consegnata nel formato che il feed già premia.
E poi c'è la parte pratica che nessuno dice ad alta voce. Un'immagine a tre riquadri è un oggetto da swipe. Si può pubblicare come un'unica immagine che si legge a dimensione miniatura, o ritagliare in tre post, o usare come copertina più due dettagli. Una generazione, diversi posizionamenti.
Il testo fa il lavoro emotivo
Il sottotitolo bilingue impresso è la parte in cui la maggior parte degli imitatori sbaglia. Copiano la composizione e saltano la tipografia, e il risultato sembra una foto stock con una didascalia appiccicata sopra.
Quello che fa funzionare il formato è che le parole sono brevi, leggermente malinconiche e tradotte. Cinese sopra, inglese sotto, stesso peso, in basso al centro. La traduzione non è lì per un pubblico internazionale. È lì perché due righe di testo in due lingue si leggono come un fotogramma di film, mentre una riga si legge come un meme. La seconda lingua è una texture, non un messaggio.
È anche il motivo per cui il formato resiste alla traduzione in altri mercati. Scambia le lingue e diventa un esercizio di sottotitoli. Tieni la coppia e sembra un post cinese, perché lo è. L'estetica non è universale: è una soluzione specifica a un feed specifico.
La coerenza è il vero problema tecnico
Guarda cosa chiede davvero il prompt. La stessa faccia in tre riquadri, a tre lunghezze focali. La stessa camicia. La stessa direzione della luce, nonostante la macchina si sia spostata di novanta gradi. Capelli che sembrano mossi dal vento in tutti e tre. E testo piccolo leggibile, in fondo a ogni riquadro, senza coprire il soggetto.
Ognuna di queste è un punto debole noto. La deriva dell'identità tra generazioni è la cosa per cui esistono i sistemi multi-riferimento, e la generazione di modelli di immagini del 2026 è molto migliorata: Seedream 5.5 dichiara la conservazione a livello di pixel delle regioni non modificate su cento modifiche, che è lo stesso problema detto in altro modo. Ma «stessa faccia, angolo diverso, stessa camicia, tre volte, in un solo composito» resta più difficile di quanto sembri, e il modo in cui fallisce è evidente a qualsiasi spettatore: un riquadro in cui la persona è leggermente un'altra, e crolla tutto.
Il testo piccolo è l'altro fallimento. Caratteri cinesi della dimensione di un sottotitolo in fondo a un fotogramma verticale compresso sono vicini al caso peggiore per i modelli di immagine: tratti densi, bassa risoluzione, alto contrasto su uno sfondo carico. Le uscite di questo autunno che si vantano dei tassi di corruzione dei caratteri stanno, che lo dicano o no, competendo esattamente per questo caso d'uso.
L'economia del template
Questa è la terza ondata dello stesso schema. Prima circola un prompt. Poi un template lo rende un tap solo. Poi gli strumenti di editing della piattaforma lo assorbono, e il template diventa infrastruttura invisibile.
L'effetto slow motion «ingresso del boss» di Douyin ha seguito quel percorso, così come i template di ballo di CapCut che trasformano una foto in una clip di dodici secondi e sono stati usati decine di migliaia di volte. Il fermo immagine a tre riquadri è più indietro nel ciclo: in gran parte guidato dal prompt, copiato da post a post, con le versioni buone distinguibili dal gusto più che dallo strumento.
La domanda interessante è cosa succede quando diventa un prodotto. Un template che garantisce tre riquadri coerenti da un solo caricamento eliminerebbe l'unica parte che oggi richiede abilità. Restano il casting, il guardaroba e le due righe di testo. È una superficie creativa molto più piccola, ed è anche esattamente dove va davvero l'attenzione del pubblico.
L'indizio è per cosa la gente ha smesso di scrivere prompt
Sei mesi fa i prompt che circolavano su queste piattaforme parlavano di oggetti: un gatto in giacca e cravatta, una città di vetro, una persona fatta di fumo. Il prompt a tre riquadri parla di messa in scena. Specifica distanza della macchina, orientamento del corpo, da dove viene la luce, dove sta il testo e cosa prova la persona in ogni riquadro.
È un salto di alfabetizzazione, non di modelli. Chi ottiene buoni risultati è chi ha imparato a scrivere come un regista invece che come un cliente. Sono anche quelli che si lamentano meno dello strumento, perché hanno smesso di pretendere che indovini.
Cosa dice sul mercato
La copertura occidentale dell'immaginario AI è ossessionata dalla singola immagine eroe: il poster, lo scatto di prodotto, il keyframe. Le piattaforme cinesi sono andate dall'altra parte, verso layout multi-riquadro che si comportano come una pubblicazione: tre pannelli, una griglia, una striscia di fermi immagine con sottotitoli.
È una differenza di distribuzione, non di gusto. Un feed costruito su swipe e salvataggio premia oggetti che sopravvivono al ritaglio e alla ripetizione. Un composito a tre riquadri è quattro asset in un solo file. È ottimizzato per il posto in cui sarà visto, che è la regola più vecchia del design editoriale e quella che gli strumenti AI hanno ignorato per due anni.
Se vuoi provarlo, il consiglio onesto è partire da una tua foto, tenere il testo breve e mettere in conto di generare cinque o sei volte prima che tutti e tre i riquadri siano d'accordo su chi sia la persona. Il prompt non è la parte difficile. La parte difficile è il secondo riquadro, dove il modello deve ricordare una faccia che può vedere solo di spalle.
Articoli correlati
Un foglio di calcolo comunitario di tocchi che spegne la pubblicità negli Android cinesi
Non tocca il sistema, non sblocca niente, non flasha niente. Ribalta solo gli interruttori che i produttori hanno già previsto. Il prezzo è una lista che qualcuno deve continuare a scrivere.
GPT Image 2.6 ha tenuto il prezzo dei token e alzato la fattura
GPT Image 2.6 conserva ogni tariffa per token di 2.5 e costa comunque di più per immagine, perché buona parte del lavoro passa ora nei token di output. Undici giorni dopo il lancio, la struttura dei prezzi dice più della classifica.
Qualcuno ha ricostruito IDM dall'esterno e ha scritto cosa non ha toccato
Una reimplementazione in Rust di Internet Download Manager promette 5 volte la velocità e 86 lingue. Il documento più interessante è il paragrafo che spiega come è stata costruita senza copiare nulla.
Rune è un framework UI per Rust costruito perché un agente possa verificare il proprio lavoro
Rune renderizza headless, esporta il suo albero di elementi e accetta input scriptato, dando a un agente di coding un segnale diffabile che nessuno screenshot può offrire. Il framework è in pre-release e non accetta pull request.