
RTX 4090のTFLOPSが倍になる、カーネルモジュールの正体
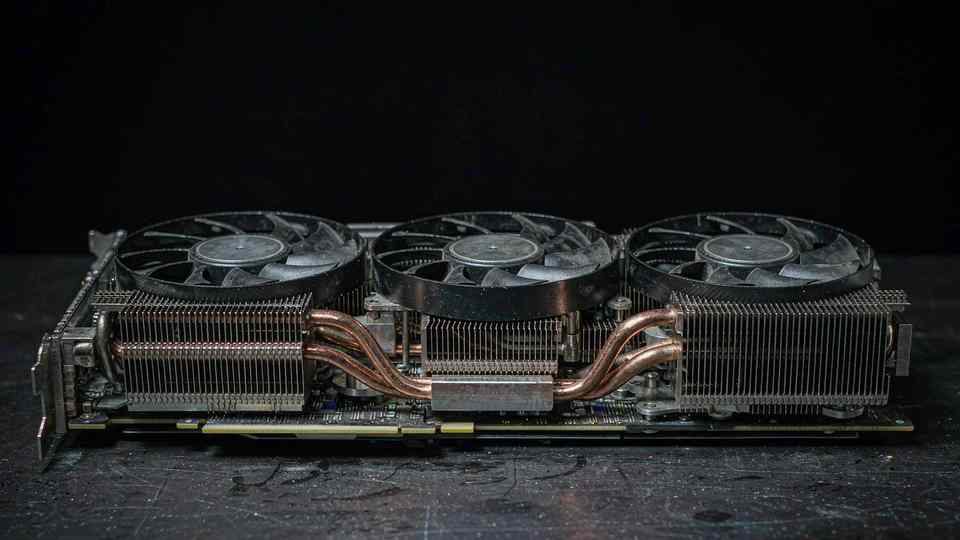
gpu-unlockのREADMEに、コーヒーを置いてしまった数字がある。RTX 4090のBF16行列演算が165から329 TFLOPSになる。オーバークロックではない。VBIOSの書き換えでもない。NVIDIAドライバが読み込まれる前に、カードの速度セレクタに2つの値を書き込むだけだ。
このプロジェクトは秋のあいだGitHubの月間トレンドリストを上り続け、現在約1万7700スター。Linuxカーネルモジュールで、GPL-2.0。メンテナは1人で、READMEの最後に「GPUをもっと買うのを手伝ってほしい」と書いている。
NVIDIAが実際に出荷しているもの
GeForceカードは、FP32アキュムレーションを伴うFP16、BF16、TF32の演算で、テンソルコアが半分のレートに制限された状態で出荷される。これはニッチな命令セットではない。量子化されていない推論のほぼすべてと、ファインチューニングの事実上すべてがこれを使う。同じシリコンがRTX Aシリーズやデータセンター向けとして売られる場合は、フルレートで動く。
これは秘密ではない。市場のセグメンテーションであり、READMEもそう書いている。ユーザーがなぜNVIDIAはカードを制限したのかと尋ねると、「企業にはこれらの制限がないプロ向けカードを、かなり高い価格で買ってほしいからだ」と一行で答えている。
アンロックはドライバのパッチでもファームウェアの書き換えでもない。initramfs内で、nvidiaがカードを掴む前に動くモジュールで、速度セレクタを書き込み(SS0の0x88888888が完全なBF16レートを選び、4ビットのSS1 0x8がIMLA4を有効にする)、関数レベルのリセットを行う。この手法は既存のアンロック手法と慎重なタイミングを組み合わせている。ディスク上の何も変更しないので、新しいNVIDIAドライバが出ても元に戻らない。
効果は本物だが、一様ではない
見出しの数字は密行列のスループットで、しかも大きい。RTX 3060は27から51 TFLOPSへ。3090は75から125へ。4090はピークレートで倍になる。ただし、はっきり書かれている注意として、4090はテンソルコアを使い切る前に電力を使い切るので、実ワークロードの向上はピークが示すよりずっと小さい。
実ワークロードはさらに面白い。ばらつきが非常に大きいからだ。
- LLMのprefill / プロンプト処理(FP16、BF16、AWQ、GPTQ):+25〜55%
- 初回トークンまでの時間:25〜30%短縮
- BF16でのLoRAおよびフルファインチューニング:+25〜50%
- 画像生成(SDXL、SD 1.5、ComfyUI上のDiTモデル):+30〜55%
- BF16演算による動画生成(Wan 2.2):+15〜20%
- FlashAttentionとSDPAカーネル:+50〜60%
- 量子化GGUFでのllama.cpp / Ollama:0〜15%、主に長いコンテキストで
- トークン単位のデコード、INT8/FP8/INT4、ゲーミング、素のFP32 CUDA:まったく変化なし
最後の行をみんな見落とす。ワークロードがメモリ帯域律速のデコード——1枚のカードでのチャット推論のほとんどがそうだ——なら、何も得られない。アンロックが買うのは行列スループットであって、帯域ではない。バッチサイズ1で4ビットモデルを動かしている人はタブを閉じていい。
効くのはprefill、ファインチューニング、拡散モデルだ。画像生成で30〜55%の高速化は、午後に何回イテレーションを回せるかを変える。しかも電気代以外はタダで、熱だけが増える。
なぜ「ビット同一」が面白い主張なのか
READMEは、出力は前後でビット単位で同一で、変わるのは速度だけだと述べている。この一文が、これをオーバークロックと法的にも実務的にも別物にする。
オーバークロックは結果を変え、長時間の学習を壊すことがあり、ベンダーが検出できる形で保証を無効にする。レートリミッタを外しても算術は変わらない。同じ命令が同じ順序で実行され、1サイクルあたりの本数が増えるだけだ。再現性要件があるなら、それは保たれる。
つまり本当のリスクは熱と電気だけになる。READMEの答えは抑制が効いている。標準のスロットリングと電力管理はそのまま残るので、カードは焼けるのではなくクロックを落とすはずだ。風通しの良いデスクトップならもっともらしい。もちろん、借り物のワークステーションを賭けるべき保証ではない。
インストールと、壊れるところ
Linuxのみ。ディストリビューションがArch、Debian/Ubuntu、Fedoraなら、インストールは3ステップだ。
git clone https://github.com/Zagitta/gpu-unlock
cd gpu-unlock
make installそのあとカーネルコマンドラインにgpu_unlock.targets=allを追記する。特定のカードだけならPCIアドレスのカンマ区切りリストでもよい。再起動する。確認はjournalctl -k -b | grep gpu_unlock。
カード対応は、プロジェクトが自らの限界に正直な部分だ。Ampere(RTX 30)は100件以上のユーザー報告を伴って安定とされている。Ada(RTX 40)とTuring(RTX 20)は実験的。Blackwell(RTX 50)は未対応で、作者によれば実現する見込みは低い。
試す前に知っておくべき失敗モードが2つある。ノートPCでは、ディスクリートGPUが電源を落とすたびにアンロックが失われる。アイドル時にそうなる機種は多い。ランタイムの電力管理を切ると効く機種と効かない機種がある。もうひとつ、サスペンド・トゥ・RAMはセレクタをリセットする。ただしモジュールは既定で復帰時にアンロックを再適用し、そのぶん約1秒かかる。
WindowsはREADMEがリンクする第三者の移植版だけが存在し、「あなたの環境でうまくいくとは限らない」と添えられている。さらに、このプロジェクト名を使った暗号通貨やインストーラが出回っているが、どれも本人のものではないと、何度も見てきた人の淡々とした口調で警告している。
誰も書きたがらない部分
世界のゲーミングPCにあるAI演算の半分は、価格帯を守るために存在するファームウェアのスイッチの向こう側にある。これがここでの本当の発見であり、1つのリポジトリより大きい。
一度知ってしまうと、他のものの見え方も変わる。クラウドGPUの価格は、リミッタが外れたカードを基準に決まっている。中古の3090は2年間、静かに定価以上の価値があった。そして「本気の推論にはデータセンターGPUが必要だ」という議論全体が、10分の1の価格のカードでテンソルスループットの65%を取り戻すカーネルモジュールの前では、少し柔らかくなる。
正当な反論もあり、私もそれを言う。セグメンテーションは、そもそもこれらのカードを使えるものにしているソフトウェアスタックにNVIDIAが資金を出す方法だ。CUDAは自腹で払われたわけではない。コンシューマカードのアンロックは窃盗ではないが、無料でもない。コストはプロ向けを買う全員が負担している。
それはスイッチが存在するかどうかではなく、公平さについての議論だ。そして公平さの議論は、たいてい暇なLinuxマシンと、金曜までに終わらせたいファインチューニングの仕事を持つ人の手を止めない。
試すなら
再インストールしてもいいマシンでやること。まず世代を確認する。報告が集まっているのはAmpereだ。ベンチマークは前後で、実際に回すワークロードで取る。合成GEMMでは駄目だ。ここでの話の全体は、効果が行列演算律速かメモリ帯域律速かで決まるということだからだ。
そしてFAQを読むこと。作者は「GPUは傷むのか」に理由を添えてノーと答え、「なぜNVIDIAはこんなことをしたのか」には、ほとんどのベンダーのホワイトペーパーより役に立つ一文で答えている。
関連記事
中国製 Android のシステム UI に載った広告を切る、コミュニティ管理のタップ表
システムには触らず、アンロックも書き込みもしない。ベンダーがもともと用意したスイッチを一つずつ倒すだけだ。代償は、この一覧を書き続ける人が要ることにある。
GPT Image 2.6 はトークン単価を据え置き、請求額を上げた
GPT Image 2.6 は 2.5 のトークン単価をすべて引き継ぎながら、1 枚あたりの費用は上がった。仕事の多くが出力トークン側に移ったからだ。11 日目の価格構造は、ランキングより多くを語る。
外から IDM を作り直した人が、触れなかった部分を書き残した
Mister Download Manager は Internet Download Manager の流れを Rust で作り直し、5 倍の速度と 86 言語を掲げる。より興味深いのは、何もコピーせずにどう作ったのかを説明した段落のほうだ。
Rune はエージェントが自分の仕事を検証できるように作られた Rust UI フレームワーク
Rune はヘッドレスで描画し、要素ツリーを出力し、スクリプト化された入力を受け付ける。スクリーンショットでは決して得られない、diff できる信号をコーディングエージェントに渡せる。フレームワークはプレリリースで、プルリクエストは受け付けない。