
一段片子两个视角、一个 DINOv2 读取器,26 美分换一个绑定好的 GLB
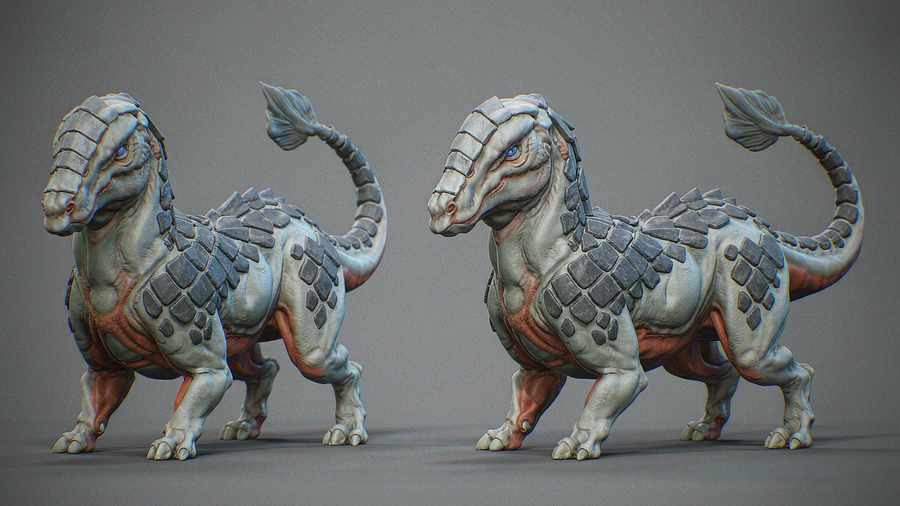
动捕有个没人聊的扩展性问题,不是动捕服的价格。是动捕为人而造——两条腿、一副已知的骨架、一个标准胯高——而你的角色一旦是龙、是巨蛛、是火焰恶魔,整条流水线立刻不适用。
游戏和电影靠动画师解决。动画师看一段参考,然后一帧一帧手动给生物的四条腿打关键帧,因为参考是人在走路,目标是六条腿加一条尾巴的东西。这就是那份工作本身。也是为什么在有大量项目的制作里,生物动画是最贵的条目之一。
Patch 的 anymove 是想自动化这条具体的缝。它有 452 stars,10 月 27 日出现,只做一件事:把一段 AI 生成的生物视频,变成绑定好、带动画的 GLB。
有意思的是它为了做到这件事用的那个把戏,而这个把戏跟相机有关。
一帧里两个视角
人类动捕能用,是因为多台相机从不同角度看到同一具身体,那些视线的交点给出三维位置。一台相机给你一个平面上的二维位置,而平面不是身体。
你没法在一段 AI 生成的片子周围架两台相机,因为这段片子不存在于三维里。它是像素。
所以 anymove 让视频模型做一件有点怪的事:在同一个画面里,同时从正面和侧面拍同一个生物。一张双联画——两块并排的面板,一个生物,两个视点,同步运动。
这样你又有了两条视线。正视图给 X 和 Y。侧视图给 Z 和 Y。求交,一个关节就有了三维位置,从一段平面视频里恢复出来,不用深度模型,不用多机位。
仓库原来叫 diptych,改名 anymove 作为产品决定说得通,但旧名字更诚实地描述了机制。双面板那一帧才是发明。剩下都是管道。
流水线,一段一段
生成片子。 一个动作一段 AI 视频。README 说每段 0.26 美元——龙、巨蛛、火焰恶魔、狼这几个演示都是这么做的。提示词必须把双联构图稳住,而这是整套方法唯一能崩的地方:如果模型让两块面板的取景漂了,两个视角就不再对应,三角测量就是垃圾。
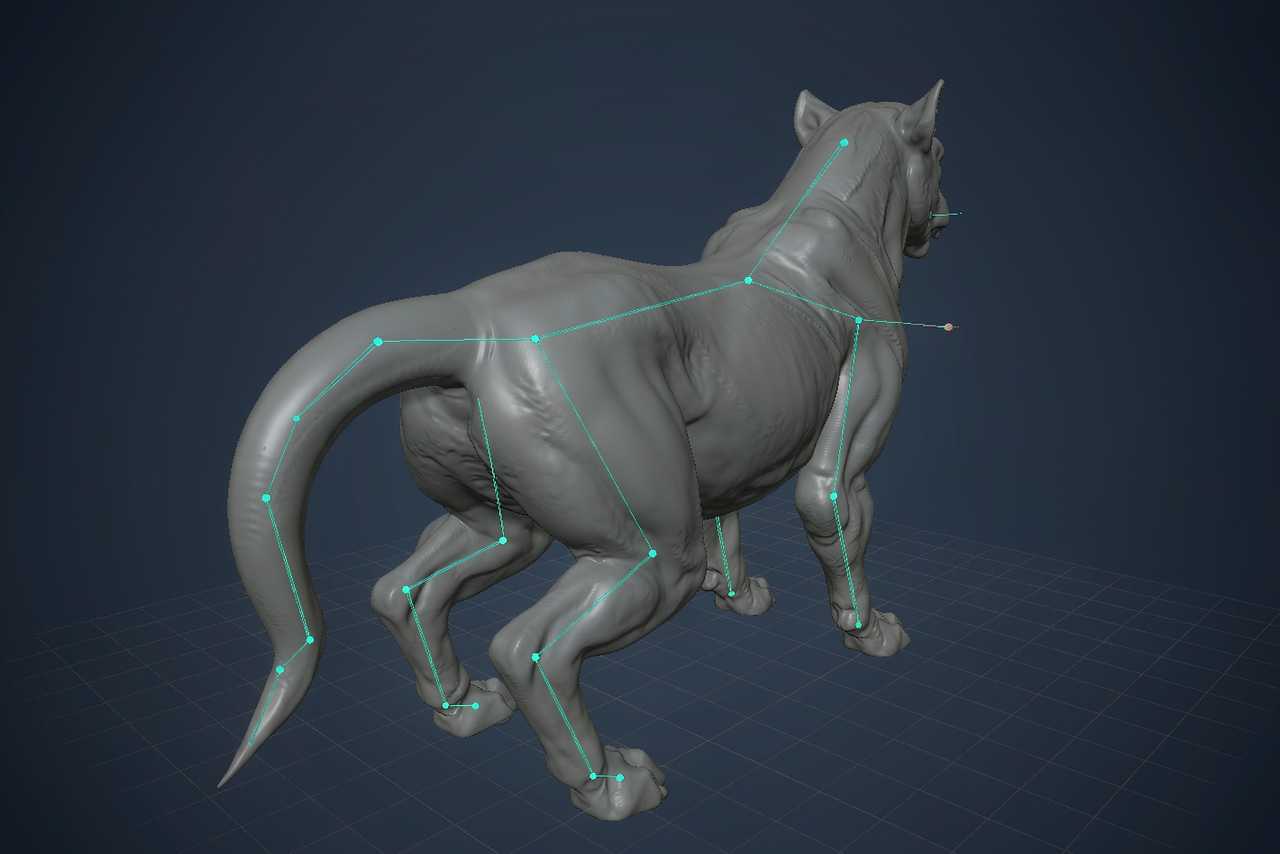
读关节。 一个基于 DINOv2 的读取器在两个视角里找每个关节。这是你要训的模型,也是贵的部分——训练要 24GB 显存。之后读取要少得多。
拟合骨架。 两个视角「像两面墙立起来,把每个关节钉在三维里」,借 README 的说法。然后把骨架拟合到恢复出来的点。输出是骨骼动画,不是点云,这才让它在下游能用。
导出。 一个 GLB,加一段 showcase.mp4,把动画放在源片段旁边,让你能对比而不骗自己。
最后那件产物,和今年更好的 agent 工具是同一个直觉:永远出并排图,因为模型会很乐意告诉你它成功了,而唯一的防御是亲眼看。
安装,多数人会停在这
要求很具体:一块带 CUDA 的 NVIDIA 显卡、Python 3.11、PATH 里的 Blender 5.x(或者一个 BLENDER 环境变量),以及一个 fal key,如果你想做新片段。
git clone https://github.com/Patch-gg/anymove && cd anymove
python3.11 -m venv .venv
.venv/bin/pip install torch==2.11.0 --index-url https://download.pytorch.org/whl/cu128
.venv/bin/pip install -r requirements.txt
cp .env.example .env    # add your FAL_KEY
注意钉死的 torch 版本和明写的 CUDA 12.8 索引。这不是一个你手上随便哪个 Python 都能跑的项目。
上手体验最好的一段是纯 CPU 的烟雾测试。仓库带了读取器已经为龙的咆哮找好的关节检测结果,所以你不下载 355MB 权重、不装 Blender,也能拟合骨架:
mkdir -p runs/dragon/clips/roar
MOCAP_CREATURE=assets/dragon .venv/bin/python -m mocap.solve \
  examples/dragon_roar/det.npz \
  assets/dragon/rigged/rig_info.json \
  runs/dragon/clips/roar/motion.json
大约二十秒,它会打印两个视角的一致程度——这才是你真正想要的诊断,因为视角之间的不一致,正是整套架构暴露在外的失败模式。
完整路径,用发布里的示例生物网格、训好的读取器和片段(13MB 网格、355MB 读取器、4MB 片段):
tools/fetch_examples.sh dragon --readers --clips
tools/prep.sh dragon && tools/rig.sh dragon
tools/capture.sh dragon runs/dragon/videos/roar/s1/h3max.mp4 roar
给同一个生物加一个新动作,大约 0.52 美元,因为它要拍两段:
.venv/bin/python tools/make_prompt.py assets/dragon \
  "the dragon whips its tail from side to side, then stands still." \
  prompts/dragon/tailwhip.txt
tools/film.sh dragon tailwhip h3max 1,2
tools/capture.sh dragon runs/dragon/videos/tailwhip/s1/h3max.mp4 tailwhip
这里真正难的地方
重定向。恢复关节位置是一个问题;把它们映射到一副具体骨架、具体骨长、具体静止姿势上,是另一个。如果龙的骨架脖子比恢复出来的点更长,那要么脖子弯得怪,要么头浮空。README 的说法——「骨架落到点上」——暗示的是拟合而不是重定向,这是更简单也更诚实的选择:动画的好坏,取决于骨架比例和片段合不合。
脚部接触。每条动捕流水线都在跟脚滑较劲,而从生成视频做的双视角求解没有地平面、没有受力数据、没有物理约束。一条滑步的龙就是一条假龙,关节再好也没用。
遮挡。两个视角有帮助,但只有两个。某条肢体在两块面板里都藏在身体后面时,只能靠推断,而模型会编一个说得过去的东西。
经济账,这才是真故事
每段 0.26 美元。读取加拟合不到一分钟。仓库里四个示例生物,每个都有自己的骨架、提示词和读取器。
跟替代方案比:一个动画师、一天、一轮修改。这个比较不公平——产出质量不一样,也没人会拿它做主角的标志性动作。但对背景生物、敌人变体、群杂填充,或者预告片里怪物只出现两秒的那四十秒,0.26 美元直接消掉了一整场「这个镜头值不值得做」的争论。
这又是今年的模式。不是「AI 取代手艺」。AI 把你本来就打算扔掉的那一版成本压到零,手艺则上移到那些活下来的决定上。
你该试吗
如果你有 N 卡、装了 Blender、有一个你在乎的生物骨架,该——而且从 CPU 烟雾测试开始,不是完整流水线。它二十秒,告诉你两个视角在你的数据上一致不一致,那是花钱之前唯一要紧的问题。
如果你在 Mac 上,读取器训练这条路没了,拟合只是理论上的。仓库是 Apache-2.0,你可以移植。这个月我不建议。
相关文章
一份社区维护的点击表,关掉了国产 Android 系统里的广告
它不动系统,不解锁,不刷机,只把厂商本来就留出来的开关一个个拨过去。代价是这份名单得一直有人续写。
GPT Image 2.6 守住 token 价格,账单却涨了
GPT Image 2.6 沿用了 2.5 的全部 token 费率,单张图却更贵,因为更多的活现在花在输出 token 上。上线十一天,定价结构说的比排行榜更多。
有人从外部重建了 IDM,并写下了自己没有碰过的部分
Mister Download Manager 用 Rust 重写了 Internet Download Manager 的下载流程,声称速度快 5 倍、支持 86 种语言。更值得细读的,是它解释如何在不复制任何代码的前提下完成重写的那一段。
Rune 是一个 Rust UI 框架,设计初衷是让 agent 能检查自己的工作
Rune 能无头渲染、导出元素树并接受脚本化输入,这让编码 agent 拿到截图永远给不了的东西,一个可 diff 的信号。这个框架仍是预发布版本,不接受 pull request。