
anymove ricava l'animazione di una creatura da una clip: due viste in un fotogramma
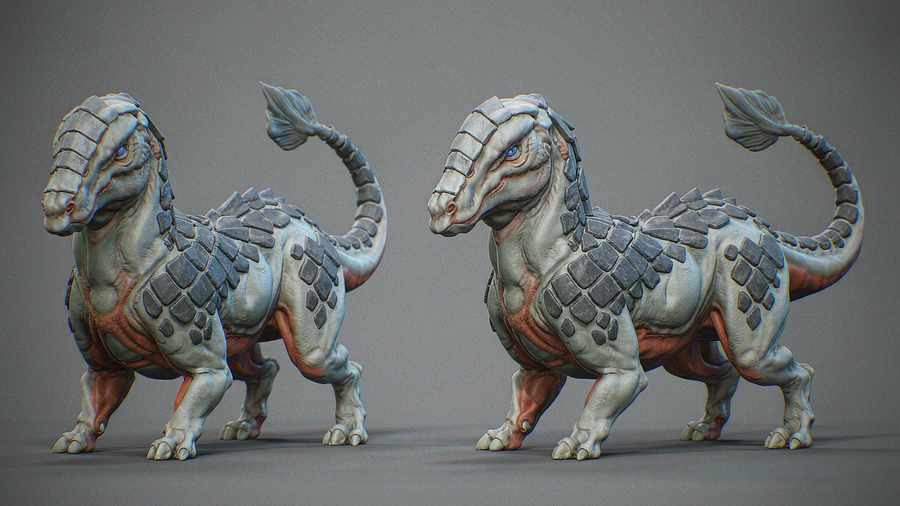
Il motion capture ha un problema di scala di cui nessuno parla, e non è il costo della tuta. È che il mocap è costruito per gli umani — due gambe, uno scheletro noto, un'altezza dei fianchi standard — e nel momento in cui il vostro personaggio è un drago, un ragno gigante o un demone di fuoco, l'intera pipeline smette di applicarsi.
Giochi e film risolvono la cosa con gli animatori. Un animatore guarda un riferimento, poi anima a mano gli arti della creatura, fotogramma per fotogramma, perché il riferimento è un umano che cammina e l'obiettivo è qualcosa con sei zampe e una coda. È il lavoro vero. È anche il motivo per cui l'animazione di creature è una delle voci più care in una produzione che ne ha molte.
anymove, di Patch, è un tentativo di automatizzare proprio quel vuoto. Ha 452 stelle, è apparso il 27 ottobre, e fa una cosa sola: trasformare un singolo video di una creatura generato dall'AI in un GLB riggato e animato.
La parte interessante è il trucco che usa per arrivarci, e il trucco riguarda le camere.
Due viste in un solo fotogramma
Il mocap umano funziona perché più camere vedono lo stesso corpo da angolazioni diverse, e l'intersezione di quelle linee di vista dà una posizione 3D. Una camera vi dà una posizione 2D su un piano, e un piano non è un corpo.
Non potete mettere due camere attorno a una clip generata dall'AI, perché la clip non esiste in 3D. Sono pixel.
Così anymove chiede al modello video qualcosa di un po' strano: filmare la stessa creatura di fronte e di lato, contemporaneamente, nello stesso fotogramma. Un dittico: due pannelli affiancati, una creatura, due punti di vista, in movimento sincrono.
Ora avete di nuovo due linee di vista. La vista frontale dà X e Y. La vista laterale dà Z e Y. Intersecatele e un giunto ha una posizione 3D, recuperata da un video piatto, senza modello di profondità e senza un rig multi-vista.
Il repo si chiamava dittico, e il cambio di nome in anymove ha senso come decisione di prodotto, ma il vecchio nome descriveva il meccanismo con più onestà. Il fotogramma a due pannelli è l'invenzione. Tutto il resto è impianto idraulico.
La pipeline, fase per fase
Generare la clip. Un video AI per mossa. Il README lo mette a 0.26 dollari per clip: il drago, il ragno gigante, il demone di fuoco e il lupo delle demo sono nati così. Il prompt deve tenere ferma la composizione a dittico, che è l'unico punto in cui l'intero approccio può cedere: se il modello sposta l'inquadratura tra un pannello e l'altro, le due viste smettono di corrispondere e la triangolazione diventa spazzatura.
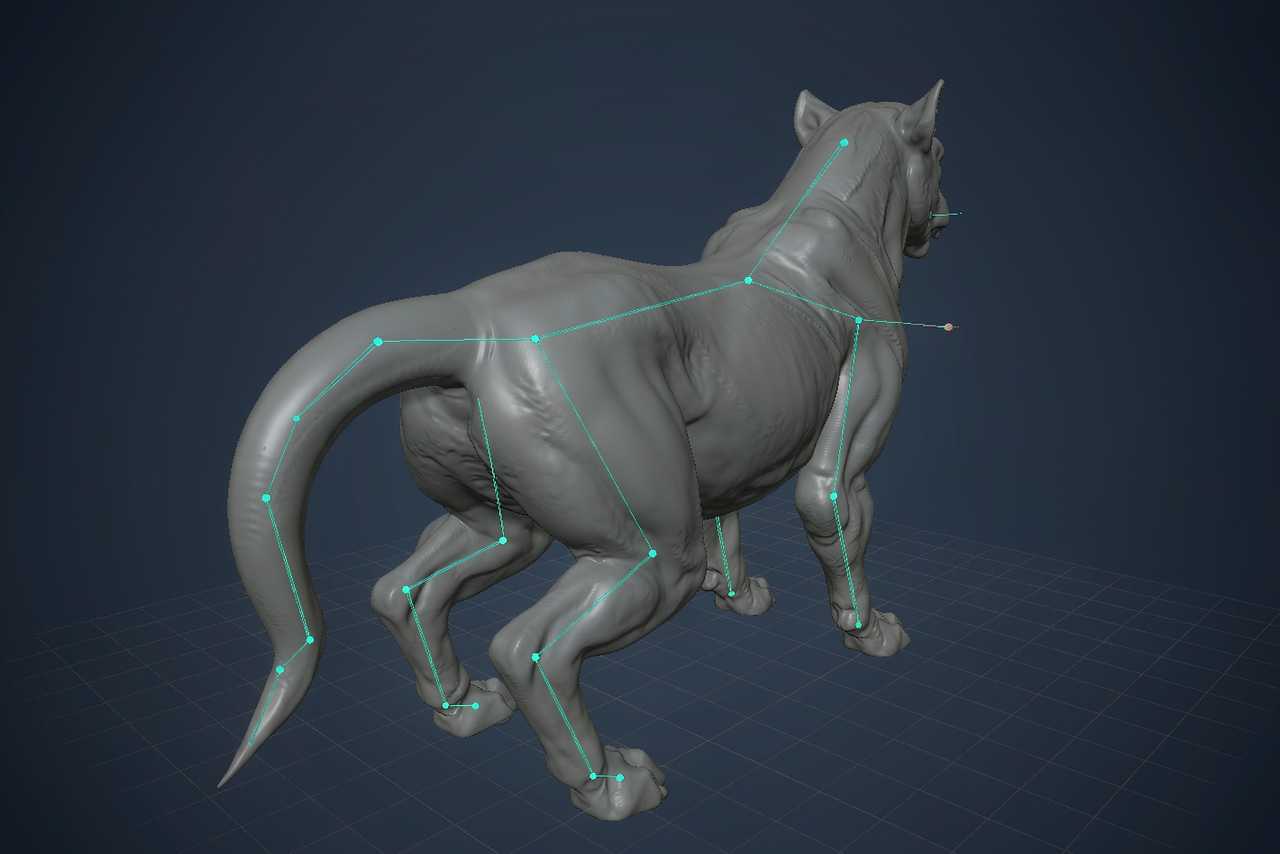
Leggere i giunti. Un lettore basato su DINOv2 trova ogni giunto in entrambe le viste. È il modello che si addestra, ed è la parte costosa: 24GB di VRAM per l'addestramento. La lettura, dopo, ne richiede molta meno.
Adattare il rig. Le due viste «si alzano come muri e fissano ogni giunto nello spazio 3D», per usare l'immagine del README. Poi il rig viene adattato ai punti recuperati. L'output è un'animazione di ossa, non una nuvola di punti, ed è questo che la rende utilizzabile a valle.
Esportare. Un GLB, più uno showcase.mp4 che mette l'animazione accanto alla clip di partenza, così potete confrontarle senza raccontarvi bugie.
Quest'ultimo artefatto è lo stesso istinto che si vede nei migliori strumenti agentici di quest'anno: produci sempre il confronto affiancato, perché il modello vi dirà volentieri che ha funzionato e l'unica difesa è guardare.
L'installazione, dove si ferma la maggior parte della gente
I requisiti sono specifici: una GPU NVIDIA con CUDA, Python 3.11, Blender 5.x nel PATH (o una variabile d'ambiente BLENDER) e una chiave fal se volete produrre nuove clip.
git clone https://github.com/Patch-gg/anymove && cd anymove
python3.11 -m venv .venv
.venv/bin/pip install torch==2.11.0 --index-url https://download.pytorch.org/whl/cu128
.venv/bin/pip install -r requirements.txt
cp .env.example .env    # add your FAL_KEY
Notate la build di torch bloccata e l'indice CUDA 12.8 esplicito. Questo non è un progetto che funzionerà con il Python che vi capita di avere.
La parte più bella dell'onboarding è lo smoke test su CPU. Il repo include i rilevamenti dei giunti che il suo lettore ha già trovato per il ruggito del drago, così potete adattare il rig senza scaricare 355MB di pesi né installare Blender:
mkdir -p runs/dragon/clips/roar
MOCAP_CREATURE=assets/dragon .venv/bin/python -m mocap.solve \
  examples/dragon_roar/det.npz \
  assets/dragon/rigged/rig_info.json \
  runs/dragon/clips/roar/motion.json
Una ventina di secondi, e stampa quanto le due viste concordano: che è la diagnostica che volete davvero, perché il disaccordo tra le viste è il modo di fallire a cui tutta l'architettura è esposta.
La via completa, con la mesh della creatura di esempio, il lettore addestrato e la clip dalla release (13MB di mesh, 355MB di lettore, 4MB di clip):
tools/fetch_examples.sh dragon --readers --clips
tools/prep.sh dragon && tools/rig.sh dragon
tools/capture.sh dragon runs/dragon/videos/roar/s1/h3max.mp4 roar
E una nuova mossa per la stessa creatura, che costa circa 0.52 dollari perché filma due clip:
.venv/bin/python tools/make_prompt.py assets/dragon \
  "the dragon whips its tail from side to side, then stands still." \
  prompts/dragon/tailwhip.txt
tools/film.sh dragon tailwhip h3max 1,2
tools/capture.sh dragon runs/dragon/videos/tailwhip/s1/h3max.mp4 tailwhip
Dove è davvero difficile
Il retargeting. Recuperare le posizioni dei giunti è un problema; mapparle su uno specifico rig con una specifica lunghezza delle ossa e una specifica posa di riposo è un altro. Se il rig del drago ha un collo più lungo di quanto suggeriscano i punti recuperati, o il collo si piega in modo strano o la testa galleggia. La formulazione del README — «il rig atterra sui punti» — suggerisce un adattamento più che un retargeting, che è la scelta più facile e più onesta: l'animazione vale quanto le proporzioni del rig somigliano a quelle della clip.
Il contatto con il suolo. Ogni pipeline di mocap litiga con i piedi che scivolano, e una soluzione a due viste da un video generato non ha piano di appoggio, non ha dati di forza e non ha vincoli fisici. Un drago che pattina è un drago che sembra finto, per quanto buoni siano i giunti.
L'occlusione. Due viste aiutano, ma sono solo due. Un arto nascosto dietro il corpo in entrambi i pannelli va dedotto, e il modello inventerà qualcosa di plausibile.
L'economia, che è la vera storia
Ventisei centesimi per clip. Meno di un minuto per leggere e adattare. Quattro creature di esempio nel repo, ognuna con il suo rig, i suoi prompt e il suo lettore.
Confrontatelo con l'alternativa: un animatore, una giornata, un ciclo di revisioni. Il confronto non è leale: la qualità dell'output non è la stessa, e nessuno spedirà la mossa firma del protagonista fatta così. Ma per le creature di sfondo, le varianti dei nemici, la folla di riempimento o i quaranta secondi di trailer in cui il mostro sta a schermo per due, ventisei centesimi tolgono un'intera discussione sul fatto che l'inquadratura valga la pena.
È lo schema di quest'anno, di nuovo. Non «l'AI sostituisce il mestiere». L'AI fa crollare il costo della versione che stavate per buttare via, e il mestiere si sposta sulle decisioni che sopravvivono.
Vale la pena provarlo
Se avete una scheda NVIDIA, un'installazione di Blender e un rig di creatura a cui tenete, sì, e cominciate dallo smoke test su CPU, non dalla pipeline completa. Dura venti secondi e vi dice se le due viste concordano sui vostri dati, che è l'unica domanda che conta prima di spendere qualcosa.
Se siete su Mac, l'addestramento del lettore è fuori discussione e l'adattamento è teorico. Il repo è Apache-2.0, quindi potete fare il port. Io non lo farei, questo mese.
Articoli correlati
Un foglio di calcolo comunitario di tocchi che spegne la pubblicità negli Android cinesi
Non tocca il sistema, non sblocca niente, non flasha niente. Ribalta solo gli interruttori che i produttori hanno già previsto. Il prezzo è una lista che qualcuno deve continuare a scrivere.
GPT Image 2.6 ha tenuto il prezzo dei token e alzato la fattura
GPT Image 2.6 conserva ogni tariffa per token di 2.5 e costa comunque di più per immagine, perché buona parte del lavoro passa ora nei token di output. Undici giorni dopo il lancio, la struttura dei prezzi dice più della classifica.
Qualcuno ha ricostruito IDM dall'esterno e ha scritto cosa non ha toccato
Una reimplementazione in Rust di Internet Download Manager promette 5 volte la velocità e 86 lingue. Il documento più interessante è il paragrafo che spiega come è stata costruita senza copiare nulla.
Rune è un framework UI per Rust costruito perché un agente possa verificare il proprio lavoro
Rune renderizza headless, esporta il suo albero di elementi e accetta input scriptato, dando a un agente di coding un segnale diffabile che nessuno screenshot può offrire. Il framework è in pre-release e non accetta pull request.