
anymove macht aus einem generierten Clip ein geriggtes GLB für 26 Cent
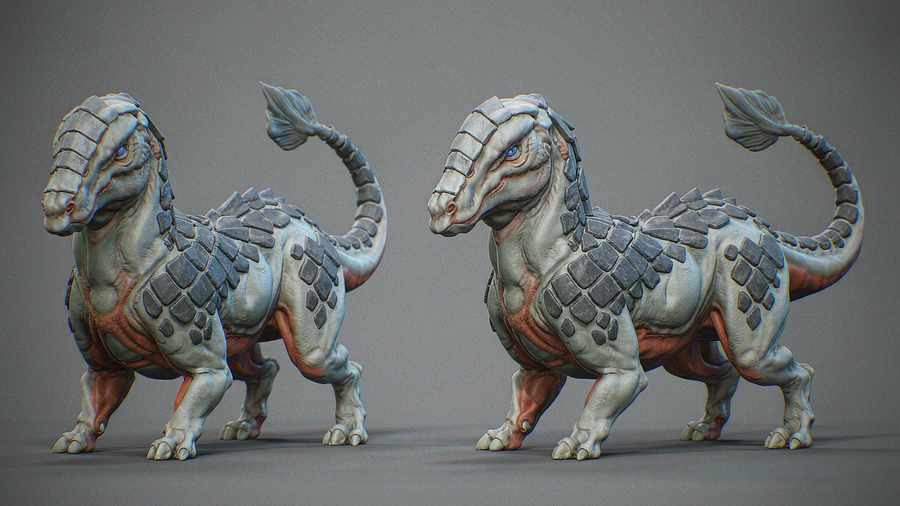
Motion Capture hat ein Skalierungsproblem, über das niemand spricht, und es sind nicht die Kosten des Anzugs. Es ist, dass Mocap für Menschen gebaut ist – zwei Beine, ein bekanntes Skelett, eine Standardhüfthöhe –, und in dem Moment, in dem die Figur ein Drache, eine Riesenspinne oder ein Feuerdämon ist, greift die ganze Pipeline nicht mehr.
Spiele und Filme lösen das mit Animatoren. Ein Animator sieht sich eine Referenz an und keyt dann die Gliedmaßen einer Kreatur von Hand, Frame für Frame, weil die Referenz ein gehender Mensch ist und das Ziel etwas mit sechs Beinen und einem Schwanz. Das ist die eigentliche Arbeit. Und deshalb ist Kreaturenanimation einer der teuersten Posten in einer Produktion, die viele davon hat.
anymove von Patch ist der Versuch, genau diese Lücke zu automatisieren. Es hat 452 Stars, erschien am 27. Oktober und macht eine Sache: aus einem einzelnen KI-generierten Video einer Kreatur ein geriggtes, animiertes GLB machen.
Das Interessante ist der Trick, mit dem das gelingt, und der Trick dreht sich um Kameras.
Zwei Ansichten in einem Frame
Menschliches Mocap funktioniert, weil mehrere Kameras denselben Körper aus verschiedenen Winkeln sehen, und der Schnittpunkt dieser Sichtlinien ergibt eine 3D-Position. Eine Kamera liefert eine 2D-Position auf einer Ebene, und eine Ebene ist kein Körper.
Man kann keine zwei Kameras um einen KI-generierten Clip stellen, weil der Clip nicht in 3D existiert. Er ist Pixel.
Also verlangt anymove vom Videomodell etwas leicht Absonderliches: dieselbe Kreatur von vorn und von der Seite zu filmen, gleichzeitig, im selben Frame. Ein Diptychon – zwei Panels nebeneinander, eine Kreatur, zwei Blickwinkel, synchron bewegt.
Jetzt hat man wieder zwei Sichtlinien. Die Vorderansicht liefert X und Y. Die Seitenansicht liefert Z und Y. Schneidet man sie, hat ein Gelenk eine 3D-Position – gewonnen aus einem flachen Video, ohne Tiefenmodell und ohne Multi-View-Rig.
Das Repo hieß ursprünglich diptych, und die Umbenennung in anymove ergibt als Produktentscheidung Sinn, aber der alte Name beschrieb den Mechanismus ehrlicher. Der zweiteilige Frame ist die Erfindung. Alles andere ist Rohrleitung.
Die Pipeline, Etappe für Etappe
Den Clip erzeugen. Ein KI-Video pro Move. Die README nennt 0.26 $ pro Clip – die Drachen-, Riesenspinnen-, Feuerdämon- und Wolf-Demos entstanden alle so. Der Prompt muss die Diptychon-Komposition stabil halten, und das ist die eine Stelle, an der der ganze Ansatz scheitern kann: Driftet das Modell die Bildkomposition zwischen den Panels, korrespondieren die beiden Ansichten nicht mehr, und die Triangulation ist Müll.
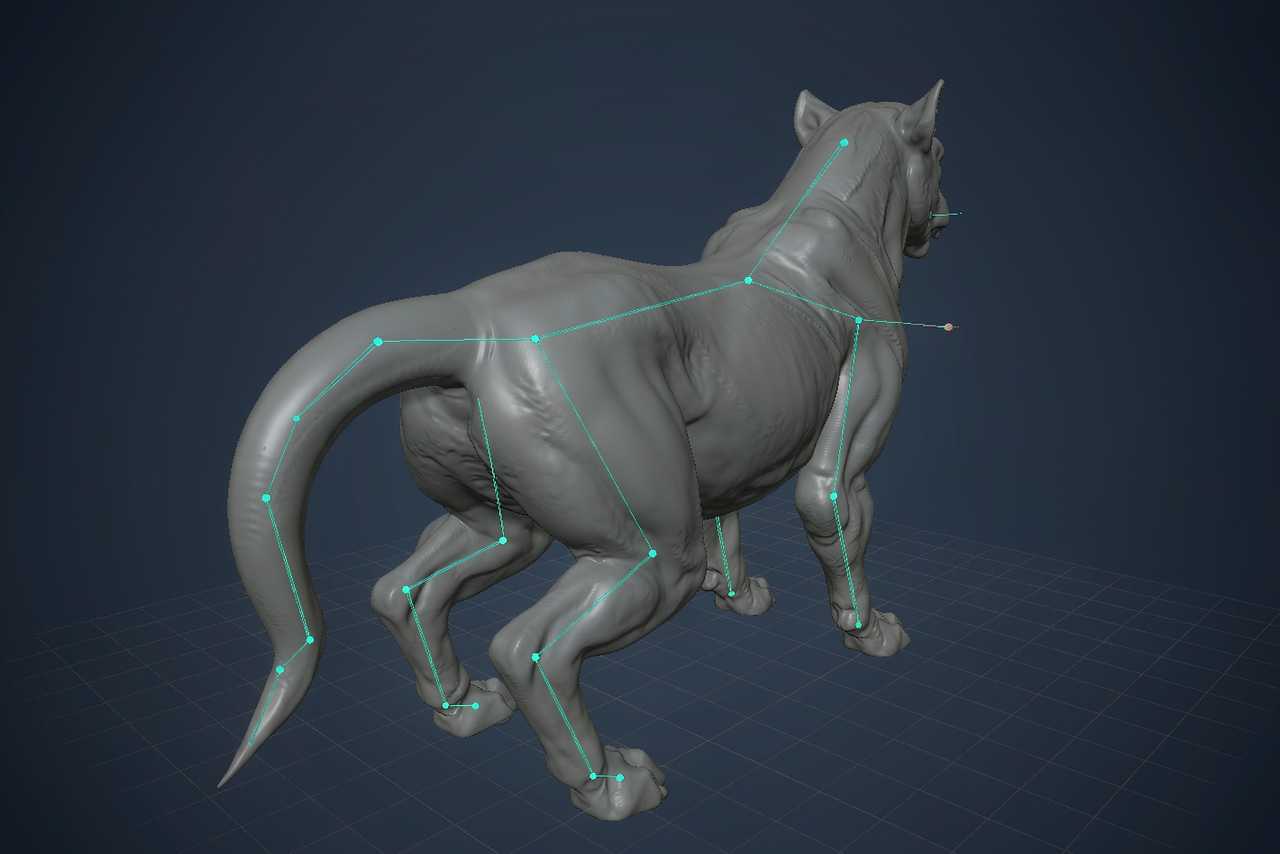
Die Gelenke lesen. Ein DINOv2-basierter Reader findet jedes Gelenk in beiden Ansichten. Das ist das Modell, das man trainiert, und es ist der teure Teil – 24GB VRAM für das Training. Das Lesen danach braucht viel weniger.
Das Rig anpassen. Die beiden Ansichten „stehen wie Wände auf und fixieren jedes Gelenk in 3D“, um das Bild der README zu borgen. Das Rig wird dann an die gewonnenen Punkte angepasst. Die Ausgabe ist eine Knochenanimation, keine Punktwolke, und das macht sie weiterverwendbar.
Export. Ein GLB, plus ein showcase.mp4, das die Animation neben den Quellclip legt, damit man sie vergleichen kann, ohne sich selbst zu belügen.
Dieses letzte Artefakt ist derselbe Instinkt, den man dieses Jahr bei den besseren Agenten-Werkzeugen sieht: immer das Nebeneinander produzieren, weil das Modell einem bereitwillig erzählt, es habe funktioniert, und die einzige Verteidigung das Hinsehen ist.
Die Installation, an der die meisten hängen bleiben
Die Anforderungen sind spezifisch: eine NVIDIA-GPU mit CUDA, Python 3.11, Blender 5.x im PATH (oder eine BLENDER-Umgebungsvariable) und ein fal-Key, wenn man neue Clips erzeugen will.
git clone https://github.com/Patch-gg/anymove && cd anymove
python3.11 -m venv .venv
.venv/bin/pip install torch==2.11.0 --index-url https://download.pytorch.org/whl/cu128
.venv/bin/pip install -r requirements.txt
cp .env.example .env    # add your FAL_KEY
Beachten Sie den gepinnten Torch-Build und den expliziten CUDA-12.8-Index. Das ist kein Projekt, das mit dem Python läuft, das man gerade zufällig hat.
Der netteste Teil des Onboardings ist der CPU-only-Smoke-Test. Das Repo liefert die Gelenkerkennungen, die sein Reader für das Brüllen des Drachen bereits gefunden hat, sodass man das Rig anpassen kann, ohne 355MB Gewichte herunterzuladen oder Blender zu installieren:
mkdir -p runs/dragon/clips/roar
MOCAP_CREATURE=assets/dragon .venv/bin/python -m mocap.solve \
  examples/dragon_roar/det.npz \
  assets/dragon/rigged/rig_info.json \
  runs/dragon/clips/roar/motion.json
Etwa zwanzig Sekunden, und es gibt aus, wie gut die beiden Ansichten übereinstimmen – was die Diagnose ist, die man wirklich will, weil Uneinigkeit zwischen den Ansichten der Fehlerfall ist, dem die ganze Architektur ausgesetzt ist.
Der volle Weg, mit Mesh, trainiertem Reader und Clip der Beispielkreatur aus dem Release (13MB Mesh, 355MB Reader, 4MB Clip):
tools/fetch_examples.sh dragon --readers --clips
tools/prep.sh dragon && tools/rig.sh dragon
tools/capture.sh dragon runs/dragon/videos/roar/s1/h3max.mp4 roar
Und ein neuer Move für dieselbe Kreatur, der etwa 0.52 $ kostet, weil er zwei Clips filmt:
.venv/bin/python tools/make_prompt.py assets/dragon \
  "the dragon whips its tail from side to side, then stands still." \
  prompts/dragon/tailwhip.txt
tools/film.sh dragon tailwhip h3max 1,2
tools/capture.sh dragon runs/dragon/videos/tailwhip/s1/h3max.mp4 tailwhip
Was hier wirklich schwer ist
Retargeting. Gelenkpositionen zu gewinnen ist ein Problem; sie auf ein bestimmtes Rig mit bestimmter Knochenlänge und bestimmter Ruhepose abzubilden ein anderes. Hat das Rig des Drachen einen längeren Hals, als die gewonnenen Punkte nahelegen, knickt der Hals seltsam oder der Kopf schwebt. Die Formulierung der README – „das Rig landet auf den Punkten“ – deutet auf Fitting statt Retargeting hin, was die einfachere und ehrlichere Wahl ist: Die Animation ist nur so gut, wie die Proportionen des Rigs zum Clip passen.
Fußkontakt. Jede Mocap-Pipeline kämpft mit rutschenden Füßen, und eine Zwei-Ansichten-Lösung aus einem generierten Video hat keine Grundebene, keine Kraftdaten und keine physikalischen Randbedingungen. Ein Drache, der Schlittschuh läuft, ist ein Drache, der falsch aussieht, so gut die Gelenke auch sein mögen.
Verdeckung. Zwei Ansichten helfen, aber es sind nur zwei. Ein Gliedmaß, das in beiden Panels hinter dem Körper verborgen ist, muss erschlossen werden, und das Modell erfindet etwas Plausibles.
Die Ökonomie, und das ist die eigentliche Geschichte
Sechsundzwanzig Cent pro Clip. Unter einer Minute zum Lesen und Anpassen. Vier Beispielkreaturen im Repo, jede mit eigenem Rig, Prompts und Reader.
Vergleichen Sie das mit der Alternative: ein Animator, ein Tag, ein Revisionszyklus. Der Vergleich ist nicht fair – die Qualität ist nicht dieselbe, und niemand wird die Signaturbewegung einer Hauptfigur damit ausliefern. Aber für Hintergrundkreaturen, Feindvarianten, Crowd-Füllmaterial oder die vierzig Sekunden eines Trailers, in denen das Monster nur zwei Sekunden zu sehen ist, entfernen sechsundzwanzig Cent eine ganze Diskussion darüber, ob die Einstellung es wert ist.
Das ist das Muster dieses Jahres, wieder einmal. Nicht „KI ersetzt das Handwerk“. KI senkt die Kosten der Version, die man ohnehin weggeworfen hätte, und das Handwerk wandert zu den Entscheidungen, die überleben.
Sollte man es ausprobieren
Wer eine NVIDIA-Karte, eine Blender-Installation und ein Kreaturen-Rig hat, das ihm wichtig ist: ja – und mit dem CPU-Smoke-Test anfangen, nicht mit der vollen Pipeline. Er dauert zwanzig Sekunden und sagt, ob die beiden Ansichten auf den eigenen Daten übereinstimmen, und das ist die einzige Frage, die zählt, bevor man etwas ausgibt.
Auf einem Mac fällt das Reader-Training weg, und das Fitting bleibt theoretisch. Das Repo ist Apache-2.0, man kann es portieren. Ich würde es diesen Monat nicht tun.
Verwandte Artikel
Eine community-gepflegte Tabelle von Taps, die Werbung in chinesischen Android-Builds abschaltet
Es fasst das System nicht an, entsperrt nichts, flasht nichts. Es legt nur die Schalter um, die die Hersteller ohnehin vorgesehen haben. Der Preis ist eine Liste, die jemand weiterführen muss.
GPT Image 2.6 hielt den Tokenpreis und erhöhte die Rechnung
GPT Image 2.6 übernimmt jeden Tokenpreis von 2.5 und kostet pro Bild dennoch mehr, weil ein größerer Teil der Arbeit in Ausgabe-Token landet. Elf Tage nach dem Start sagt die Preisstruktur mehr als jede Rangliste.
Jemand hat IDM von außen nachgebaut und aufgeschrieben, was er nicht angefasst hat
Eine Rust-Neuimplementierung von Internet Download Manager verspricht 5x Tempo und 86 Sprachen. Das interessantere Dokument ist der Absatz, der erklärt, wie sie ohne jede Kopie entstanden ist.
Rune ist ein Rust-UI-Framework, das gebaut wurde, damit ein Agent seine eigene Arbeit prüfen kann
Rune rendert headless, gibt seinen Elementbaum aus und nimmt geskriptete Eingaben an. Damit bekommt ein Coding-Agent ein Signal zum Diffen, das ein Screenshot nie liefert. Das Framework ist Pre-Release und nimmt keine Pull Requests an.