
anymove: um vídeo em duas vistas vira criatura animada em GLB
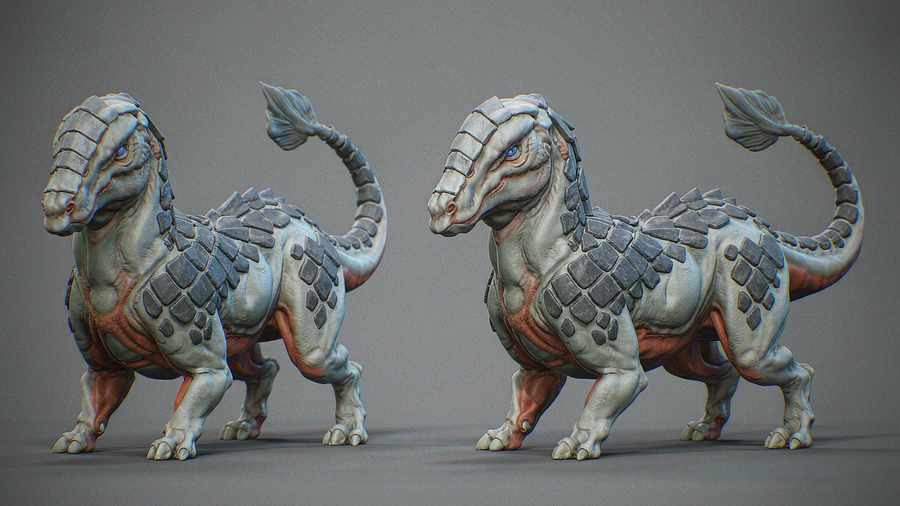
Captura de movimento tem um problema de escala que ninguém comenta, e não é o custo do traje. É que mocap é feito para humanos — duas pernas, esqueleto conhecido, altura de quadril padronizada — e no momento em que o personagem é um dragão, uma aranha gigante ou um demônio de fogo, o pipeline inteiro deixa de se aplicar.
Jogos e filmes resolvem isso com animadores. Um animador olha a referência e depois marca os membros da criatura à mão, frame a frame, porque a referência é um humano andando e o alvo é algo com seis pernas e cauda. Esse é o trabalho real. É também por isso que animação de criatura é um dos itens mais caros de uma produção que tem muitos.
anymove, do Patch, é uma tentativa de automatizar exatamente essa lacuna. Tem 452 estrelas, apareceu em 27 de outubro e faz uma coisa: transformar um único vídeo de criatura gerado por IA num GLB com rig e animação.
A parte interessante é o truque que ele usa para chegar lá, e o truque é sobre câmeras.
Duas vistas num só quadro
Mocap humano funciona porque várias câmeras veem o mesmo corpo de ângulos diferentes, e a interseção dessas linhas de visão dá uma posição 3D. Uma câmera dá uma posição 2D num plano, e um plano não é um corpo.
Você não pode colocar duas câmeras em volta de um clipe gerado por IA, porque o clipe não existe em 3D. É pixel.
Então o anymove pede ao modelo de vídeo algo meio esquisito: filmar a mesma criatura de frente e de lado, simultaneamente, no mesmo quadro. Um díptico — dois painéis lado a lado, uma criatura, dois pontos de vista, se movendo em sincronia.
Agora você tem duas linhas de visão de novo. A vista frontal dá X e Y. A lateral dá Z e Y. Cruze as duas e uma articulação tem posição 3D, recuperada de um vídeo plano, sem modelo de profundidade e sem rig multi-câmera.
O repositório se chamava diptych, e a troca para anymove faz sentido como decisão de produto, mas o nome antigo descrevia o mecanismo com mais honestidade. O quadro de dois painéis é a invenção. O resto é encanamento.
O pipeline, etapa por etapa
Gerar o clipe. Um vídeo de IA por movimento. O README coloca em US$ 0.26 por clipe — os demos do dragão, da aranha gigante, do demônio de fogo e do lobo foram feitos assim. O prompt precisa manter a composição em díptico estável, e é aqui que a abordagem inteira pode falhar: se o modelo desloca o enquadramento entre os painéis, as duas vistas deixam de corresponder e a triangulação vira lixo.
Ler as articulações. Um leitor baseado em DINOv2 encontra cada articulação nas duas vistas. É o modelo que você treina, e é a parte cara — 24GB de VRAM para treinar. A leitura, depois, precisa de bem menos.
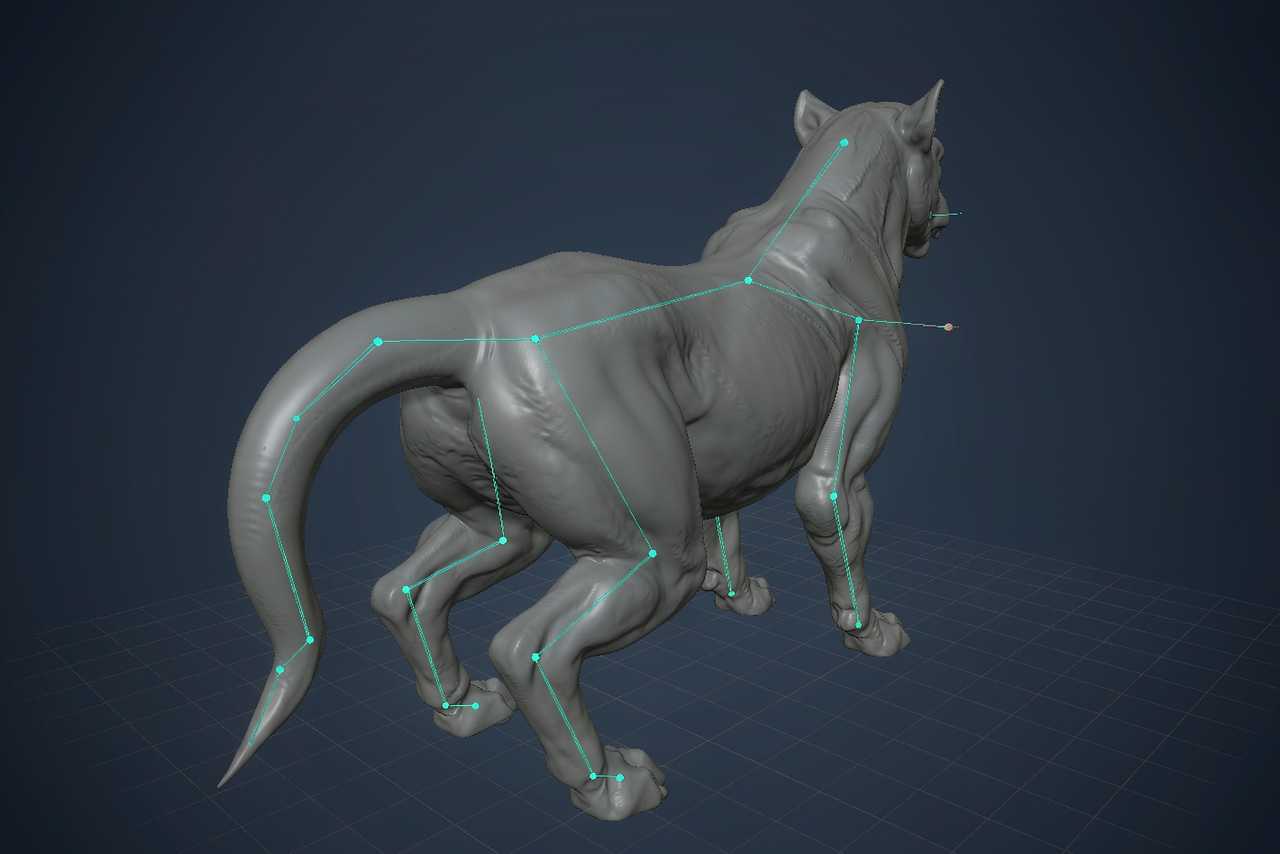
Ajustar o rig. As duas vistas “se levantam como paredes e prendem cada articulação em 3D”, na imagem do README. O rig é então ajustado aos pontos recuperados. A saída é animação de ossos, não nuvem de pontos, e é isso que a torna utilizável adiante.
Exportar. Um GLB, mais um showcase.mp4 que põe a animação ao lado do clipe de origem para você comparar sem se enganar.
Esse último artefato é o mesmo instinto que aparece nas melhores ferramentas de agente deste ano: produza sempre o lado a lado, porque o modelo vai dizer com tranquilidade que deu certo e a única defesa é olhar.
A instalação, que é onde a maioria vai parar
Os requisitos são específicos: GPU NVIDIA com CUDA, Python 3.11, Blender 5.x no PATH (ou uma variável BLENDER) e uma chave da fal se você quiser criar clipes novos.
git clone https://github.com/Patch-gg/anymove && cd anymove
python3.11 -m venv .venv
.venv/bin/pip install torch==2.11.0 --index-url https://download.pytorch.org/whl/cu128
.venv/bin/pip install -r requirements.txt
cp .env.example .env    # add your FAL_KEY
Repare na build de torch fixada e no índice CUDA 12.8 explícito. Não é um projeto que vai funcionar com o Python que você tiver por aí.
A melhor parte do onboarding é o teste de fumaça só em CPU. O repositório traz as detecções de articulação que o leitor já encontrou para o rugido do dragão, então você ajusta o rig sem baixar 355MB de pesos nem instalar Blender:
mkdir -p runs/dragon/clips/roar
MOCAP_CREATURE=assets/dragon .venv/bin/python -m mocap.solve \
  examples/dragon_roar/det.npz \
  assets/dragon/rigged/rig_info.json \
  runs/dragon/clips/roar/motion.json
Cerca de vinte segundos, e ele imprime o quão bem as duas vistas concordam — que é o diagnóstico que você realmente quer, porque discordância entre vistas é o modo de falha a que a arquitetura inteira está exposta.
O caminho completo, com a malha da criatura de exemplo, o leitor treinado e o clipe do release (13MB de malha, 355MB de leitor, 4MB de clipe):
tools/fetch_examples.sh dragon --readers --clips
tools/prep.sh dragon && tools/rig.sh dragon
tools/capture.sh dragon runs/dragon/videos/roar/s1/h3max.mp4 roar
E um movimento novo para a mesma criatura, que custa cerca de US$ 0.52 porque filma dois clipes:
.venv/bin/python tools/make_prompt.py assets/dragon \
  "the dragon whips its tail from side to side, then stands still." \
  prompts/dragon/tailwhip.txt
tools/film.sh dragon tailwhip h3max 1,2
tools/capture.sh dragon runs/dragon/videos/tailwhip/s1/h3max.mp4 tailwhip
O que é genuinamente difícil aqui
Retargeting. Recuperar posições de articulação é um problema; mapeá-las para um rig específico, com comprimento de osso e pose de repouso específicos, é outro. Se o rig do dragão tem pescoço mais longo que os pontos recuperados sugerem, ou o pescoço dobra estranho ou a cabeça flutua. A formulação do README — “o rig pousa nos pontos” — sugere ajuste em vez de retargeting, que é a escolha mais fácil e mais honesta: a animação só é tão boa quanto as proporções do rig corresponderem ao clipe.
Contato do pé com o chão. Todo pipeline de mocap sofre com pé deslizando, e uma solução de duas vistas a partir de vídeo gerado não tem plano de chão, nem dados de força, nem restrições físicas. Um dragão que patina é um dragão que parece falso, não importa quão boas sejam as articulações.
Oclusão. Duas vistas ajudam, mas são só duas. Um membro escondido atrás do corpo nos dois painéis tem que ser inferido, e o modelo vai inventar algo plausível.
A economia, que é a história de verdade
Vinte e seis centavos por clipe. Menos de um minuto para ler e ajustar. Quatro criaturas de exemplo no repositório, cada uma com o próprio rig, prompts e leitor.
Compare com a alternativa: um animador, um dia, um ciclo de revisão. A comparação não é justa — a saída não tem a mesma qualidade, e ninguém vai lançar o movimento assinatura de um personagem principal com isso. Mas para criaturas de fundo, variantes de inimigo, enchimento de multidão ou os quarenta segundos de um trailer em que o monstro aparece por dois, vinte e seis centavos eliminam uma discussão inteira sobre se vale fazer o plano.
É o padrão deste ano, de novo. Não “a IA substitui o ofício”. A IA derruba o custo da versão que você ia jogar fora, e o ofício sobe para as decisões que sobrevivem.
Vale testar
Se você tem uma placa NVIDIA, um Blender instalado e um rig de criatura com que se importa, sim — e comece pelo teste de fumaça em CPU, não pelo pipeline completo. Leva vinte segundos e diz se as duas vistas concordam nos seus dados, que é a única pergunta que importa antes de gastar qualquer coisa.
Se você está no Mac, o treino do leitor está fora e o ajuste é teórico. O repositório é Apache-2.0, então dá para portar. Eu não portaria, este mês.
Artigos relacionados
Uma planilha comunitária de toques que desliga os anúncios dos Android chineses
Não mexe no sistema, não desbloqueia nada, não faz flash de nada. Só vira os botões que os fabricantes já deixaram à mostra. O preço é uma lista que alguém precisa continuar escrevendo.
GPT Image 2.6 manteve o preço por token e elevou a fatura
O GPT Image 2.6 mantém cada tarifa por token do 2.5 e mesmo assim custa mais por imagem, porque boa parte do trabalho acontece agora nos tokens de saída. Onze dias após o lançamento, a estrutura de preços diz mais que o ranking.
Alguém reconstruiu o IDM por fora e anotou o que não tocou
Uma reimplementação em Rust do Internet Download Manager promete 5 vezes a velocidade e 86 idiomas. O documento mais interessante é o parágrafo que explica como ela foi feita sem copiar nada.
Rune é um framework de UI em Rust feito para que um agente possa verificar o próprio trabalho
Rune renderiza sem interface, despeja sua árvore de elementos e aceita entrada roteirizada, o que dá a um agente de código um sinal diffável que um screenshot nunca oferece. O framework está em pré-lançamento e não aceita pull requests.