
anymove : deux vues dans une seule image pour animer une créature
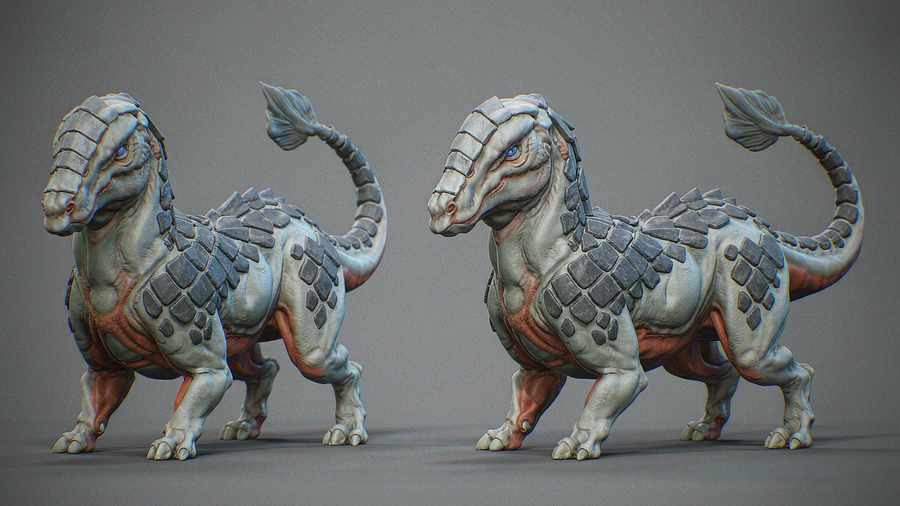
La motion capture a un problème de passage à l'échelle dont personne ne parle, et ce n'est pas le prix de la combinaison. C'est que la mocap est conçue pour des humains — deux jambes, un squelette connu, une hauteur de bassin standard — et dès que votre personnage est un dragon, une araignée géante ou un démon de feu, tout le pipeline cesse de s'appliquer.
Jeux et films résolvent ça avec des animateurs. Un animateur regarde une référence, puis anime les membres d'une créature à la main, image par image, parce que la référence est un humain qui marche et la cible est une chose à six pattes avec une queue. C'est le vrai métier. C'est aussi pourquoi l'animation de créature est l'un des postes les plus chers d'une production qui en compte beaucoup.
anymove, de Patch, tente d'automatiser précisément cet écart. Il compte 452 étoiles, il est apparu le 27 octobre, et il fait une chose : transformer une vidéo de créature générée par IA en GLB riggé et animé.
La partie intéressante, c'est l'astuce employée pour y arriver, et cette astuce concerne les caméras.
Deux vues dans une seule image
La mocap humaine fonctionne parce que plusieurs caméras voient le même corps sous des angles différents, et l'intersection de ces lignes de visée donne une position 3D. Une caméra donne une position 2D sur un plan, et un plan n'est pas un corps.
On ne peut pas placer deux caméras autour d'un clip généré par IA, parce que le clip n'existe pas en 3D. Ce sont des pixels.
anymove demande donc au modèle vidéo quelque chose d'un peu étrange : filmer la même créature de face et de profil, simultanément, dans la même image. Un diptyque — deux panneaux côte à côte, une créature, deux points de vue, en mouvement synchrone.
Vous avez de nouveau deux lignes de visée. La vue de face donne X et Y. La vue de profil donne Z et Y. Intersectez-les et une articulation a une position 3D, récupérée depuis une vidéo plate, sans modèle de profondeur et sans dispositif multi-vues.
Le dépôt s'appelait à l'origine diptych, et le renommage en anymove se défend comme décision produit, mais l'ancien nom décrivait le mécanisme plus honnêtement. L'image à deux panneaux est l'invention. Le reste, c'est de la plomberie.
Le pipeline, étape par étape
Générer le clip. Une vidéo IA par mouvement. Le README l'estime à 0,26 $ le clip — les démos du dragon, de l'araignée géante, du démon de feu et du loup ont toutes été faites ainsi. Le prompt doit maintenir la composition en diptyque stable, et c'est le seul endroit où toute l'approche peut échouer : si le modèle dérive le cadrage entre les panneaux, les deux vues cessent de correspondre et la triangulation est bonne à jeter.
Lire les articulations. Un lecteur fondé sur DINOv2 trouve chaque articulation dans les deux vues. C'est le modèle qu'on entraîne, et c'est la partie chère — 24 Go de VRAM pour l'entraînement. La lecture, ensuite, demande beaucoup moins.
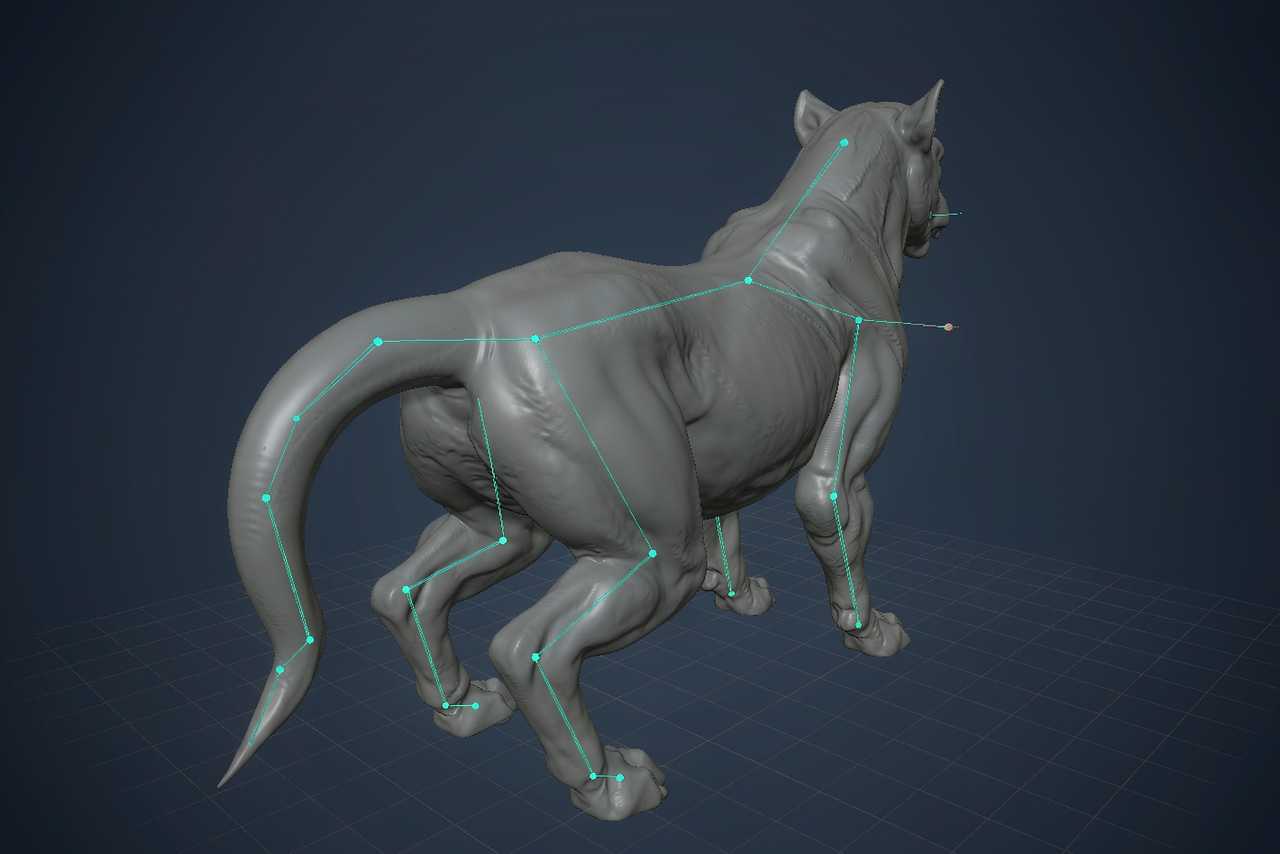
Ajuster le rig. Les deux vues « se dressent comme des murs et épinglent chaque articulation en 3D », pour reprendre l'image du README. Le rig est ensuite ajusté aux points récupérés. La sortie est une animation d'os, pas un nuage de points, et c'est ce qui la rend utilisable en aval.
Exporter. Un GLB, plus un showcase.mp4 qui place l'animation à côté du clip source pour que vous puissiez comparer sans vous mentir.
Ce dernier artefact relève du même instinct que dans les meilleurs outils d'agent cette année : toujours produire le côte à côte, parce que le modèle vous dira volontiers qu'il a réussi et que la seule défense est de regarder.
L'installation, où la plupart des gens s'arrêteront
Les prérequis sont précis : un GPU NVIDIA avec CUDA, Python 3.11, Blender 5.x dans votre PATH (ou une variable d'environnement BLENDER), et une clé fal si vous voulez fabriquer de nouveaux clips.
git clone https://github.com/Patch-gg/anymove && cd anymove
python3.11 -m venv .venv
.venv/bin/pip install torch==2.11.0 --index-url https://download.pytorch.org/whl/cu128
.venv/bin/pip install -r requirements.txt
cp .env.example .env    # add your FAL_KEY
Notez la version de torch épinglée et l'index CUDA 12.8 explicite. Ce n'est pas un projet qui fonctionnera avec le Python que vous avez sous la main.
Le meilleur moment d'onboarding est le test de fumée sur CPU seul. Le dépôt fournit les détections d'articulations que son lecteur a déjà trouvées pour le rugissement du dragon, donc vous pouvez ajuster le rig sans télécharger 355 Mo de poids ni installer Blender :
mkdir -p runs/dragon/clips/roar
MOCAP_CREATURE=assets/dragon .venv/bin/python -m mocap.solve \
  examples/dragon_roar/det.npz \
  assets/dragon/rigged/rig_info.json \
  runs/dragon/clips/roar/motion.json
Une vingtaine de secondes, et il affiche à quel point les deux vues sont d'accord — ce qui est exactement le diagnostic qu'on veut, puisque le désaccord entre vues est le mode de panne auquel toute l'architecture est exposée.
Le chemin complet, avec le maillage de la créature d'exemple, le lecteur entraîné et le clip de la release (maillage 13 Mo, lecteur 355 Mo, clip 4 Mo) :
tools/fetch_examples.sh dragon --readers --clips
tools/prep.sh dragon && tools/rig.sh dragon
tools/capture.sh dragon runs/dragon/videos/roar/s1/h3max.mp4 roar
Et un nouveau mouvement pour la même créature, qui coûte environ 0,52 $ parce qu'il filme deux clips :
.venv/bin/python tools/make_prompt.py assets/dragon \
  "the dragon whips its tail from side to side, then stands still." \
  prompts/dragon/tailwhip.txt
tools/film.sh dragon tailwhip h3max 1,2
tools/capture.sh dragon runs/dragon/videos/tailwhip/s1/h3max.mp4 tailwhip
Ce qui est vraiment difficile ici
Le retargeting. Récupérer des positions d'articulations est un problème ; les projeter sur un rig précis, avec une longueur d'os précise et une pose de repos précise, en est un autre. Si le rig du dragon a un cou plus long que ne le suggèrent les points récupérés, soit le cou se plie bizarrement, soit la tête flotte. La formulation du README — « le rig se pose sur les points » — suggère un ajustement plutôt qu'un retargeting, ce qui est le choix le plus simple et le plus honnête : l'animation ne vaut que ce que valent les proportions du rig face à celles du clip.
Le contact au sol. Tous les pipelines de mocap se battent contre les pieds qui glissent, et une résolution à deux vues depuis une vidéo générée n'a ni plan de sol, ni données de force, ni contraintes physiques. Un dragon qui patine est un dragon qui a l'air faux, quelle que soit la qualité des articulations.
L'occlusion. Deux vues aident, mais seulement deux. Un membre caché derrière le corps dans les deux panneaux doit être inféré, et le modèle inventera quelque chose de plausible.
L'économie, la vraie histoire
Vingt-six centimes par clip. Moins d'une minute pour lire et ajuster. Quatre créatures d'exemple dans le dépôt, chacune avec son rig, ses prompts et son lecteur.
Comparez avec l'alternative : un animateur, une journée, et un cycle de révision. La comparaison n'est pas honnête — la sortie n'est pas de même qualité, et personne ne livrera le mouvement signature d'un personnage principal avec ça. Mais pour des créatures de décor, des variantes d'ennemis, de la figuration de foule, ou les quarante secondes d'une bande-annonce où le monstre n'est à l'écran que deux, vingt-six centimes suppriment tout un débat sur l'intérêt de tourner le plan.
C'est encore le motif de cette année. Pas « l'IA remplace le métier ». L'IA effondre le coût de la version que vous alliez jeter, et le métier remonte vers les décisions qui survivent.
Faut-il essayer
Si vous avez une carte NVIDIA, un Blender installé et un rig de créature qui vous tient à cœur, oui — et commencez par le test de fumée CPU, pas par le pipeline complet. Il prend vingt secondes et vous dit si les deux vues sont d'accord sur vos données, ce qui est la seule question qui compte avant de dépenser quoi que ce soit.
Si vous êtes sur Mac, l'entraînement du lecteur est hors de portée et l'ajustement reste théorique. Le dépôt est en Apache-2.0, donc vous pouvez le porter. Je ne le ferais pas, ce mois-ci.
Articles associés
Une feuille de calcul communautaire de clics pour couper les publicités des Android chinois
Il ne touche pas au système, ne déverrouille rien, ne flashe rien. Il bascule un à un les interrupteurs que les fabricants ont déjà prévus. Le prix à payer, c'est la liste qu'il faut continuer d'écrire.
GPT Image 2.6 a tenu le prix des tokens et fait monter la facture
GPT Image 2.6 reprend chaque tarif au token de 2.5 et coûte malgré tout plus cher par image, parce qu'une part plus grande du travail se paie en tokens de sortie. Onze jours après le lancement, la grille tarifaire dit plus que le classement.
Quelqu'un a reconstruit IDM de l'extérieur et a écrit ce qu'il n'a pas touché
Une réimplémentation en Rust d'Internet Download Manager revendique 5 fois la vitesse et 86 langues. Le document le plus intéressant est le paragraphe qui explique comment elle a été construite sans rien copier.
Rune est un framework UI Rust conçu pour qu'un agent puisse vérifier son propre travail
Rune rend en headless, vide son arbre d'éléments et accepte des entrées scriptées, ce qui donne à un agent de codage un signal différable qu'aucune capture d'écran ne fournit. Le framework est en préversion et n'accepte pas de pull requests.