
子智能体经济:为什么廉价模型才是智能体故事的核心
十月上旬最具影响力的 AI 发布,是最便宜的那一个。10 月 7 日,Anthropic 推出了 Claude Haiku 5.5,并表示其平均运行成本比上一代 Haiku 低约 75%。对于低于 100,000 个 token 的请求,API 价格下降了约 90%,降至每百万输入 token 十美分、每百万输出 token 五十美分。Anthropic 还将 Sonnet 5.5 的缓存读取价格减半。
廉价模型很容易被轻视。它们看起来像是定价策略,而不是能力故事。但这次发布中有趣的细节并不是价格,而是 Haiku 5.5 的用途。
小模型长大了
过去对小模型的批评是:它们做简单任务还行,面对真正有用的任务却派不上用场。这一差距已经迅速缩小。在 Terminal-Bench 编码评估中,Haiku 4.5 得分为零,Haiku 5.5 得分 39.2%。在测试通过界面操作计算机的 OSWorld 上,它从 15.7% 提升到 72.4%,超过了同类的 GPT-6 Luna(48.9%)。
Anthropic 还首次为 Haiku 系列加入了可调节的推理强度,提供从低到最高的五个级别。这让开发者可以把算力花在有用之处,在不需要时跳过,这是一个小功能,却对持续运行某件事的成本有很大影响。
子智能体定位
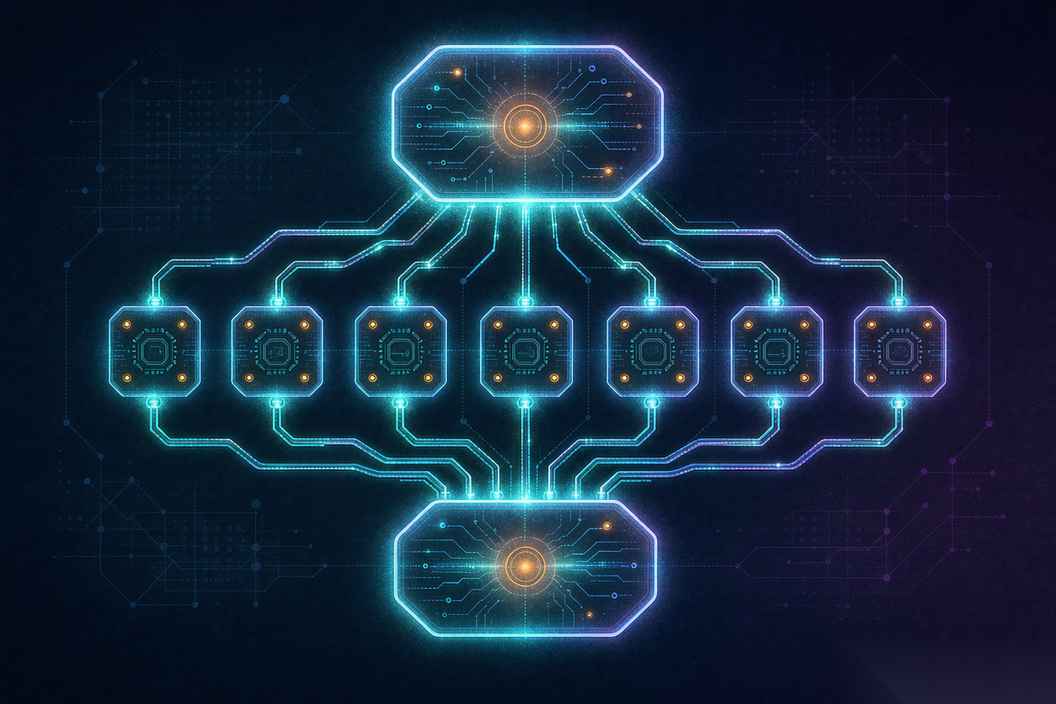
这次发布中值得强调的部分是定位。Anthropic 表示,Haiku 5.5 可以作为更大的 Opus 5.5 和 Sonnet 5.5 的子智能体。直白地说,旗舰模型负责规划和决策,Haiku 负责干活:整理文档、操作计算机、处理数据。
这是一次真正的架构转变,也重新定义了成本讨论。不只是每次调用更便宜,而是一次昂贵的规划调用现在可以分支出许多廉价的执行调用。过去每一步都跑一个旗舰模型的智能体,现在可以在困难部分用旗舰模型,其他所有部分用 Haiku。账单下降的幅度可能超过每 token 折扣所暗示的程度,因为你改变的是昂贵调用总共发生多少次。
Anthropic 的竞争对手们正从不同角度汇聚到同一种形态。谷歌于 10 月 1 日推出的 Gemini 4 Argon 面向编码、研究、金融和法律工作,并支持最高一百万 token 的输出,用于大型审阅。OpenAI 的中端模型一直在降价以守住阵地。发布宣传各不相同,但底层的押注是一致的:这项工作不是由一个模型回答一个问题,而是许多次调用被编排起来,而编排者需要廉价的手。
为什么瓶颈转移了
有一个数字解释了这种紧迫性。追踪该领域的分析师估计,2026 年全球日活跃智能体约为 7900 万个,高于前一年的约 2900 万个,并预计到 2030 年将达到数十亿。无论确切数字如何,方向都很清楚。智能体正从演示走向生产,而阻碍生产级智能体的原因,很少是模型太笨,而是运行足够多次的成本太高。
这就是为什么行业开始谈论编排层:它把请求拆解成步骤,将每一步路由到合适的模型,并组装结果。当基础模型变得更便宜时,这一层会变得更有价值,而不是更没价值,因为正是它决定廉价模型该被用在哪里。
一条链实际上如何拆分工作
关于子智能体的抽象讨论,放到具体任务上会更清楚。假设你让一个智能体研究某个市场并生成一份简报。旗舰模型读取请求,决定要查找什么,并规划步骤。然后小模型来做苦活:访问页面、提取数字、重新格式化表格、对来源去重,并检查每条论断都有引用。旗舰模型最后回来撰写综合内容,并判断草稿是否足够好。两端各一次昂贵调用,中间许多次廉价调用。
这种模式会在各种任务中重复。任何高吞吐、低歧义的事情都适合交给廉价模型:填写表格、读取日志、对支持工单分类、检查文档是否符合模板。任何需要判断下一步做什么的事情,仍然留给旗舰模型。这条分界线并非固定不变,而当前有趣的工程工作,就是为每个工作流决定它该划在哪里。
Anthropic 的可调节推理强度在这里非常契合。需要轻量处理的任务可以用低强度运行,需要更谨慎的任务则可以在不切换模型的情况下调高。在实践中,这意味着同一个廉价模型既能服务于快速分类,也能服务于仔细审阅,从而减少团队需要管理的活动部件。
降价如何改变产品
更便宜的执行会改变哪些产品值得构建。当每次运行都要花真金白银时,对每条传入消息都运行一个智能体的功能毫无意义。当一次运行只花不到一美分时,它就说得通了。结果是涌现出一波功能:过去一年技术上可行,但直到现在在经济上不可能,比如常开监控、逐项富化、检查每个产物而非抽样的后台审核员。
这里有一个陷阱,而且很容易掉进去。当执行变便宜时,团队就不再衡量它。一个每天运行一千次廉价调用的工作流,从单次调用看似乎无害,但一旦把重试、失败和升级到昂贵模型计算在内,每月账单仍可能高得惊人。真正重要的数字是完成一个任务的成本,而不是单次调用的成本。
小模型的基准测试问题
小模型在基准测试上越来越好,而基准测试恰恰是最容易高估进步的地方。一个操作计算机测试中的亮眼分数说明模型可以遵循已知的界面操作序列。它远远不能说明模型是否知道何时停止、何时求助,或任务何时已经悄悄出错。这些行为正是廉价智能体在生产中失败的地方,而且很难评分。
实际的防御措施并不光鲜。给廉价子智能体一个狭窄的工作、清晰的定义完成标准,以及一种升级而不是猜测的方式。然后观察它在一周内如何处理边缘情况,再把任何重要的事情交给它。一个知道自己任务边界的廉价模型,比一个会即兴发挥的聪明模型更有用。
诚实的注意事项
一个自信却出错的廉价模型,比一个昂贵模型更糟,而智能体链会放大这种风险。每一个额外步骤都是错误进入并传播的地方。每 token 价格完全不能说明廉价模型是否像人一样处理了模糊指令。
还有一个尚未弥合的治理缺口。NIST 和 CISA 在九月下旬的指南将智能体视为低信任的非人类身份,并要求使用短期凭证、维护清单,以及对较高风险操作进行人工批准。大多数组织既没有清单,也没有审批流程。廉价执行让运行许多智能体变得更容易,也让知道有多少智能体正在运行变得更难。
如果你在做构建,这意味着什么
现在值得养成的有用习惯,是不要再默认伸手去拿最大的模型。把任务拆成规划和执行,把旗舰模型花在需要判断的地方,其余路由给小模型。衡量整条链,而不是单次调用。
Haiku 5.5 之所以成为故事,不是因为它便宜,而是因为廉价层级终于好到足以承担智能体中过去需要昂贵模型的部分。
相关文章
Decagon 的 PACT 协议,想让「同意」成为一个标准
Decagon 开源了一个协议,用来验证个人智能体的身份,以及客户授予它的权限。这是管道工程,而它决定了智能体经济能不能跑起来。
AI「重逢」热潮:一场还没想好该如何感受的讨论
AI 致敬短片把逝去的公众人物带回中国荧幕,拿下数十万点赞。然后反弹来了,而它争论的是「同意」。
Apple 发布了一个开源多模态模型,却几乎没告诉任何人
苹果的这次「研究优先」式发布悄然越过了主流视野,但模型那种细粒度的视觉 grounding,透露了它的 AI 栈正走向哪里。
OpenCut 与「开源剪映」的那一刻
一款免费、MIT 许可的视频剪辑器持续冲上 GitHub 趋势榜,而它的路线图里包含一个面向 AI 智能体的 MCP server。围绕 AI 媒体的工具,正在追上模型本身。