
A economia dos subagentes: por que modelos baratos são a verdadeira história dos agentes
O lançamento de IA mais consequente do início de outubro foi o mais barato. Em 7 de outubro, a Anthropic lançou o Claude Haiku 5.5 e disse que seu custo médio de execução era cerca de 75% menor que o do Haiku anterior. Para requisições abaixo de 100.000 tokens, o preço da API caiu cerca de 90%, para dez centavos por milhão de tokens de entrada e cinquenta centavos por milhão de saída. A Anthropic também cortou pela metade o preço de leitura de cache no Sonnet 5.5.
Modelos baratos são fáceis de descartar. Parecem uma jogada de preço, não uma história de capacidade. Mas o detalhe interessante deste lançamento não é o preço. É para que serve o Haiku 5.5.
O modelo pequeno cresceu
A antiga crítica aos modelos pequenos era que eles serviam para tarefas simples e eram inúteis para as reais. Essa lacuna diminuiu rápido. Na avaliação de programação Terminal-Bench, o Haiku 4.5 marcou zero. O Haiku 5.5 marcou 39,2%. No OSWorld, que testa a operação de um computador por sua interface, ele passou de 15,7% para 72,4%, à frente do comparável GPT-6 Luna, com 48,9%.
A Anthropic também deu ao Haiku o primeiro esforço de raciocínio ajustável da linha, com cinco níveis, de baixo a máximo. Isso permite ao desenvolvedor gastar computação onde ela ajuda e pulá-la onde não ajuda, um recurso pequeno com grande efeito sobre o custo de executar algo continuamente.
O enquadramento de subagente
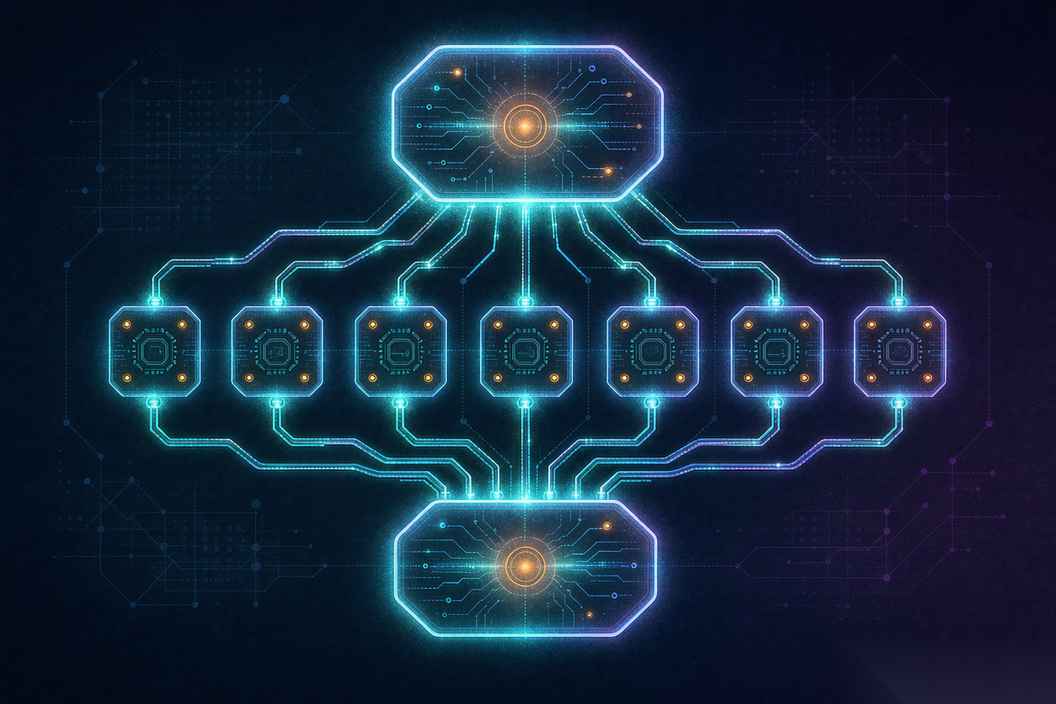
A parte do lançamento que vale sublinhar é o posicionamento. A Anthropic disse que o Haiku 5.5 pode servir como subagente para os maiores Opus 5.5 e Sonnet 5.5. Em termos simples, um modelo de ponta planeja e decide, e o Haiku faz o trabalho: organizar documentos, operar um computador, lidar com dados.
Isso é uma mudança arquitetural real, e reenquadra a conversa sobre custo. Não é só que cada chamada é mais barata. É que uma chamada cara de planejamento agora pode se desdobrar em muitas chamadas baratas de execução. Um agente que costumava rodar um modelo de ponta em cada etapa pode rodar um modelo de ponta para a parte difícil e o Haiku para todo o resto. A conta pode cair mais do que o desconto por token sugere, porque você está mudando quantas chamadas caras acontecem.
Os rivais da Anthropic estão convergindo para o mesmo formato por outros ângulos. O Gemini 4 Argon, do Google, lançado em 1º de outubro, é voltado para programação, pesquisa, finanças e trabalho jurídico, e suporta saída de até um milhão de tokens para grandes revisões. Os modelos de médio porte da OpenAI vêm cortando preços para manter terreno. A mensagem de lançamento difere, mas a aposta de fundo é compartilhada: o trabalho não é um modelo respondendo a uma pergunta. São muitas chamadas, orquestradas, e o orquestrador precisa de mãos baratas.
Por que o gargalo se moveu
Há um número que explica a urgência. Analistas que acompanham o setor estimam cerca de 79 milhões de agentes ativos diários no mundo em 2026, ante cerca de 29 milhões no ano anterior, com projeções de bilhões até 2030. Qualquer que seja o número exato, a direção é clara. Os agentes estão passando de demonstrações para produção, e o que trava um agente em produção raramente é o modelo ser burro demais. É que executá-lo vezes suficientes custa caro demais.
É por isso que o setor começou a falar da camada de orquestração, a peça que divide uma requisição em etapas, encaminha cada etapa para um modelo adequado e monta o resultado. Quando os modelos de base ficam mais baratos, essa camada se torna mais valiosa, não menos, porque é ela que decide onde o modelo barato entra.
Como uma cadeia realmente divide o trabalho
A conversa abstrata sobre subagentes fica mais clara com um trabalho concreto. Suponha que você peça a um agente para pesquisar um mercado e produzir um relatório. O modelo de ponta lê a requisição, decide o que procurar e planeja as etapas. Um modelo pequeno então faz o trabalho pesado: visita páginas, extrai números, reformata tabelas, deduplica fontes e verifica se cada afirmação tem uma citação. O modelo de ponta volta no final para escrever a síntese e decidir se o rascunho está bom o suficiente. Uma chamada cara em cada ponta, muitas chamadas baratas no meio.
Esse padrão se repete entre tarefas. Qualquer coisa de alto volume e baixa ambiguidade é candidata ao modelo barato: preencher formulários, ler logs, classificar tickets de suporte, verificar se um documento corresponde a um modelo. Qualquer coisa que exija julgamento sobre o que fazer em seguida fica com o modelo de ponta. A linha não é fixa, e o trabalho de engenharia interessante agora é decidir onde ela fica para cada fluxo de trabalho.
O esforço de raciocínio ajustável da Anthropic se encaixa perfeitamente aqui. Uma tarefa que precisa de um toque leve pode rodar com esforço baixo, e uma que precisa de mais cuidado pode ser elevada sem trocar de modelo. Na prática, isso significa que o mesmo modelo barato pode atender tanto a uma classificação rápida quanto a uma revisão cuidadosa, o que reduz quantas peças móveis uma equipe precisa gerenciar.
O que o corte de preço muda nos produtos
Execução mais barata muda quais produtos valem a pena construir. Um recurso que roda um agente em cada mensagem recebida não fazia sentido quando cada execução custava dinheiro de verdade. Faz sentido quando a execução custa uma fração de centavo. O resultado é uma onda de recursos que eram tecnicamente possíveis há um ano e economicamente impossíveis até agora: monitores sempre ativos, enriquecimento por item, revisores em segundo plano que verificam cada artefato em vez de uma amostra.
Há uma armadilha nisso, e é fácil cair nela. Quando a execução é barata, as equipes param de medi-la. Um fluxo de trabalho que roda mil chamadas baratas por dia parece inofensivo por chamada e ainda pode somar uma conta mensal surpreendente quando tentativas repetidas, falhas e escalonamento para um modelo caro entram na conta. O número que importa é o custo de uma tarefa concluída, não o custo de uma única chamada.
O problema dos benchmarks com modelos pequenos
Modelos pequenos estão melhorando em benchmarks, e benchmarks são exatamente onde a melhoria é mais fácil de superinterpretar. Uma pontuação de manchete em um teste de operação de computador diz que o modelo consegue seguir uma sequência conhecida de passos de interface. Diz muito menos sobre se o modelo sabe quando parar, quando pedir ajuda ou quando uma tarefa deu errado silenciosamente. Esses comportamentos são onde agentes baratos falham em produção, e são difíceis de pontuar.
A defesa prática é pouco glamourosa. Dê a um subagente barato um trabalho estreito, uma definição clara de concluído e uma forma de escalar em vez de adivinhar. Depois observe o que ele faz nos casos extremos por uma semana antes de confiar nele para algo que importa. Um modelo barato que conhece os limites de sua tarefa é mais útil que um modelo esperto que improvisa.
As ressalvas honestas
Um modelo barato que é confiante e erra é pior que um caro, e cadeias de agentes multiplicam esse risco. Cada etapa adicional é um lugar para um erro entrar e se propagar. O preço por token não diz nada sobre se o modelo barato lidou com uma instrução ambígua como uma pessoa faria.
Há também uma lacuna de governança que não foi fechada. Orientações do NIST e da CISA no final de setembro tratam agentes como identidades não humanas de baixa confiança e pedem credenciais de curta duração, inventários mantidos e aprovação humana para ações de maior risco. A maioria das organizações não tem nem os inventários nem os fluxos de aprovação. Execução barata torna mais fácil rodar muitos agentes e mais difícil saber quantos estão rodando.
O que isso significa se você constrói
O hábito útil a cultivar agora é parar de recorrer ao maior modelo por padrão. Mapeie uma tarefa em planejamento e execução, gaste o modelo de ponta onde o julgamento é necessário e encaminhe o resto para um modelo pequeno. Meça a cadeia inteira, não uma única chamada.
O Haiku 5.5 não é a história por ser barato. É a história porque a camada barata finalmente ficou boa o suficiente para carregar as partes de um agente que antes precisavam da camada cara.
Artigos relacionados
O protocolo PACT da Decagon quer tornar o consentimento um padrao
A Decagon abriu um protocolo para verificar a identidade de um agente pessoal e as permissoes que um cliente concedeu. E encanamento, e decide se a economia dos agentes funciona.
A onda de reencontros com IA: um debate que a China ainda nao sabe como sentir
Filmes de homenagem feitos com IA trouxeram figuras falecidas de volta as telas chinesas e renderam centenas de milhares de curtidas. Depois veio a reacao, e era sobre consentimento.
A Apple publicou um modelo multimodal aberto e quase nao avisou
Este lancamento voltado a pesquisa passou despercebido, mas seu ancoramento visual de grao fino diz muito sobre para onde vai a pilha de IA da Apple.
OpenCut e o momento do CapCut de codigo aberto
Um editor de video gratuito com licenca MIT continua subindo nas tendencias do GitHub, e seu roteiro inclui um servidor MCP para agentes de IA. As ferramentas em torno da midia com IA estao alcancando os modelos.