
Physicl 賣出 10,000 個房間,機器人要的是那些角落
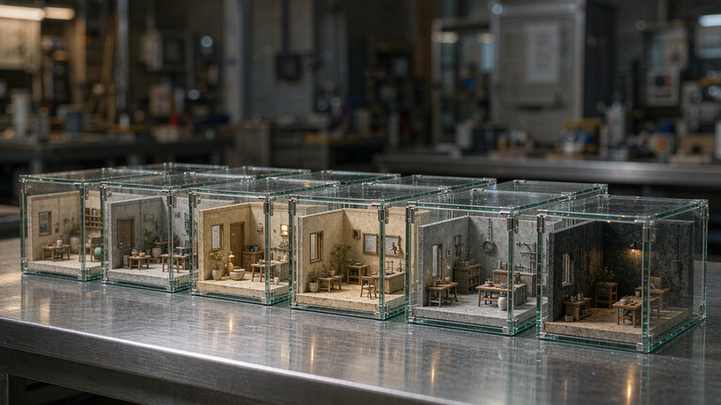
Physicl 在 11 月 6 日完成 $10 million 種子輪募資,由 Inovia Capital 領投,US Venture Partners 參與。同一天,它開放 Studio 測試版,這套應用程式用來生成 3D 場景,再匯出成訓練資料。
聽起來跟另外十幾家公司沒什麼不同,直到你看清楚 Studio 到底交付什麼。10,000 個預先建好的 3D 環境。100,000 個可以擺放、替換、重新排列的物件資產。光照、材質、攝影機路徑都能調。而且每個場景都帶著標籤一起出來:深度圖、物件分割、攝影機位置。
標籤才是產品,畫面只是包裝。
檯面上的那只杯子
創辦人暨執行長 Alex de Vigan 用一間廚房說明客戶是誰。家用機器人認得出乾淨檯面上的杯子。可是在它前面堆點雜物,或者太陽下山、屋裡的影子變了,同一台機器人就看不見了。
這門生意就是為了這種失敗而存在,為什麼一直沒人解決也不難懂。一只杯子放在乾淨檯面上的資料集,收集起來很便宜。同一個杯子,11 月下午 4 點 40 分,擋在麥片盒後面,廚房西邊還有一扇窗,這種資料集布置起來極貴,在真實世界裡幾乎找不到。
Physicl 的說法是:你用日常語言描述那間廚房,調整參數直到對上你看到的失敗,然後匯出幾千個變體,每一個都附著標準答案。標準答案在這裡有具體意思,場景是系統自己搭的,所以它知道每個表面和物件在哪。沒有人用手沿著杯子描一圈遮罩,也沒有標註員去猜深度。
手工標註的真實素材慢、貴,而且錯得會一路傳下去。合成場景也會錯,但錯在哪裡,系統說得出來。
Studio 裡到底有什麼
測試版內建 10,000 個環境,涵蓋室內與真實場景,超過 100,000 個資產,公司說可以組合出數十億種場景變化。你可以從素材庫裡的環境開始,也可以直接描述模型失敗的那個場景。
工作流程平淡無奇,好用的工具通常都這樣。挑一個場景,或者描述一個場景。調整光照、攝影機視角、物件位置。匯出合成影像或影片拿去訓練。重複。
真正看得出工程難度的是那張可調項目清單。照片級真實感已經不是難關,擴散模型隨手就能給你一間漂亮的廚房。難的是這間漂亮廚房完全不知道自己離鏡頭多遠,拿它訓練出來的深度估計模型什麼也沒學到。
一個客戶數字,以及是誰給的
Physicl 點名的早期客戶是 SpAItial,一家做世界模型的公司,由慕尼黑工業大學教授 Matthias Niessner 帶領。SpAItial 的模型從 2D 影像建構可探索的 3D 空間。據 Physicl 說,把它的合成資料加進 SpAItial 的訓練組合後,模型在真實房間上的重建誤差降低了一半以上。
這句話裡有兩件事要分開看。結果是賣方報告的。評估是客戶自己跑的,這比賣方自己做的展示好一些,但仍然不是獨立基準。一個客戶,一個任務,一個指標。
Niessner 自己對瓶頸的描述比那個數字更有用。他跟 TechCrunch 說,資料整理靠人工,週期很長。他感興趣的是即時生成資料,由訓練當下錯在哪裡來驅動:模型回報說某種條件需要更多樣本,資料就出現了。
那是跟靜態資產庫完全不同的產品,也是 Physicl 說自己正在做的方向。de Vigan 描述的場景是,客戶餵進數兆張影像或數百萬小時光達資料,轉成 3D 表示,再生成數十億種排列。公司也把 Meta、World Labs、Epic Games、AWS、NVIDIA 和 TUM 列在自己的工作裡。
這份名單要當成流程看,不是背書。這些名字說明的是,Physicl 賣進去的門是對的。
新聞稿沒寫的部分
Physicl 沒有揭露估值、定價和營收。Studio 在測試期對機器人開發者、大學和實驗室免費,這是還沒有價格時買設計夥伴的標準做法。
賽道擁擠,邊界模糊。有公司收集真實資料,有公司標註真實資料,有公司生成合成資料,有公司賣模擬引擎,有公司賣機器人基礎模型,而且越來越多公司同時做其中三樣。de Vigan 直接認了這點:這個領域非常年輕,有時候也非常模糊。
這門生意還有個結構性問題。如果價值在於針對具體失敗的後訓練資料,那客戶最理想的結果就是失敗更少、需要的資料更少,最後不再買。資料基礎設施公司都得跟這個矛盾共處。有的靠變成工具鏈來回答,Physicl 說它想做的就是這個:成為團隊在模型迭代中一直跑著的系統,而不是一個交付檔案的供應商。
客戶是不是這樣看,取決於匯出怎麼用。把 Studio 當一次性採購的團隊,跑一次,帶走資料,就走了。把它接進訓練循環的團隊,每一輪評估找出一個弱點,下一批資料就打這個點,那他們買的是一套流程的訂閱。Physicl 的說法只在第二種情況下成立,而要把第二種情況變成真的,產品需要 beta 裡還沒有的自動化。
為什麼這是資料問題,不是算力問題
機器人產業花了兩年爭論具身形態、模型架構和動作表示。Physicl 的說法更直白。語言模型有網際網路。機器人沒有對等的東西:沒有一份橫跨數百萬真實家庭和倉庫的抓取、導航、復原紀錄。
補這個缺口有三條路,各有各的成本結構。在真實世界收集:準,慢,對罕見事件無能為力,因為罕見事件就是罕見。遙控操作:品質高,消耗的人工時數與資料量成正比。模擬:便宜、可擴充,但只有模擬世界的行為跟真實世界一致才有用。
sim-to-real 的落差就是全部的賭注。Physicl 的論點是,當資產帶著正確的幾何、材質和物理屬性時,這個落差比人們以為的小,剩下的距離可以靠在模型出錯的那個具體條件上生成資料來填。
這個論點成不成立,一場發表會說明不了。需要更多客戶評估,跨不同模型家族和任務。在那之前,誠實的總結是:$10 million 種子輪買到了一個針對真實瓶頸的、說得通的答案,外加一個裝著 10,000 個房間的 beta。
機器人會告訴我們答案。它們總會說的,最後,在下午 4 點 40 分的廚房裡。
相關文章
一份社群維護的點擊表,關掉了中國品牌 Android 系統裡的廣告
它不動系統,不解鎖,不刷機,只把廠商本來就留出來的開關一個個撥過去。代價是這份名單得一直有人續寫。
GPT Image 2.6 守住 token 價格,帳單卻變貴了
GPT Image 2.6 沿用 2.5 的全部 token 費率,每張圖卻更貴,因為更多工作現在花在輸出 token 上。上線十一天,定價結構說得比排行榜更多。
有人從外部重寫了 IDM,並寫下自己沒碰過的部分
Mister Download Manager 用 Rust 重寫了 Internet Download Manager 的下載流程,聲稱速度快 5 倍、支援 86 種語言。更值得細讀的,是它解釋如何在不複製任何程式碼的前提下完成重寫的那一段。
Rune 是一個 Rust UI 框架,設計初衷是讓 agent 能檢查自己的工作
Rune 能無頭繪製、匯出元素樹並接受腳本化輸入,這讓編碼 agent 拿到截圖永遠給不了的東西,一個可 diff 的訊號。這個框架仍是預先發布版,不接受 pull request。