
Physicl vend 10,000 pièces. Les robots, eux, veulent les coins
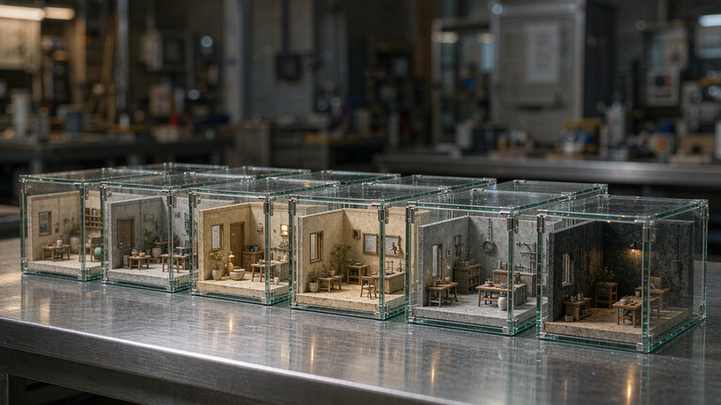
Physicl a levé $10 million en amorçage le 6 novembre, mené par Inovia Capital avec la participation de US Venture Partners. Le même jour, la société a ouvert la bêta de Studio, une application qui génère des scènes 3D et les exporte sous forme de données d'entraînement.
Vu de loin, cela ressemble à une dizaine d'autres sociétés. Sauf qu'il faut regarder ce que Studio livre vraiment. 10,000 environnements 3D prêts à l'emploi. 100,000 assets que l'on peut placer, échanger, réorganiser. Un éclairage, des matériaux et des trajectoires de caméra réglables. Et avec chaque scène, les étiquettes arrivent avec : cartes de profondeur, segmentation d'objets, positions de caméra.
Les étiquettes sont le produit. Les images ne sont que l'emballage.
La tasse sur le comptoir
Alex de Vigan, fondateur et CEO de Physicl, explique la cible avec une cuisine. Un robot domestique sait reconnaître une tasse posée sur un comptoir dégagé. Mettez de l'encombrement devant la moitié de la tasse, ou laissez le soleil descendre pour que les ombres de la pièce changent, et le même robot la rate.
Cet échec est la raison d'être de l'entreprise, et l'on comprend vite pourquoi personne ne l'a réglé. Un jeu de données d'une tasse sur un comptoir propre coûte peu à collecter. La même tasse derrière une boîte de céréales à 16h40 en novembre, dans une cuisine avec une fenêtre à l'ouest, coûte cher à mettre en scène et reste presque introuvable dans la nature.
L'argument de Physicl : on décrit cette cuisine en langage courant, on ajuste les variables jusqu'à retrouver l'échec observé, et on exporte quelques milliers de variantes avec la vérité terrain attachée. Vérité terrain, ici, veut dire quelque chose de précis. C'est le système qui a construit la scène, il sait donc exactement où se trouve chaque surface et chaque objet. Personne n'a dessiné de masque autour de la tasse. Aucun annotateur n'a deviné la profondeur.
Des images réelles annotées à la main, c'est lent, cher, et faux d'une manière qui se propage. Une scène synthétique est fausse d'une manière que le système peut énoncer.
Ce que contient vraiment Studio
La bêta embarque 10,000 environnements couvrant intérieur et extérieur, plus de 100,000 assets, et ce que la société décrit comme des milliards de variantes de scènes possibles. On peut partir d'un environnement de la bibliothèque ou décrire la scène où son modèle échoue.
Le flux de travail est banal, comme le sont souvent les outils utiles. Choisir ou décrire une scène. Régler l'éclairage, le point de vue, le placement des objets. Exporter des images ou des vidéos synthétiques pour l'entraînement. Recommencer.
La liste des réglages, voilà où se trouve l'ingénierie. Le photoréalisme n'est plus la difficulté. Un modèle de diffusion vous donnera une belle cuisine. Le problème, c'est que cette belle cuisine n'a aucune idée de la distance entre le comptoir et l'objectif, et qu'un modèle d'estimation de profondeur entraîné dessus n'a rien appris.
Un chiffre client, et qui l'a produit
Le client de référence nommé par Physicl est SpAItial, une société de world models dirigée par Matthias Niessner, professeur à l'Université technique de Munich. Les modèles de SpAItial construisent des espaces 3D explorables à partir d'images 2D. Selon Physicl, l'ajout de ses données synthétiques au mélange d'entraînement de SpAItial a plus que divisé par deux l'erreur de reconstruction du modèle sur de vraies pièces.
Deux choses méritent d'être séparées dans cette phrase. Le résultat est rapporté par le vendeur. L'évaluation a été menée par le client, ce qui vaut mieux qu'une démo du vendeur et reste autre chose qu'un benchmark indépendant. Un client, une tâche, une métrique.
La description du goulot par Niessner lui-même est plus utile que le chiffre. La curation est manuelle, a-t-il dit à TechCrunch, et le cycle est long. Ce qui l'intéresse, c'est de générer des données à la volée, pilotées par ce que l'entraînement rate sur le moment : le modèle signale qu'il lui faut plus d'exemples d'une condition donnée, et les données apparaissent.
C'est un autre produit qu'une bibliothèque d'assets statique, et c'est celui vers lequel Physicl dit aller. De Vigan décrit des clients qui injectent des milliers de milliards d'images ou des millions d'heures de LIDAR, les convertissent en représentations 3D et génèrent des milliards de permutations. La société cite aussi Meta, World Labs, Epic Games, AWS, NVIDIA et TUM parmi ses travaux.
Cette liste se lit comme un pipeline, pas comme une caution. Ces noms établissent que Physicl vend aux bonnes portes.
Ce que le communiqué omet
Physicl n'a communiqué ni sa valorisation, ni ses prix, ni son chiffre d'affaires. Studio est gratuit en bêta pour les développeurs en robotique, les universités et les laboratoires, la manière habituelle d'acheter des partenaires de conception avant qu'un prix existe.
Le terrain est encombré et les frontières floues. Des sociétés collectent des données réelles, annotent des données réelles, génèrent du synthétique, vendent des moteurs de simulation, vendent des modèles fondation pour robots, et de plus en plus font trois de ces choses à la fois. De Vigan l'admet sans détour : le domaine est très jeune et parfois très flou.
Il y a aussi une question structurelle sur le modèle économique. Si la valeur tient à des données de post-entraînement ciblées sur des échecs précis, alors l'issue idéale pour le client est d'échouer moins, d'avoir besoin de moins de données, et de finir par ne plus acheter. Les sociétés d'infrastructure de données vivent avec cette tension. Certaines y répondent en devenant de l'outillage, ce que Physicl dit vouloir être : le système qu'une équipe continue de faire tourner quand ses modèles changent, plutôt qu'un fournisseur qui livre des fichiers.
La façon dont les clients le verront dépend de l'export. Une équipe qui traite Studio comme un achat ponctuel le lancera une fois, prendra les données et partira. Une équipe qui le branche dans une boucle d'entraînement, où chaque évaluation identifie une faiblesse et où le lot suivant la vise, a acheté un abonnement à un processus. L'argument de Physicl ne tient que dans le second cas, et il faut pour cela une automatisation qui n'existe pas dans une bêta.
Pourquoi c'est un problème de données, pas de calcul
La robotique débat depuis deux ans d'incarnation, d'architecture de modèles et de représentations d'actions. Le discours de Physicl est plus direct. Les modèles de langage avaient internet. Les robots n'ont pas d'équivalent : pas d'archive de préhensions, de navigations et de reprises à travers des millions de foyers et d'entrepôts réels.
Trois voies existent pour combler l'écart, chacune avec sa structure de coûts. Collecter dans le monde réel : précis, lent, et mauvais sur les événements rares, parce qu'ils sont rares. Téléopérer : de bonne qualité, et cela consomme des heures humaines proportionnelles au volume de données. Simuler : bon marché et extensible, mais utile seulement si le monde simulé se comporte comme le vrai.
L'écart sim-to-real, c'est tout le pari. Physicl soutient qu'il est plus étroit qu'on ne le croit dès que les assets portent une géométrie, des matériaux et une physique corrects, et que la distance restante se couvre en générant les conditions précises où un modèle casse.
Un lancement ne tranche pas la question. Il faudrait plus d'évaluations clients, sur d'autres familles de modèles et d'autres tâches. D'ici là, le résumé honnête est celui-ci : $10 million d'amorçage ont acheté une réponse plausible à un vrai goulot, plus une bêta contenant 10,000 pièces.
Les robots nous le diront. Ils finissent toujours par le dire, dans une cuisine à 16h40.
Articles associés
Une feuille de calcul communautaire de clics pour couper les publicités des Android chinois
Il ne touche pas au système, ne déverrouille rien, ne flashe rien. Il bascule un à un les interrupteurs que les fabricants ont déjà prévus. Le prix à payer, c'est la liste qu'il faut continuer d'écrire.
GPT Image 2.6 a tenu le prix des tokens et fait monter la facture
GPT Image 2.6 reprend chaque tarif au token de 2.5 et coûte malgré tout plus cher par image, parce qu'une part plus grande du travail se paie en tokens de sortie. Onze jours après le lancement, la grille tarifaire dit plus que le classement.
Quelqu'un a reconstruit IDM de l'extérieur et a écrit ce qu'il n'a pas touché
Une réimplémentation en Rust d'Internet Download Manager revendique 5 fois la vitesse et 86 langues. Le document le plus intéressant est le paragraphe qui explique comment elle a été construite sans rien copier.
Rune est un framework UI Rust conçu pour qu'un agent puisse vérifier son propre travail
Rune rend en headless, vide son arbre d'éléments et accepte des entrées scriptées, ce qui donne à un agent de codage un signal différable qu'aucune capture d'écran ne fournit. Le framework est en préversion et n'accepte pas de pull requests.