
Physicl vende 10,000 habitaciones. Los robots necesitan las esquinas.
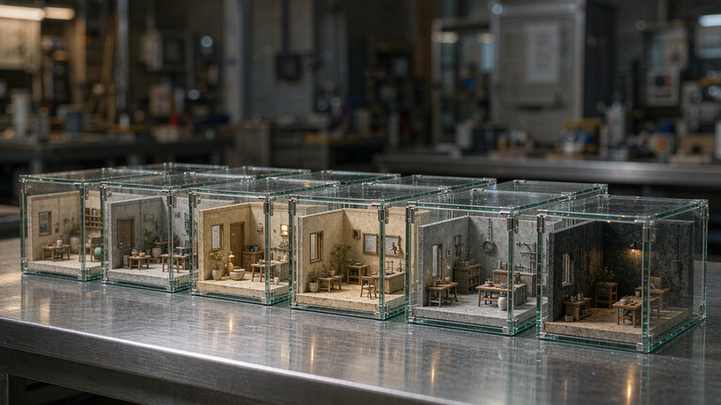
Physicl levantó $10 million en una ronda semilla el 6 de noviembre, liderada por Inovia Capital y con la participación de US Venture Partners. Ese mismo día abrió la beta de Studio, una aplicación que genera escenas 3D y las exporta como datos de entrenamiento.
Suena como una docena de empresas más hasta que uno lee lo que Studio entrega de verdad. Diez mil entornos 3D ya construidos. Cien mil assets de objetos que se pueden colocar, cambiar y reordenar. Iluminación, materiales y recorridos de cámara ajustables. Y con cada escena vienen las etiquetas: mapas de profundidad, segmentación de objetos, posiciones de cámara.
Las etiquetas son el producto. Las imágenes son el envoltorio.
La taza sobre la encimera
Alex de Vigan, fundador y CEO de Physicl, explica el cliente objetivo con una cocina. Un robot doméstico reconoce una taza sobre una encimera despejada. Pon algo delante que tape la mitad, o deja que caiga el sol y cambien las sombras de la habitación, y el mismo robot ya no la encuentra.
Ese fallo es la razón de ser de la empresa, y es fácil ver por qué nadie lo ha resuelto. Un dataset de una taza sobre una encimera limpia es barato de recoger. Un dataset de esa misma taza detrás de una caja de cereales a las 4:40 de la tarde en noviembre, en una cocina con ventana al oeste, es caro de montar y casi imposible de encontrar en estado natural.
Lo que Physicl sostiene es que puedes describir esa cocina en lenguaje corriente, ajustar las variables hasta que coincida con el fallo que viste, y exportar unos miles de variantes con ground truth incluido. Ground truth aquí significa algo concreto: el sistema construyó la escena, así que sabe exactamente dónde está cada superficie y cada objeto. Ninguna persona dibujó una máscara alrededor de la taza. Ningún etiquetador adivinó la profundidad.
El metraje real etiquetado a mano es lento, caro y se equivoca de formas que se propagan. Una escena sintética se equivoca de formas que el sistema puede enunciar.
Qué contiene Studio en realidad
La beta llega con 10,000 entornos de interiores y espacios reales, más de 100,000 assets y lo que la empresa describe como miles de millones de variaciones posibles de escena. Puedes partir de un entorno de la biblioteca o describir la escena en la que falla tu modelo.
El flujo de trabajo es anodino de la manera en que suelen serlo las herramientas útiles. Elige o describe una escena. Ajusta la iluminación, el punto de vista de la cámara, la colocación de los objetos. Exporta imágenes o vídeo sintéticos para entrenar. Repite.
La lista de ajustes es donde vive la ingeniería. El fotorrealismo ya no es la parte difícil; un modelo de difusión te da una cocina preciosa. Lo difícil es que la cocina preciosa no tiene ni idea de a qué distancia está la encimera del objetivo, y un modelo de estimación de profundidad entrenado con ella no ha aprendido nada.
Un dato de cliente, y quién lo produjo
El único cliente temprano con nombre es SpAItial, una empresa de world models dirigida por Matthias Niessner, profesor de la Universidad Técnica de Múnich. Los modelos de SpAItial construyen espacios 3D explorables a partir de imágenes 2D. Según Physicl, añadir sus datos sintéticos a la mezcla de entrenamiento de SpAItial redujo a más de la mitad el error de reconstrucción en habitaciones reales.
Hay dos cosas que conviene separar en esa frase. El resultado lo reportó el proveedor. La evaluación la ejecutó el cliente, lo cual es mejor que una demo del proveedor y sigue sin ser un benchmark independiente. Un cliente, una tarea, una métrica.
La descripción que hace Niessner del cuello de botella es más útil que la cifra. La curaduría es manual, dijo a TechCrunch, y el ciclo es largo. Lo que le interesa es generar datos sobre la marcha, guiados por lo que el entrenamiento está haciendo mal en ese momento: el modelo informa de que necesita más ejemplos de una condición concreta y los datos aparecen.
Ese es un producto distinto de una biblioteca estática de assets, y es hacia donde Physicl dice que construye. De Vigan describe clientes que meten billones de imágenes o millones de horas de LIDAR, las convierten en representaciones 3D y generan miles de millones de permutaciones. La empresa también menciona a Meta, World Labs, Epic Games, AWS, NVIDIA y la TUM entre sus trabajos.
Lee esa lista como tubería, no como aval. Los nombres establecen que Physicl vende en los edificios correctos.
La parte que el comunicado omite
Physicl no ha revelado su valoración, sus precios ni sus ingresos. Studio es gratis en beta para desarrolladores de robótica, universidades y laboratorios, que es la forma habitual de comprar socios de diseño antes de que exista un precio.
El campo está lleno y los límites son borrosos. Hay empresas que recogen datos reales, etiquetan datos reales, generan datos sintéticos, venden motores de simulación, venden modelos fundacionales de robot y, cada vez más, hacen tres de esas cosas a la vez. De Vigan lo concede sin rodeos: el espacio es muy joven y a veces muy difuso.
También hay una pregunta estructural sobre el negocio. Si el valor está en datos de post-entrenamiento dirigidos a fallos concretos, el resultado ideal para el cliente es fallar menos, necesitar menos datos y acabar dejando de comprar. Las empresas de infraestructura de datos conviven con esa tensión. Algunas la resuelven convirtiéndose en herramienta, que es lo que Physicl dice querer: el sistema que un equipo sigue ejecutando mientras sus modelos cambian, no un proveedor que manda archivos.
Que los clientes lo vean así depende de cómo funcione la exportación. Un equipo que trate Studio como una compra puntual lo ejecutará una vez, se llevará los datos y se irá. Un equipo que lo conecte a un bucle de entrenamiento, donde cada ronda de evaluación identifica una debilidad y el siguiente lote de datos la ataca, ha comprado una suscripción a un proceso. El argumento de Physicl solo funciona en el segundo caso, y el producto necesita una automatización que no existe en una beta para que el segundo caso sea real.
Por qué esto es un problema de datos y no de cómputo
La industria robótica lleva dos años discutiendo sobre embodiment, arquitectura de modelos y representaciones de acciones. El argumento de Physicl es más contundente. Los modelos de lenguaje tuvieron internet. Los robots no tienen nada equivalente: ningún archivo de agarres, navegaciones y recuperaciones por millones de casas y almacenes reales.
Hay tres maneras de cerrar esa brecha, y cada una tiene su estructura de costes. Recoger en el mundo real: preciso, lento y malo con los eventos raros, porque los eventos raros son raros. Teleoperar: alta calidad, y consume horas humanas en proporción directa al volumen de datos. Simular: barato y escalable, pero solo sirve si el mundo simulado se comporta como el real.
La brecha sim-to-real es toda la apuesta. Physicl sostiene que es más estrecha de lo que se cree cuando los assets llevan geometría, materiales y física correctos, y que la distancia restante se puede cubrir generando las condiciones concretas en las que un modelo se rompe.
Que eso se sostenga no lo decide un lanzamiento. Más evaluaciones de clientes, en distintas familias de modelos y tareas, lo decidirían. Hasta entonces el resumen honesto es que $10 million de semilla compraron una respuesta plausible a un cuello de botella real, más una beta con 10,000 habitaciones dentro.
Los robots nos lo dirán. Siempre lo hacen, tarde o temprano, en una cocina a las 4:40 de la tarde.
Artículos relacionados
Una hoja de cálculo comunitaria de toques que apaga la publicidad de los Android chinos
No toca el sistema, no desbloquea nada, no flashea nada. Solo mueve los interruptores que los fabricantes ya dejaron a la vista. El precio es una lista que alguien tiene que seguir escribiendo.
GPT Image 2.6 mantuvo el precio por token y subió la factura
GPT Image 2.6 mantiene cada tarifa por token de 2.5 y aun así cuesta más por imagen, porque buena parte del trabajo ocurre ahora en tokens de salida. Once días después del lanzamiento, la estructura de precios dice más que el ranking.
Alguien reconstruyó IDM desde fuera y anotó lo que no tocó
Una reimplementación en Rust de Internet Download Manager promete 5 veces la velocidad y 86 idiomas. El documento más interesante es el párrafo que explica cómo se construyó sin copiar nada.
Rune es un framework de UI en Rust creado para que un agente pueda comprobar su propio trabajo
Rune renderiza sin interfaz, vuelca su árbol de elementos y acepta entrada programada, lo que da a un agente de código una señal diffeable que una captura nunca ofrece. El framework está en prelanzamiento y no acepta pull requests.