
1本26セントの生成動画から、生き物のリグ付きGLBを作るanymove
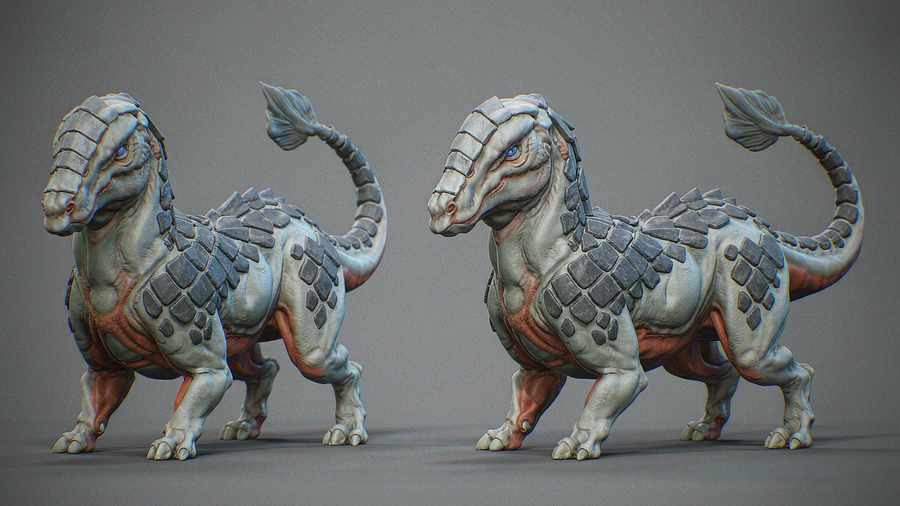
モーションキャプチャには誰も語らないスケーリングの問題があります。スーツのコストではありません。モキャプは人間向けに作られていて、脚が2本、骨格が既知、股関節の高さが標準という前提があります。キャラクターがドラゴン、巨大な蜘蛛、炎の悪魔になった瞬間、パイプライン全体が適用できなくなります。
ゲームも映画も、これをアニメーターで解いてきました。アニメーターは参照を見て、クリーチャーの手足を1フレームずつ手でキーを打ちます。参照は歩く人間で、対象は脚が6本と尻尾のある何かだからです。それが実際の仕事で、クリーチャーアニメーションが数ある費目のなかでも特に高い理由でもあります。
Patchのanymoveは、その隙間を自動化しようとする試みです。452スター、登場は10月27日。やることは1つで、AIが生成したクリーチャーの動画1本を、リグ付きでアニメーションするGLBに変えます。
面白いのはそこへ至る手口で、その手口はカメラの話です。
1つのフレームに2つの視点
人間のモキャプが成立するのは、複数のカメラが同じ身体を違う角度から見て、視線の交差が3Dの位置を与えるからです。カメラ1台では平面上の2D位置しか得られず、平面は身体ではありません。
AIが生成したクリップの周りにカメラを2台置くことはできません。クリップは3Dに存在しないからです。ピクセルです。
そこでanymoveは、動画モデルに少し妙なことを頼みます。同じクリーチャーを正面からと横から、同時に、同じフレームの中に撮らせる。ディプティク、つまりパネル2枚を並べ、クリーチャーは1体、視点は2つ、動きは同期。
これで視線が2本に戻ります。正面がXとYを与え、側面がZとYを与える。交差させれば関節に3Dの位置が出ます。奥行きモデルも、マルチビューのリグもなしに、平らな動画から復元できます。
リポジトリの元の名前はdiptychでした。anymoveへの改名は製品としての判断として納得できますが、古い名前のほうが仕組みを正直に言い当てていました。2パネルのフレームが発明で、残りは配管です。
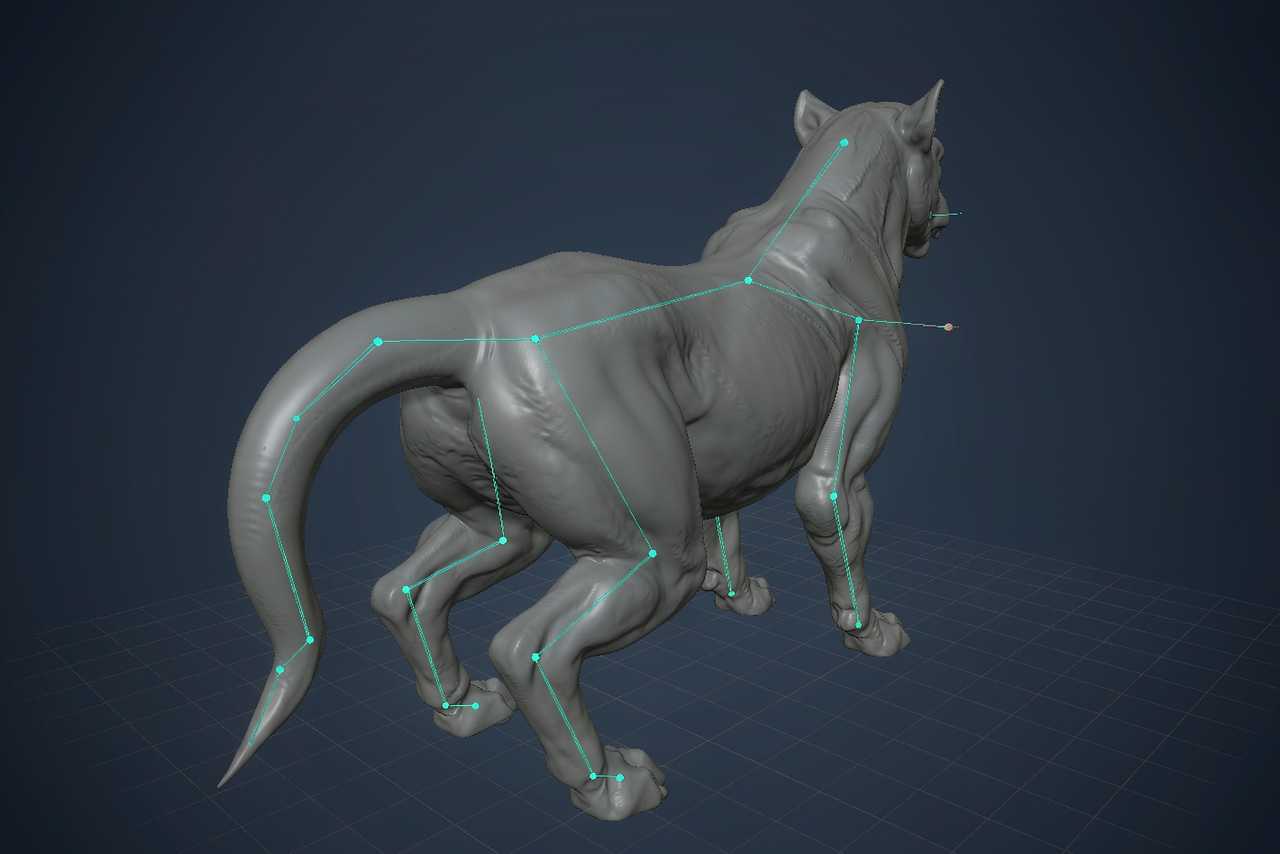
パイプラインを段階で見る
クリップを生成する。 1つのムーブにつきAI動画1本。READMEでは1本0.26ドルで、ドラゴン、巨大蜘蛛、炎の悪魔、狼のデモはどれもこの方法で作られています。プロンプトはディプティクの構図を保たなければならず、ここが唯一、手法全体が壊れ得る場所です。パネル間でモデルがフレーミングを漂流させると、2つの視点が対応しなくなり、三角測量はゴミになります。
関節を読む。 DINOv2ベースのリーダーが両方の視点で全ての関節を見つけます。訓練するのはこれで、しかも高くつく部分です。訓練には24GBのVRAMが要ります。読むだけなら、そのあとはずっと少なく済みます。
リグを合わせる。 2つの視点が「壁のように立ち上がり、各関節を3Dで留める」とREADMEは表現しています。その復元点にリグをフィットさせます。出力は点群ではなくボーンアニメーションで、下流で使えるのはそのおかげです。
書き出す。 GLBと、showcase.mp4。後者はアニメーションを元のクリップの隣に並べるので、自分に嘘をつかずに比較できます。
この最後の成果物は、今年の優れたエージェントツールに見られるのと同じ本能です。必ず並べた比較を出せ。モデルは喜んで成功したと言うし、唯一の防御は見ることだから。
インストール、ここで多くの人が止まる
要件は具体的です。CUDA対応のNVIDIA GPU、Python 3.11、PATHの通ったBlender 5.x(またはBLENDER環境変数)、そして新しいクリップを作るならfalのキー。
git clone https://github.com/Patch-gg/anymove && cd anymove
python3.11 -m venv .venv
.venv/bin/pip install torch==2.11.0 --index-url https://download.pytorch.org/whl/cu128
.venv/bin/pip install -r requirements.txt
cp .env.example .env    # add your FAL_KEY
torchのビルドが固定され、CUDA 12.8のインデックスが明示されている点に注目してください。たまたま手元にあるPythonで動くプロジェクトではありません。
導入でいちばん嬉しいのはCPUだけのスモークテストです。ドラゴンの咆哮について、リーダーが見つけた関節の検出結果が同梱されているので、355MBの重みを落とさず、Blenderも入れずにリグを合わせられます。
mkdir -p runs/dragon/clips/roar
MOCAP_CREATURE=assets/dragon .venv/bin/python -m mocap.solve \
  examples/dragon_roar/det.npz \
  assets/dragon/rigged/rig_info.json \
  runs/dragon/clips/roar/motion.json
20秒ほどで終わり、2つの視点がどれだけ一致したかを出力します。これが本当に欲しい診断で、視点間の不一致こそ、この構造が晒されている失敗の型だからです。
フル経路は、リリースにある例のクリーチャーのメッシュ、訓練済みリーダー、クリップを使います(メッシュ13MB、リーダー355MB、クリップ4MB)。
tools/fetch_examples.sh dragon --readers --clips
tools/prep.sh dragon && tools/rig.sh dragon
tools/capture.sh dragon runs/dragon/videos/roar/s1/h3max.mp4 roar
同じクリーチャーに新しいムーブを足すと約0.52ドル。クリップを2本撮るからです。
.venv/bin/python tools/make_prompt.py assets/dragon \
  "the dragon whips its tail from side to side, then stands still." \
  prompts/dragon/tailwhip.txt
tools/film.sh dragon tailwhip h3max 1,2
tools/capture.sh dragon runs/dragon/videos/tailwhip/s1/h3max.mp4 tailwhip
本当に難しいところ
リターゲティング。関節位置の復元と、それを特定の骨長と特定のレストポーズを持つリグに載せることは別の問題です。ドラゴンのリグの首が、復元点より長ければ、首が妙に曲がるか頭が浮きます。READMEの「リグが点の上に着地する」という言い方は、リターゲティングではなくフィッティングを示していて、そちらのほうが簡単で正直な選択です。アニメーションの質は、リグの比率がクリップにどれだけ合っているかで決まります。
接地。どのモキャプパイプラインも足の滑りに苦しみ、生成動画からの2視点解法には地面も力のデータも物理制約もありません。滑るドラゴンは、関節がどれだけ良くても偽物に見えます。
遮蔽。2視点は助けになりますが、2つしかありません。両方のパネルで身体の後ろに隠れた手足は推測するしかなく、モデルはもっともらしい何かを作り出します。
経済性こそが本題
1本26セント。読み込みとフィットで1分未満。リポジトリには例のクリーチャーが4体あり、それぞれにリグ、プロンプト、リーダーが付いています。
代替案と比べてください。アニメーターと1日と、修正のサイクル。比較は公平ではありません。出力の品質は同じではないし、主役キャラクターの決め技をこれで出荷する人はいません。しかし背景のクリーチャー、敵のバリエーション、群衆の埋め、あるいはトレーラーでモンスターが2秒しか映らない40秒のために、26セントは「このカットはやる価値があるか」という議論を丸ごと消します。
今年のパターンがまた出ています。「AIが職人技を置き換える」のではありません。AIは、捨てるつもりだった版のコストを潰し、職人技は生き残る判断のほうへ上がっていきます。
試すべきか
NVIDIAのカードと、Blenderと、大事にしているクリーチャーのリグがあるなら、はい。ただしフルパイプラインではなくCPUのスモークテストから始めてください。20秒で終わり、手元のデータで2つの視点が一致しているかが分かります。何かにお金を使う前に知るべき唯一の問いです。
Macなら、リーダーの訓練は対象外で、フィッティングは理論上の話になります。リポジトリはApache-2.0なので移植は可能です。今月の自分ならやりません。