
4GB 显卡跑 2.8 万亿参数:AirLLM 如何击穿显存高墙
人人都撞上的那堵墙
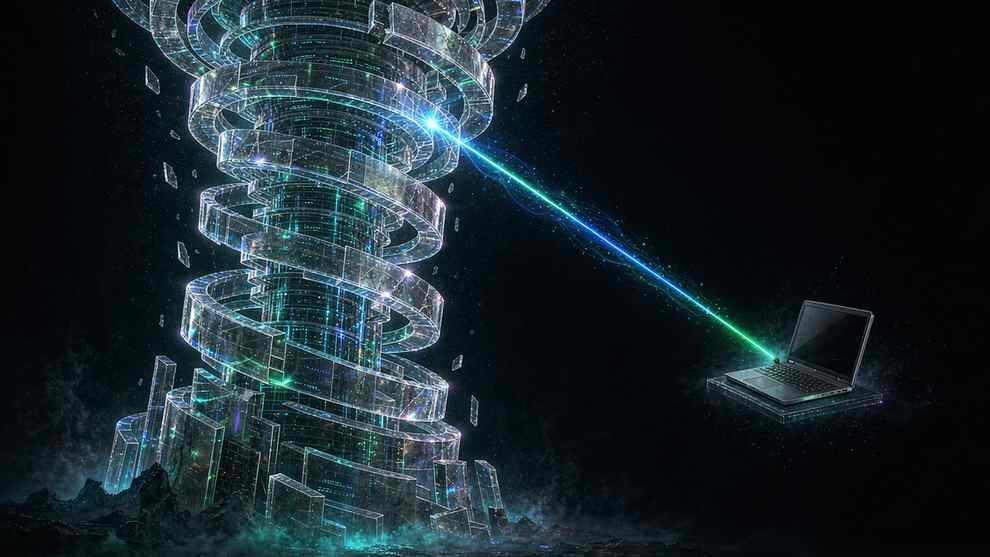
每个想在本地跑大模型的开发者,都会撞上同一个时刻。这不是能力问题,也不是成本问题。它是规格表上的一个数字:显存。一个像样的开源模型塞不进大多数人手里的显卡,而惯常的解法,买一张更大的卡,价格已经涨到了离谱的地步。
于是这个领域里堆满了各种绕行方案。把权重量化到 4 位。把模型的一部分挪到系统内存。租用别人的硬件。每种都能用,每种都有代价,每种都会以某种你必须接受的方式改变模型。然后还有 AirLLM:这个仓库最近一直挂在 GitHub 趋势榜前列,它的 README 里写着一句听起来像是打错字的说法,2.8 万亿参数,单张 4GB 显卡。
这套手法到底是什么
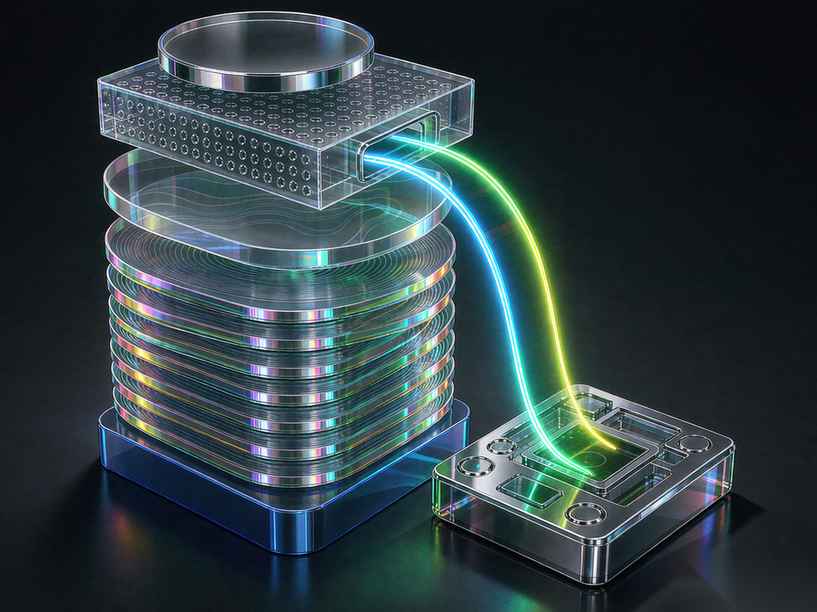
AirLLM 背后的思路不是把模型变小,而是不再试图一次把整个模型都握在内存里。它不追求在生成一个 token 之前把网络的每一层都装进显卡,而是让数据一层一层地流过模型,在每一块真正被用到之前才从磁盘取出来,用完即释放。
在任意一个瞬间,只有模型很薄的一片需要待在快速内存里,其余部分可以留在硬盘上。显卡从仓库变成了工作台,模型的规模也就不再为哪台机器能跑设下硬性上限。
同一个人可以用一张很小的书桌读完一本上千页的书,道理一样。你不需要把整本书摊在面前,需要的是当前这一页,以及一个能拿到下一页的办法。
诚实的代价
如果让层流过一张小显卡是免费的,那所有人早就这么做了,所以这里值得把代价说清楚。为每一个 token 都从磁盘读取权重,它慢的程度很容易被低估。显卡会白白空转,等着那些如果常驻内存本可以立刻用上的数据。
由此带来的现实结果是,这类配置擅长的任务,和把模型完整加载进内存的路子不一样。如果你需要为一款聊天产品提供稳定的快速响应,流式就是错的工具。如果你想偶尔跑一个非常大的模型,用你已经拥有的硬件,做一件吞吐量没那么重要、重点是能跑起来就行的活,那么这笔交易就倒向你这一边。
把它和更常见的绕行方案摆在一起看会更好理解。量化是把模型本身缩小,用一点点精度换取更小的占用,它改变的是模型是什么。流式则不动模型的数值,只是改变它们存放的位置。两者不是对手,可以叠加。一个既被量化、又逐层流式加载的模型,会比单用任一种技术都更小更轻,这也是为什么在实践中这两种做法常常同时出现。
还有第三项代价,宣传得比较少:硬盘。流式加载权重意味着每一轮都要从存储里读一遍,所以一旦模型装不进内存,一块慢盘立刻就成了新的瓶颈。走上这条路的人很快就会明白,真正重要的硬件不只显卡。在这里,一块高速固态硬盘对吞吐量的帮助,能顶得上多出来的几个 GB 显存。
交互性与可行性之间的这条分界,是大多数对比都会忽略的一点。一个在你桌上慢得像爬的模型,仍然是一个你能在自己桌上跑的模型。对于一个没有集群的研究者,或者一个想拿某个特定的提示词去试某个特定巨型模型的开发者来说,这可能就够了。
它为什么一直上热榜
AirLLM 并不新。它存在得够久了,紧跟本地推理的人对它都不陌生。它反复出现在趋势榜上,原因和具体实现关系不大,更多是它背后那股压力。
开源权重的模型一直在变大。如今最好的开源图像、视频和语言模型,已经稳稳落进没有哪张消费级显卡能轻松装下的区间。与此同时,能装下它们的那些大显存显卡,价格不降反升,推动它的正是那场重塑整个硬件市场的需求。可运行的模型,和负担得起的硬件上能跑的模型,两者之间的差距一直在拉大。
任何在这道差距上顶一把的项目,哪怕做得不完美,都会不断找到受众。另一种可能是这样一个世界:开源模型的前沿理论上人人可用,实际上只有拥有数据中心的人用得起。各种绕行方案,正是开源权重里那个开放得以名实相符的方式。
它解决不了什么
这里有两件不同的事容易被混为一谈。在一张小显卡上跑大模型是内存问题。从大模型里拿到有用的输出是能力问题,两者并不相同。一个 2.8 万亿参数的模型即便通过 4GB 显卡流式加载,生成文字的速度依然由它的硬盘和带宽决定,而文字的质量取决于模型本身,不是这个绕行方案能带来的。
还有一个许可层面的问题,是技术成就碰不到的。能本地跑一个模型,和你能不能把它的权重用于你的用途,完全是两回事。世界上再厉害的本地推理配置,也仍然受它所运行的那个模型的条款约束。
更大的意义
本地 AI 的前沿不是某一次突破,而是一长串不起眼的工程取舍:数据放在哪、什么时候移动、你愿意等多久。AirLLM 是个好例子,因为它对这笔交易坦白得近乎直白:你放弃速度,换来的是跑起一个本不该装得下的东西。
对于越来越多把模型能做什么看得比它做得多快更重要的人来说,这是一笔划算的交易。而对其他人来说,它提醒了一件事:这个模型需要多少 GB,既是硬件的限制,同样也是设计上的选择。总有某个人,在某个地方,正在寻找一张比书更小的书桌。
相关文章
一个比特就够了:微软 BitNet 为何持续赢得人心
单比特权重不是噱头。解析微软 BitNet 的三值方案如何用加法替代乘法,让大模型跑在普通 CPU 上,以及它真正的代价。
AI 视频的新规则手册:欧盟 AI 法案下的机器可读标签
欧盟 AI 法案第 50 条让 AI 视频的来源元数据成为合规问题。标签在生成时已内置,也最容易被流程剥掉。
你的 AI Agent 什么都记不住:修复 context 膨胀的 MCP 技巧
agent 不会因为跑得久而变聪明,反而会因为 context window 被垃圾填满而变笨。从工具输出 sandboxing 到持久化记忆与 routing,这些项目正在修复 agent 的记忆。
Google 要退役全部 Veo 端点:10 月 22 日视频服务大调整内幕
Google 将在 2026 年 10 月 22 日关停 Gemini API 上全部 Veo 端点,包括 veo-3.1-lite-generate-preview,替换为按 token 计费的 gemini-omni-1.1-flash。