
2,8 billones de parámetros en una GPU de 4 GB: cómo AirLLM rompió el muro de la VRAM
El muro con el que todos chocan
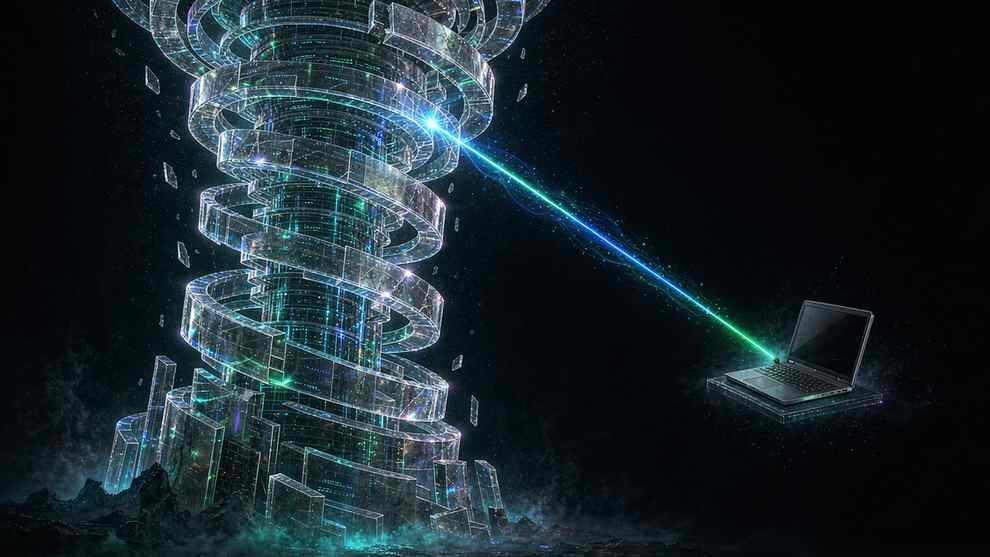
Hay un momento concreto con el que tropieza todo desarrollador que quiere ejecutar un modelo grande en local. No es un problema de habilidades ni de coste. Es un número en una ficha técnica: la memoria de vídeo. Un modelo abierto serio no cabe en la tarjeta gráfica que tiene la mayoría de la gente, y el arreglo habitual, comprar una tarjeta más grande, ha llegado a un precio absurdo.
Así que el campo se llenó de rodeos. Cuantizar los pesos hasta cuatro bits. Descargar parte del modelo a la RAM del sistema. Alquilar el hardware de otro. Cada uno funciona, cada uno cuesta algo, y cada uno cambia el modelo de una forma con la que hay que vivir. Después está AirLLM, un repositorio que este mes se sitúa cerca de lo más alto de las tendencias de GitHub, cuyo README hace una afirmación que suena a errata: 2,8 billones de parámetros, una sola GPU de 4 GB.
En qué consiste de verdad el truco
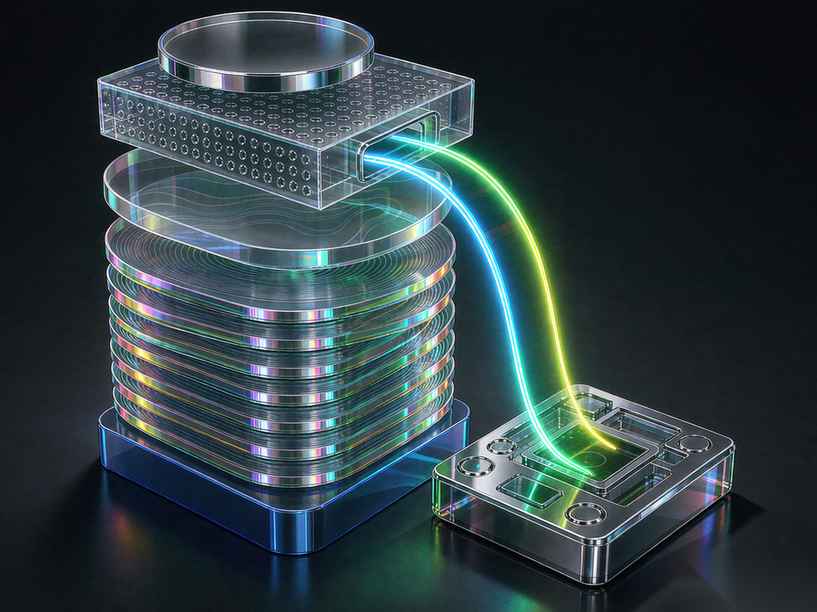
La idea detrás de AirLLM no es hacer el modelo más pequeño. Es dejar de intentar mantenerlo entero en memoria de una vez. En lugar de cargar cada capa de la red en la tarjeta gráfica antes de generar un token, el enfoque recorre el modelo capa a capa, extrayendo cada bloque del disco justo antes de necesitarlo, usándolo y soltándolo después.
En cualquier instante, solo una rebanada fina del modelo necesita residir en la memoria rápida. El resto puede quedarse en un disco. La tarjeta gráfica pasa de ser un almacén a un escritorio de trabajo, y el tamaño del modelo deja de imponer un techo fijo a la máquina capaz de ejecutarlo.
Es la misma razón por la que una persona puede leer un libro de mil páginas en un escritorio muy pequeño. No hace falta tener el libro entero delante. Hace falta la página en la que estás, más una forma de traer la siguiente.
El compromiso honesto
Si hacer fluir las capas por una GPU pequeña fuera gratis, todo el mundo lo haría ya, así que merece la pena decir con claridad cuánto cuesta. Leer los pesos del disco en cada token es lento de una manera fácil de subestimar. La tarjeta gráfica se queda parada mientras espera datos que habría podido usar de inmediato de haber estado residentes.
La consecuencia práctica es que estas configuraciones sirven para un conjunto de tareas distinto al de un modelo cargado por completo en memoria. Si necesitas un flujo constante de respuestas rápidas para un producto de chat, el streaming es la herramienta equivocada. Si quieres ejecutar un modelo muy grande de vez en cuando, en hardware que ya tienes, para una tarea donde el rendimiento importa menos que el simple hecho de poder hacerla, el compromiso se inclina a tu favor.
Ayuda poner esto junto al rodeo más familiar. La cuantización encoge el modelo en sí, cambiando un poco de precisión por un menor consumo de espacio, y cambia lo que el modelo es. El streaming deja intactos los números del modelo y traslada dónde viven. Los dos no son rivales, se apilan. Un modelo cuantizado que además se transmite capa a capa es más pequeño y ligero que cualquiera de las dos técnicas por separado, y por eso ambos enfoques tienden a aparecer juntos en la práctica.
Hay un tercer coste, menos publicitado: el disco. Transmitir los pesos significa leerlos del almacenamiento en cada pasada, así que un disco lento se convierte en el nuevo cuello de botella en el momento en que el modelo deja de caber en memoria. Quien emprende este camino aprende pronto que el hardware que importa no es solo la GPU. Un SSD rápido puede aportar más al rendimiento aquí que unos cuantos gigabytes extra de memoria de vídeo.
Esa distinción, entre interactividad y viabilidad, es la que más se pasa por alto en las comparaciones. Un modelo que va a paso de tortuga en tu escritorio sigue siendo un modelo que puedes ejecutar en tu escritorio. Para un investigador sin clúster, o un desarrollador que quiere probar un prompt concreto contra un modelo enorme concreto, puede bastar.
Por qué no deja de ser tendencia
AirLLM no es nuevo. Lleva el tiempo suficiente como para resultar familiar a quien sigue la inferencia local de cerca. Vuelve a aparecer en las listas de tendencias por un motivo que tiene menos que ver con la implementación concreta que con la presión que hay detrás.
Los modelos de pesos abiertos no dejan de crecer. Los mejores modelos abiertos de imagen, vídeo y lenguaje se sitúan ya firmemente en un rango que ninguna tarjeta gráfica de consumo puede contener con holgura. Al mismo tiempo, el precio de las tarjetas con mucha memoria capaces de contenerlos ha subido, no bajado, empujado por la misma demanda que está transformando el resto del mercado de hardware. La brecha entre lo que se puede ejecutar y lo que se puede ejecutar en hardware asequible no deja de ensancharse.
Cualquier proyecto que haga frente a esa brecha, aunque sea de forma imperfecta, seguirá encontrando público. La alternativa es un mundo en el que la frontera de los modelos abiertos está teóricamente disponible para todos y prácticamente solo para quienes tienen un centro de datos. Los rodeos son la forma en que el abierto de los pesos abiertos se mantiene honesto.
Lo que no resuelve
Aquí se mezclan dos cosas distintas. Ejecutar un modelo grande en una GPU pequeña es un problema de memoria. Obtener una salida útil de un modelo grande es una cuestión de capacidad, y las dos no son lo mismo. Un modelo de 2,8 billones de parámetros transmitido por una tarjeta de 4 GB sigue generando texto a un ritmo marcado por su disco y su ancho de banda, y la calidad de ese texto es la del modelo, no la que el rodeo haya hecho posible.
También hay una dimensión de licencias que el logro técnico no toca. Poder ejecutar un modelo en local no dice nada sobre si tienes permiso para usar sus pesos para tu propósito. La configuración de inferencia local más impresionante del mundo sigue atada a los términos que acompañan al modelo que ejecuta.
El punto más amplio
La frontera de la IA local no es un único avance. Es una larga serie de decisiones de ingeniería poco glamurosas sobre dónde viven los datos, cuándo se mueven y por cuánto estás dispuesto a esperar. AirLLM es un buen ejemplo porque es muy franco sobre el trato: renuncias a la velocidad y, a cambio, puedes ejecutar algo que no estaba destinado a caber.
Para un número creciente de personas a las que les importa más lo que un modelo puede hacer que la rapidez con que lo hace, es un trato razonable. Y para todos los demás, es un recordatorio de que este modelo necesita X gigabytes es tanto una decisión de diseño como un límite de hardware. Alguien, en algún sitio, siempre está buscando el escritorio más pequeño que el libro.
Artículos relacionados
El agente independiente del harness: ejecutar cualquier modelo de frontera en tu propia máquina
El modelo es la inteligencia, el harness es la fontanería, y los dos no necesitan vivir en el mismo paquete. Un grupo de proyectos de código abierto deshace ese vínculo para ejecutar cualquier modelo de frontera desde la interfaz que prefieras, con acceso local por defecto.
Un bit es suficiente: por qué el BitNet de Microsoft sigue conquistando
Un peso de un bit no es un truco. Cómo el esquema ternario del BitNet de Microsoft sustituye la multiplicación por la suma, hace correr grandes modelos en una CPU corriente y a qué precio.
El nuevo manual de reglas del vídeo con IA: las etiquetas legibles por máquina bajo el EU AI Act
El artículo 50 del EU AI Act convierte los metadatos de procedencia en una cuestión de cumplimiento. La etiqueta se incorpora al generar y el canal la pierde con facilidad.
Tu agente de IA lo olvida todo: los trucos de MCP que arreglan la hinchazón del contexto
Un agente no se vuelve más listo por correr mucho tiempo, sino más torpe, porque su context window se llena de basura. Del sandboxing de salidas de herramientas a la memoria persistente y el routing, estos proyectos reparan la memoria del agente.