
2,8 trilioni di parametri su una GPU da 4 GB: come AirLLM ha infranto il muro della VRAM
Il muro su cui sbattono tutti
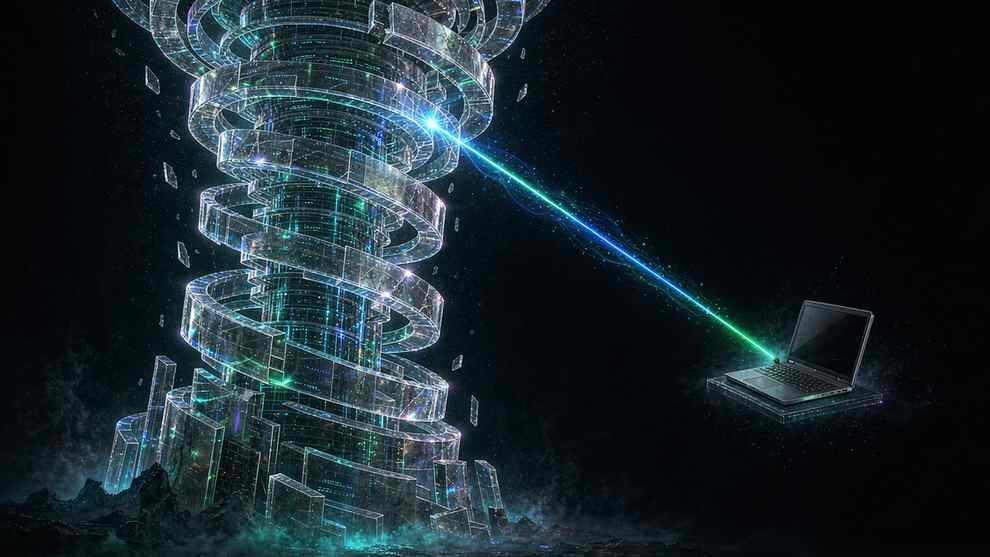
C'è un momento preciso che incontra ogni sviluppatore che vuole eseguire un modello grande in locale. Non è un problema di capacità né di costo. È un numero in una scheda tecnica: la memoria video. Un modello aperto serio non entra nella scheda grafica che la maggior parte delle persone possiede, e la soluzione abituale, comprare una scheda più grande, ha raggiunto un prezzo diventato assurdo.
Così il campo si è riempito di aggiramenti. Quantizzare i pesi fino a quattro bit. Scaricare parte del modello nella RAM di sistema. Affittare l'hardware di qualcun altro. Ognuno funziona, ognuno costa qualcosa, e ognuno cambia il modello in un modo con cui bisogna convivere. Poi c'è AirLLM, un repository in cima alle tendenze di GitHub questo mese, il cui README fa un'affermazione che suona come un refuso: 2,8 trilioni di parametri, una singola GPU da 4 GB.
In cosa consiste davvero il trucco
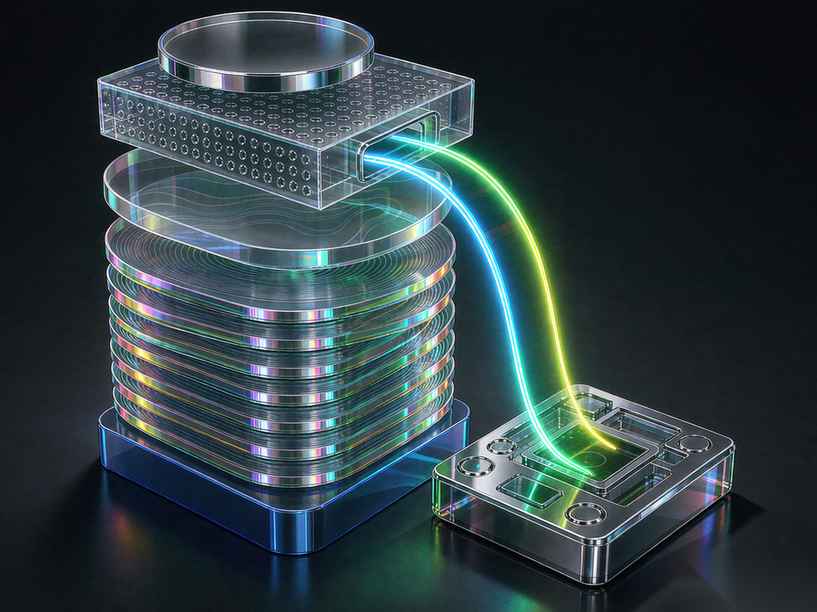
L'idea dietro AirLLM non è rendere il modello più piccolo. È smettere di provare a tenerlo intero in memoria in una volta sola. Invece di caricare ogni strato della rete nella scheda grafica prima di generare un token, l'approccio fa scorrere il modello uno strato alla volta, prelevando ogni blocco dal disco appena prima che serva, usandolo e lasciandolo andare.
In qualunque istante, solo una sottile fetta del modello deve risiedere nella memoria veloce. Il resto può restare su un disco. La scheda grafica diventa un banco di lavoro invece che un magazzino, e la dimensione del modello smette di imporre un tetto rigido alla macchina in grado di eseguirlo.
È lo stesso motivo per cui una persona può leggere un libro di mille pagine su una scrivania molto piccola. Non serve avere il libro intero davanti. Serve la pagina su cui si è, più un modo per prendere la successiva.
Il compromesso onesto
Se far scorrere gli strati attraverso una GPU piccola fosse gratis, lo farebbero già tutti, quindi vale la pena dire con chiarezza quanto costa. Leggere i pesi dal disco a ogni token è lento in un modo facile da sottovalutare. La scheda grafica resta inattiva mentre aspetta dati che avrebbe potuto usare subito se fossero stati residenti.
La conseguenza pratica è che queste configurazioni sono adatte a un insieme di compiti diverso da quello di un modello caricato interamente in memoria. Se ti serve un flusso costante di risposte rapide per un prodotto di chat, lo streaming è lo strumento sbagliato. Se vuoi eseguire ogni tanto un modello molto grande, su hardware che possiedi già, per un lavoro in cui la velocità di elaborazione conta meno del semplice poterlo fare, il compromesso pende a tuo favore.
Aiuta metterlo accanto all'aggiramento più familiare. La quantizzazione riduce il modello stesso, barattando un po' di precisione con un ingombro minore, e cambia ciò che il modello è. Lo streaming lascia intatti i numeri del modello e sposta dove risiedono. I due non sono rivali, si sommano. Un modello quantizzato e anche trasmesso strato per strato è più piccolo e più leggero di ciascuna tecnica da sola, ed è per questo che in pratica i due approcci tendono a comparire insieme.
C'è un terzo costo, meno pubblicizzato: il disco. Trasmettere i pesi significa leggerli dall'archiviazione a ogni passaggio, così un disco lento diventa il nuovo collo di bottiglia nel momento in cui il modello smette di entrare in memoria. Chi imbocca questa strada impara presto che l'hardware che conta non è solo la GPU. Un SSD veloce può fare di più per la velocità di elaborazione, qui, di qualche gigabyte in più di memoria video.
Questa distinzione, tra interattività e fattibilità, è quella che quasi tutti i confronti mancano. Un modello che va a passo di lumaca sulla tua scrivania resta un modello che puoi eseguire sulla tua scrivania. Per un ricercatore senza cluster, o per uno sviluppatore che vuole provare un prompt specifico su uno specifico modello enorme, può bastare.
Perché continua a essere di tendenza
AirLLM non è nuovo. Esiste da abbastanza tempo da essere familiare a chi segue da vicino l'inferenza locale. Ricompare nelle liste di tendenza per un motivo che ha meno a che fare con l'implementazione specifica che con la pressione che c'è dietro.
I modelli a pesi aperti continuano a crescere. I migliori modelli aperti di immagini, video e linguaggio si collocano ormai saldamente in una fascia che nessuna scheda grafica di consumo può contenere comodamente. Allo stesso tempo, il prezzo delle schede con molta memoria in grado di contenerli è salito, non sceso, spinto dalla stessa domanda che sta ridisegnando il resto del mercato hardware. Il divario tra ciò che è possibile eseguire e ciò che è possibile eseguire su hardware accessibile continua ad allargarsi.
Qualsiasi progetto che contrasta quel divario, anche in modo imperfetto, continuerà a trovare un pubblico. L'alternativa è un mondo in cui la frontiera dei modelli aperti è teoricamente disponibile a tutti e praticamente solo a chi ha un data center. Gli aggiramenti sono il modo in cui l'aperto dei pesi aperti resta onesto.
Cosa non risolve
Qui si confondono due cose diverse. Eseguire un modello grande su una GPU piccola è un problema di memoria. Ottenere un output utile da un modello grande è una questione di capacità, e le due non sono la stessa cosa. Un modello da 2,8 trilioni di parametri trasmesso attraverso una scheda da 4 GB genera comunque testo a un ritmo dettato dal suo disco e dalla sua banda, e la qualità di quel testo è quella del modello, non quella che l'aggiramento ha reso possibile.
C'è anche una dimensione di licenza che il risultato tecnico non tocca. Il poter eseguire un modello in locale non dice nulla sul fatto che ti sia consentito usarne i pesi per il tuo scopo. La configurazione di inferenza locale più impressionante del mondo resta vincolata ai termini legati al modello che esegue.
Il punto più ampio
La frontiera dell'IA locale non è una singola svolta. È una lunga serie di decisioni ingegneristiche poco appariscenti su dove vivono i dati, quando si spostano e quanto sei disposto ad aspettare. AirLLM ne è un buon esempio perché è molto schietto sullo scambio: rinunci alla velocità e in cambio puoi eseguire qualcosa che non doveva entrarci.
Per un numero crescente di persone a cui importa più ciò che un modello può fare di quanto sia veloce a farlo, è un patto ragionevole. E per tutti gli altri è un promemoria: questo modello richiede X gigabyte è una decisione di progettazione tanto quanto un limite hardware. Qualcuno, da qualche parte, cerca sempre la scrivania più piccola del libro.
Articoli correlati
L'agente indipendente dall'harness: eseguire qualsiasi modello di frontiera sulla propria macchina
Il modello è l'intelligenza, l'harness è l'idraulica, e i due non devono vivere nello stesso pacchetto. Un gruppo di progetti open source scioglie questo legame per eseguire qualsiasi modello di frontiera dall'interfaccia che preferisci, con accesso locale per impostazione predefinita.
Un bit basta: perché il BitNet di Microsoft continua a conquistare
Un peso a un bit non è un espediente. Come lo schema ternario del BitNet di Microsoft sostituisce la moltiplicazione con la somma, fa girare grandi modelli su una CPU comune e a quale prezzo.
Il nuovo manuale di regole del video con IA: le etichette leggibili dalla macchina ai sensi dell'EU AI Act
L'articolo 50 dell'EU AI Act fa dei metadati di provenienza una questione di conformità. L'etichetta viene incorporata alla generazione e la pipeline la perde facilmente.
Il tuo agente IA dimentica tutto: i trucchi MCP che risolvono il gonfiore del contesto
Un agente non diventa più intelligente girando a lungo, diventa più ottuso perché il suo context window si riempie di spazzatura. Dal sandboxing dell'output degli strumenti alla memoria persistente e al routing, questi progetti riparano la memoria dell'agente.