
一次十张参考图:AI 图像编辑从单张生成迈向合成
很长一段时间里,AI 图像编辑意味着一张参考图和一条指令。给模型看一张照片,告诉它要改什么,然后得到结果。这覆盖了很多场景,却忽略了人们实际思考图像的方式——往往是把多个来源组合成一个。
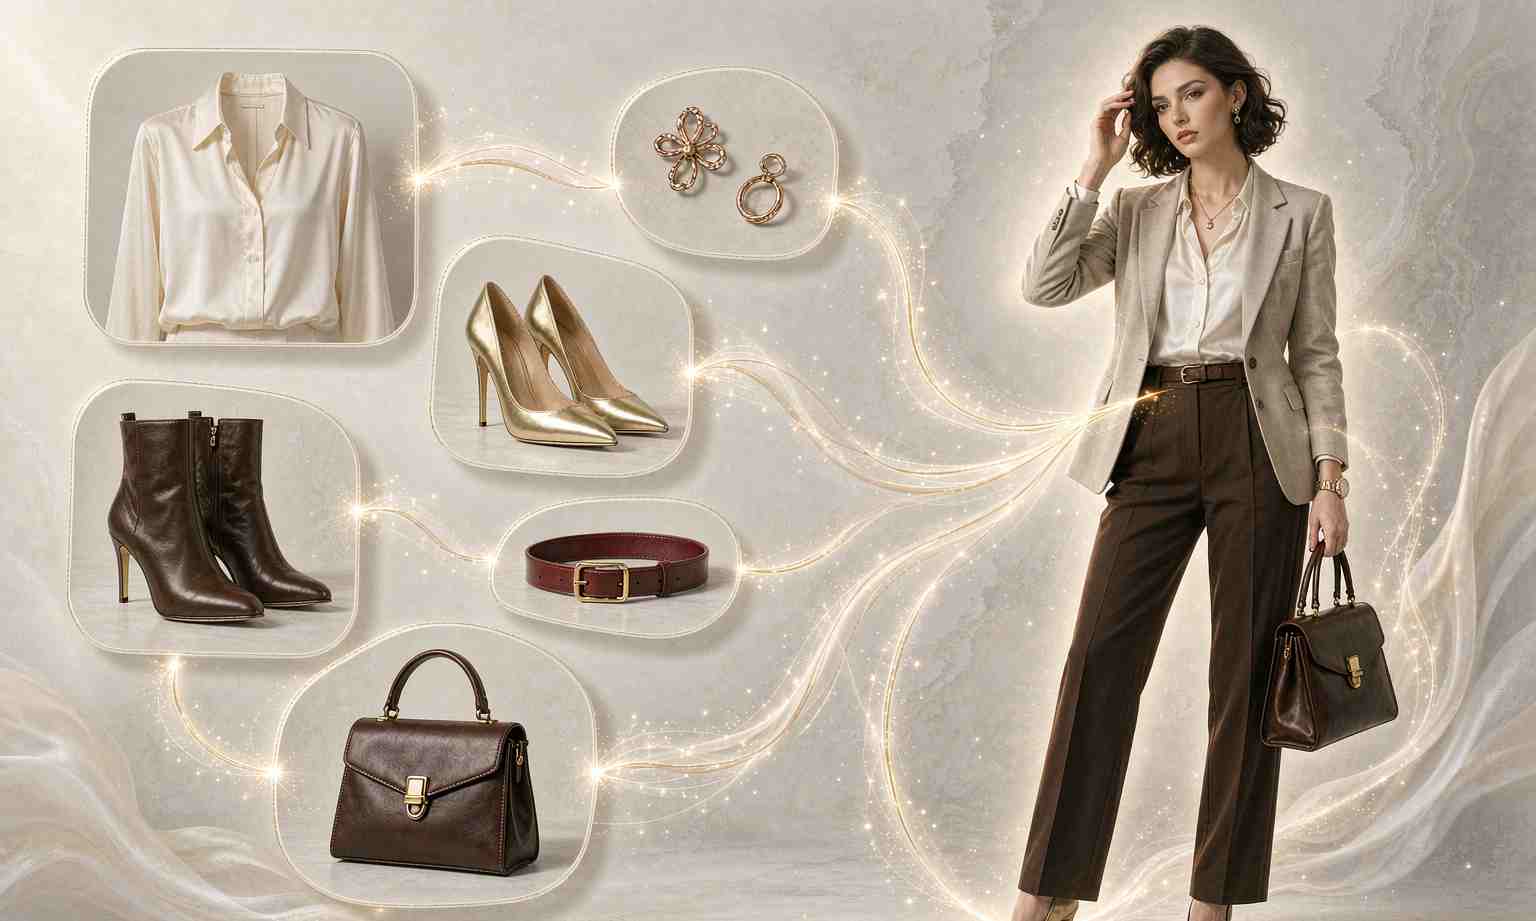
Qwen-Image 2.1 将参考图数量提升到了十张。该模型可以把六张独立的人像合并成一张合影,或者用模特、衬衫、鞋子、包和帽子各一张参考图,拼出一套完整穿搭。这与单图编辑是不同类型的任务,而这类任务在实际工作中不断出现。
想想实际案例。一个品牌想要一张宣传图,把旗下三款产品布置在同一场景中,每款产品都提供单独的照片。婚礼摄影师想把多张照片合成一张。时尚卖家想展示由商品目录中的单品搭出的完整造型。角色设计师想让一张脸在十几个变体中保持一致。单参考图编辑会迫使你不断重新生成和修补,一次只能输入一张图,并指望模型保持其他所有内容一致。多参考图编辑则让你把各个部分交给模型,让它去合成。
困难之处一直在于计算。更多参考图意味着更多 token,而更多 token 通常意味着生成更慢、内存占用更高。如果天真地把十张参考图输入模型,并在扩散过程的每一步都重新编码它们,成本会急剧膨胀,这个功能除了数据中心 GPU 外几乎无法使用。Qwen 对此采用的方法是混合粒度注意力方案。文本指令使用 token 级因果掩码,而图像生成使用块级掩码。KV 缓存复用方案让参考图和指令只需计算一次,并在各步骤中作为静态上下文复用,而不是每一步都重新计算。
这个思路很简单。如果参考图在生成过程中不会改变,就没有理由在每一步重新编码它们。计算一次,缓存起来,把算力花在真正会变化的部分上。这类工程不会登上头条,却决定了一个功能能否在消费级硬件上真正可用。规格表上的“支持十张参考图”和实际中“支持十张参考图且不会超时”之间的差别,恰恰就是这种缓存。
从两张参考图到十张,不只是数字变大。它改变了你能描述的东西。单图编辑产生变体,也就是同一张图被修改。多图编辑产生组合,也就是由多个部分拼装出的新图片,而很多商业价值正存在于组合之中。产品摄影、合影、造型画册、场景合成、基于一组素材的分镜,当模型能同时容纳多个输入并推理它们如何组合时,这一切都会打开。
这也标志着图像模型的一个更广泛方向。早期模型是文本生成图像:描述一个场景,得到一张图片。随后出现了图生图编辑:给一张图,描述一处修改。如今前沿是合成:向模型输入许多素材,让它推理它们如何组合。这更接近人类设计师的工作方式——用零件组装,而不是从零描述——也指向那些行为更像协作者而非生成器的模型。
还有一个值得注意的隐私与控制角度。当模型能从十张参考图合成时,用户对输入保持控制。与其描述一个产品并指望模型准确渲染它,不如把实际的产品照片输入进去。与其描述一个人,不如在适用的同意边界内输入其真实图像。从某种意义上说,多参考图编辑是迈向有依据生成的一步,模型锚定于真实素材,而不是根据文本描述产生幻觉。
仍然存在真实限制。在一张图中对多个人物保持身份一致仍然很棘手,而且你输入的参考图越多,模型就越有可能混淆它们之间的属性:错误的脸出现在错误的身体上,错误的颜色出现在错误的物体上。十张图的上限是一步进展,而不是已经解决的问题,随着输入数量增长,失败模式也会变得更怪异。团队显然已经做了工程工作来让它变快,但质量方面的工作仍在继续。
局部编辑控制是同一套功能的一部分。你可以画圈、涂抹标注,或者传入单独的蒙版图像,把编辑定位到一个区域而不影响其余部分。与多参考图输入结合后,这开始看起来像一个真正的合成工具——过去需要在图形编辑器里用图层完成的事情,现在可以表达为一组参考图和指令,交给单一模型处理。
对于任何构建创意工具的人来说,教训很直接。下一波差异化不是“更好的单张图像”,而是“模型一次能容纳并组合多少东西,以及你能多精确地告诉它要改什么”。十张参考图是当前答案。它不会长期停留在十张。
值得为这件事套上一个更广阔的框架。多年来,AI 图像生成的承诺是“描述它,得到它”。这个承诺对休闲使用有效,但对专业人士从未完全奏效,因为专业人士很少从空白描述开始。他们从素材开始:一张产品照片、一张参考图、一份品牌指南、一张必须保持一致的脸。向多参考图编辑的转变,本质上是向这一现实的让步。模型正在被教导从用户已经拥有的东西出发,而不是从用户能描述的东西出发。
这就是工程重要的原因。在上下文中保持十张参考图并让它们彼此区分,不只是保持一张的放大版。这是一个不同的问题,就像记住一张脸与记住十个人、并且能在合影中分辨他们之间的区别。Qwen 描述的块级掩码和 KV 缓存复用,是解决该问题的具体技术,而正是这类细节决定了一个功能是在实践中可用,还是只在演示中可用。
商业影响很直接。多参考图编辑解锁的工作流——产品合成、合影肖像、造型画册、品牌素材生成——都是人们当前要付费的事情,无论是为工具付费还是为人力付费。如果模型能足够好地完成它们,价值就会从合成的人力劳动转向模型容纳与组合的能力。这是一次真正的经济转变,也正是为什么这个功能,比那些对基准测试友好的功能,更值得关注,以判断行业实际走向。
还有一个容易被忽略的创意角度。多参考图编辑改变了什么才算“提示”。输入十张参考图的用户不是在写描述,而是在策划一组素材,决定包含什么、舍弃什么。这更接近艺术指导,而不是提示工程,并指向一个未来:在 AI 图像工作中,创意行为既关乎语言,也同样关乎选择与组合。从这个意义上说,十张参考图的上限是迈向图像模型的第一个真正步骤——这些模型把用户视为导演,而不是请求者。
相关文章
原生透明正悄然成为 AI 图像中最实用的新功能
人人都要真实感。设计师要的是透明背景。为什么原生 Alpha 通道生成这个低调功能,正在改变真实工作流。
阿里巴巴 Qwen-Image 2.1 刚刚改变了开放模型许可的讨论
技术规格令人印象深刻,但许可证才是真正的故事。Qwen-Image 2.1 弃用 Apache 2.0,转而采用研究许可证,而细则如今比以往任何时候都更重要。
通义万相 Qwen-Image 2.1 开源:7B 小模型如何把透明图和 10 图编辑装进一张消费级显卡
一个 7B 的开源生图模型,凭什么把透明图、多图编辑装进一张 6G 显卡?拆解 Qwen-Image 2.1 的核心升级与授权转折。
你还能分辨AI图片和真实照片吗?诚实的答案是不能。
破绽已经消失,检测器也不可靠。对于识别AI图片,诚实的答案是不能,而解决之道在你眼睛的上游。