
Zehn Referenzbilder auf einmal: KI-Bildbearbeitung bewegt sich von Einzelaufnahmen zu Kompositen
Lange Zeit bedeutete KI-Bildbearbeitung ein Referenzbild und eine Anweisung. Man zeigte dem Modell ein Foto, sagte ihm, was geändert werden soll, und erhielt ein Ergebnis. Das deckte viel ab, verfehlte aber die Art und Weise, wie Menschen tatsächlich über Bilder denken, nämlich oft in Kategorien des Kombinierens mehrerer Quellen zu einem Ganzen.
Qwen-Image 2.1 erhöht die Referenzanzahl auf zehn. Das Modell kann sechs einzelne Porträts nehmen und sie zu einem einzigen Gruppenfoto zusammenfügen oder ein vollständiges Outfit aus einem Model, einem Hemd, Schuhen, einer Tasche und einem Hut zusammenstellen, jeweils eine Referenz. Das ist eine andere Art von Aufgabe als die Einzelbildbearbeitung, und es ist die Art von Aufgabe, die in der realen Arbeit ständig vorkommt.
Denken Sie an die praktischen Fälle. Eine Marke möchte ein Kampagnenbild, in dem drei ihrer Produkte in einer Szene angeordnet sind, wobei jedes Produkt als separates Foto bereitgestellt wird. Ein Hochzeitsfotograf möchte mehrere Aufnahmen zu einer kombinieren. Ein Modehändler möchte einen kompletten Look zeigen, der aus Katalogteilen zusammengesetzt ist. Ein Charakterdesigner möchte ein Gesicht über ein Dutzend Variationen hinweg konsistent halten. Einzelreferenz-Bearbeitung zwingt Sie dazu, neu zu generieren und zu flicken, jeweils ein Bild einzuspeisen und zu hoffen, dass das Modell alles andere konsistent hält. Multi-Referenz-Bearbeitung lässt Sie dem Modell die Teile einspeisen und es zusammensetzen.
Der schwierige Teil war schon immer der Rechenaufwand. Mehr Referenzbilder bedeuten mehr Tokens, und mehr Tokens bedeuten normalerweise langsamere Generierung und mehr Speicherbedarf. Wenn Sie naiv zehn Referenzen in ein Modell einspeisen und sie bei jedem Schritt des Diffusionsprozesses neu kodieren, explodieren die Kosten, und die Funktion wird auf allem außer einer Datacenter-GPU unbrauchbar. Qwens Ansatz dafür ist ein Attention-Schema mit gemischter Granularität. Textanweisungen erhalten eine kausale Maske auf Token-Ebene, während die Bildgenerierung eine Maske auf Chunk-Ebene erhält. Ein KV-Cache-Wiederverwendungsschema ermöglicht es, die Referenzbilder und Anweisungen einmal zu berechnen und als statischen Kontext über die Schritte hinweg wiederzuverwenden, statt sie bei jedem Schritt neu zu berechnen.
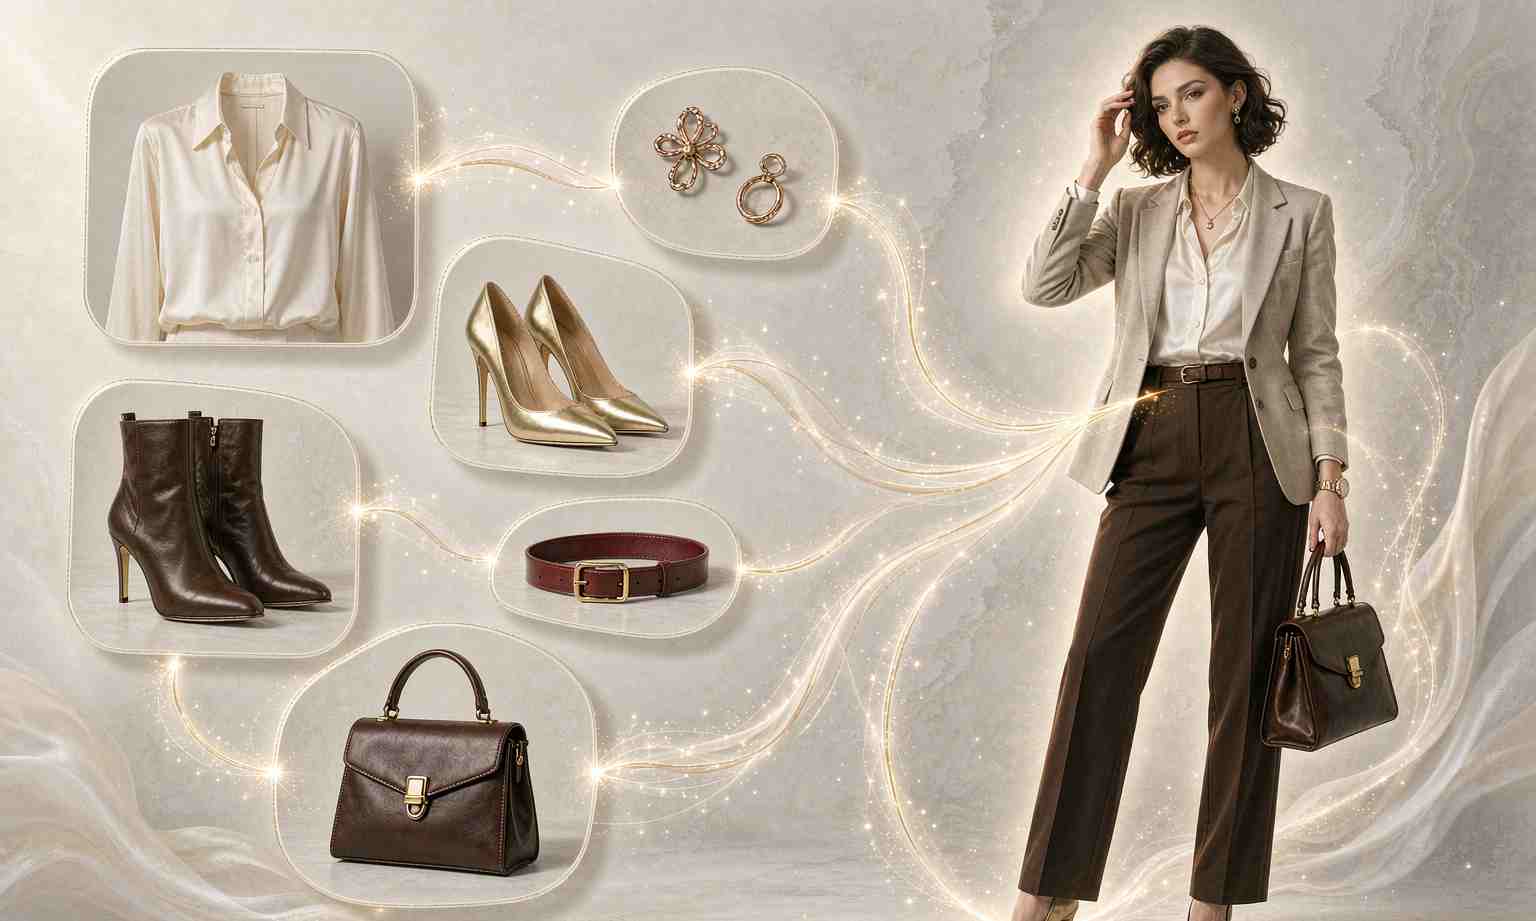
Die Idee ist einfach genug. Wenn sich die Referenzen während der Generierung nicht ändern, gibt es keinen Grund, sie bei jedem Schritt neu zu kodieren. Berechnen Sie sie einmal, cachen Sie sie, und verwenden Sie die Rechenleistung für die Teile, die sich tatsächlich ändern. Das ist die Art von Engineering, die keine Schlagzeilen macht, aber darüber entscheidet, ob eine Funktion auf Consumer-Hardware tatsächlich nutzbar ist. Der Unterschied zwischen „unterstützt zehn Referenzen“ auf einem Datenblatt und „unterstützt zehn Referenzen ohne Timeout“ in der Praxis ist genau diese Art von Caching.
Der Sprung von zwei Referenzen auf zehn ist mehr als eine größere Zahl. Er verändert, was Sie beschreiben können. Einzelbildbearbeitung erzeugt Variationen, dasselbe Bild verändert. Mehrbildbearbeitung erzeugt Kombinationen, neue Bilder, die aus Teilen zusammengesetzt sind, und in Kombinationen steckt viel kommerzieller Wert. Produktfotografie, Gruppenporträts, Lookbooks, Szenenkomposition, Storyboarding aus einem Satz von Assets – all das öffnet sich, wenn das Modell mehrere Eingaben gleichzeitig halten und darüber nachdenken kann, wie sie zusammenpassen.
Das signalisiert auch eine breitere Richtung für Bildmodelle. Die frühen Modelle waren Text-zu-Bild: Beschreiben Sie eine Szene, erhalten Sie ein Bild. Dann kam Bild-zu-Bild-Bearbeitung: Geben Sie ein Bild, beschreiben Sie eine Änderung. Jetzt ist die Grenze die Komposition: Man speist viele Eingaben in ein Modell ein und lässt es darüber nachdenken, wie sie sich kombinieren. Das kommt der Arbeitsweise eines menschlichen Designers näher, der aus Teilen zusammensetzt, statt von Grund auf zu beschreiben, und es weist auf Modelle hin, die sich weniger wie Generatoren und mehr wie Kollaborateure verhalten.
Es gibt einen Datenschutz- und Kontrollaspekt, der erwähnenswert ist. Wenn ein Modell aus zehn Referenzen komponieren kann, behält der Nutzer die Kontrolle über die Eingaben. Statt ein Produkt zu beschreiben und zu hoffen, dass das Modell es akkurat rendert, speisen Sie das tatsächliche Produktfoto ein. Statt eine Person zu beschreiben, speisen Sie ihr reales Bild ein, innerhalb der jeweils geltenden Einwilligungsgrenzen. Multi-Referenz-Bearbeitung ist in gewissem Sinne ein Schritt hin zu geerdeter Generierung, bei der das Modell an realen Assets verankert ist, statt aus einer Textbeschreibung zu halluzinieren.
Es gibt noch echte Grenzen. Die Identitätsbewahrung über mehrere Personen in einem Bild hinweg bleibt knifflig, und je mehr Referenzen Sie einspeisen, desto größer ist die Chance, dass das Modell Attribute zwischen ihnen verwechselt – das falsche Gesicht am falschen Körper, die falsche Farbe am falschen Objekt. Die Obergrenze von zehn Bildern ist ein Schritt, kein gelöstes Problem, und die Fehlerarten werden seltsamer, je mehr Eingaben es gibt. Das Team hat eindeutig die Engineering-Arbeit geleistet, um es schnell zu machen, aber die Qualitätsarbeit läuft weiter.
Die lokalen Bearbeitungskontrollen sind Teil desselben Pakets. Sie können Kreise zeichnen, Anmerkungen malen oder ein separates Maskenbild übergeben, um eine Bearbeitung auf einen Bereich zu richten, ohne den Rest zu berühren. In Kombination mit Multi-Referenz-Eingabe beginnt dies wie ein echtes Compositing-Werkzeug auszusehen – die Art von Sache, für die früher Ebenen in einem Grafikeditor nötig waren und die jetzt als Satz von Referenzen und Anweisungen an ein einzelnes Modell ausdrückbar ist.
Für alle, die kreative Werkzeuge bauen, ist die Lektion klar. Die nächste Welle der Differenzierung sind nicht „bessere einzelne Bilder“. Sie ist: „Wie viele Dinge kann das Modell gleichzeitig halten und kombinieren, und wie präzise können Sie ihm sagen, was geändert werden soll?“ Zehn Referenzen sind die aktuelle Antwort. Es wird nicht lange bei zehn bleiben.
Es gibt einen breiteren Rahmen, den man darum spannen sollte. Jahrelang lautete das Versprechen der KI-Bildgenerierung: „Beschreibe es, bekomme es.“ Dieses Versprechen funktionierte für den Gelegenheitsgebrauch, aber für Profis funktionierte es nie so richtig, denn Profis beginnen selten mit einer leeren Beschreibung. Sie beginnen mit Assets – einem Produktfoto, einem Referenzbild, einer Markenrichtlinie, einem Gesicht, das konsistent bleiben muss. Die Bewegung hin zur Multi-Referenz-Bearbeitung ist im Kern ein Zugeständnis an diese Realität. Dem Modell wird beigebracht, von dem auszugehen, was der Nutzer bereits hat, statt von dem, was der Nutzer beschreiben kann.
Deshalb ist das Engineering wichtig. Zehn Referenzen im Kontext zu halten und sie voneinander unterscheidbar zu halten, ist nicht einfach eine größere Version davon, eine zu halten. Es ist ein anderes Problem – der Unterschied zwischen dem Erinnern an ein einzelnes Gesicht und dem Erinnern an zehn Personen, gut genug, um sie auf einem Gruppenfoto auseinanderzuhalten. Die Chunk-Level-Maskierung und die KV-Cache-Wiederverwendung, die Qwen beschreibt, sind die spezifischen Techniken zur Lösung dieses Problems, und sie sind die Art von Detail, die darüber entscheidet, ob die Funktion in der Praxis funktioniert oder nur in einer Demo.
Die kommerzielle Implikation ist direkt. Die Workflows, die Multi-Referenz-Bearbeitung freischaltet – Produkt-Compositing, Gruppenporträts, Lookbooks, Marken-Asset-Generierung –, sind alles Dinge, für die Menschen derzeit bezahlen, sei es in Werkzeugen oder in Arbeitsleistung. Wenn ein Modell sie gut genug erledigen kann, verschiebt sich der Wert von der menschlichen Arbeit des Compositings hin zur Fähigkeit des Modells, zu halten und zu kombinieren. Das ist ein echter wirtschaftlicher Wandel, und deshalb ist diese Funktion, mehr als die benchmarkfreundlichen, diejenige, die man beobachten sollte, um zu sehen, wohin die Branche tatsächlich steuert.
Es gibt auch einen kreativen Aspekt, der leicht zu übersehen ist. Multi-Referenz-Bearbeitung verändert, was als „Prompting“ gilt. Ein Nutzer, der zehn Referenzen einspeist, schreibt keine Beschreibung, sondern kuratiert ein Set, trifft Entscheidungen darüber, was aufgenommen und was weggelassen wird. Das ist näher an Art Direction als an Prompt Engineering, und es weist auf eine Zukunft hin, in der der kreative Akt in der KI-Bildarbeit ebenso sehr Auswahl und Kombination betrifft wie Sprache. Die Obergrenze von zehn Referenzen ist in diesem Sinne der erste echte Schritt hin zu Bildmodellen, die den Nutzer als Regisseur statt als Anfrager behandeln.
Verwandte Artikel
Training von Text-zu-Bild-Modellen ist gerade 3,6-mal schneller geworden
Die Effizienzgrenze bewegt sich genauso schnell wie die Fähigkeitsgrenze. Eine 3,6-fache Trainingsbeschleunigung ist die Art von Fortschritt, die später als ein Modell auftaucht, das man tatsächlich ausführen kann.
Native Transparenz ist leise die nützlichste neue Funktion in KI-Bildern
Alle fragen nach Realismus. Designer fragen nach einem transparenten Hintergrund. Warum native Alpha-Kanal-Generierung die leise Funktion ist, die echte Workflows verändert.
Alibabas Qwen-Image 2.1 hat die Debatte um Open-Model-Lizenzen verändert
Die technischen Daten sind beeindruckend, doch die Lizenz ist die eigentliche Geschichte. Qwen-Image 2.1 ersetzt Apache 2.0 durch eine Forschungslizenz, und das Kleingedruckte zählt jetzt mehr denn je.
Tongyi Wanxiang Qwen-Image 2.1 Open Source: Wie ein 7B-Kleinmodell transparente Bilder und 10-Bild-Bearbeitung auf eine Consumer-GPU bringt
Ein quelloffenes 7B-Bildgenerierungsmodell – wie schafft es transparente Bilder und Mehrbildbearbeitung auf eine 6-GB-GPU? Zerlegung der zentralen Upgrades und Lizenzwende von Qwen-Image 2.1.