
一次十張參考圖:AI 圖像編輯從單張操作邁向合成
長期以來,AI 圖像編輯意味著一張參考圖像和一道指令。給模型看一張照片,告訴它要改什麼,就能得到結果。這涵蓋了很多情況,但忽略了人們實際上思考圖像的方式:往往是將多個來源組合成一張。
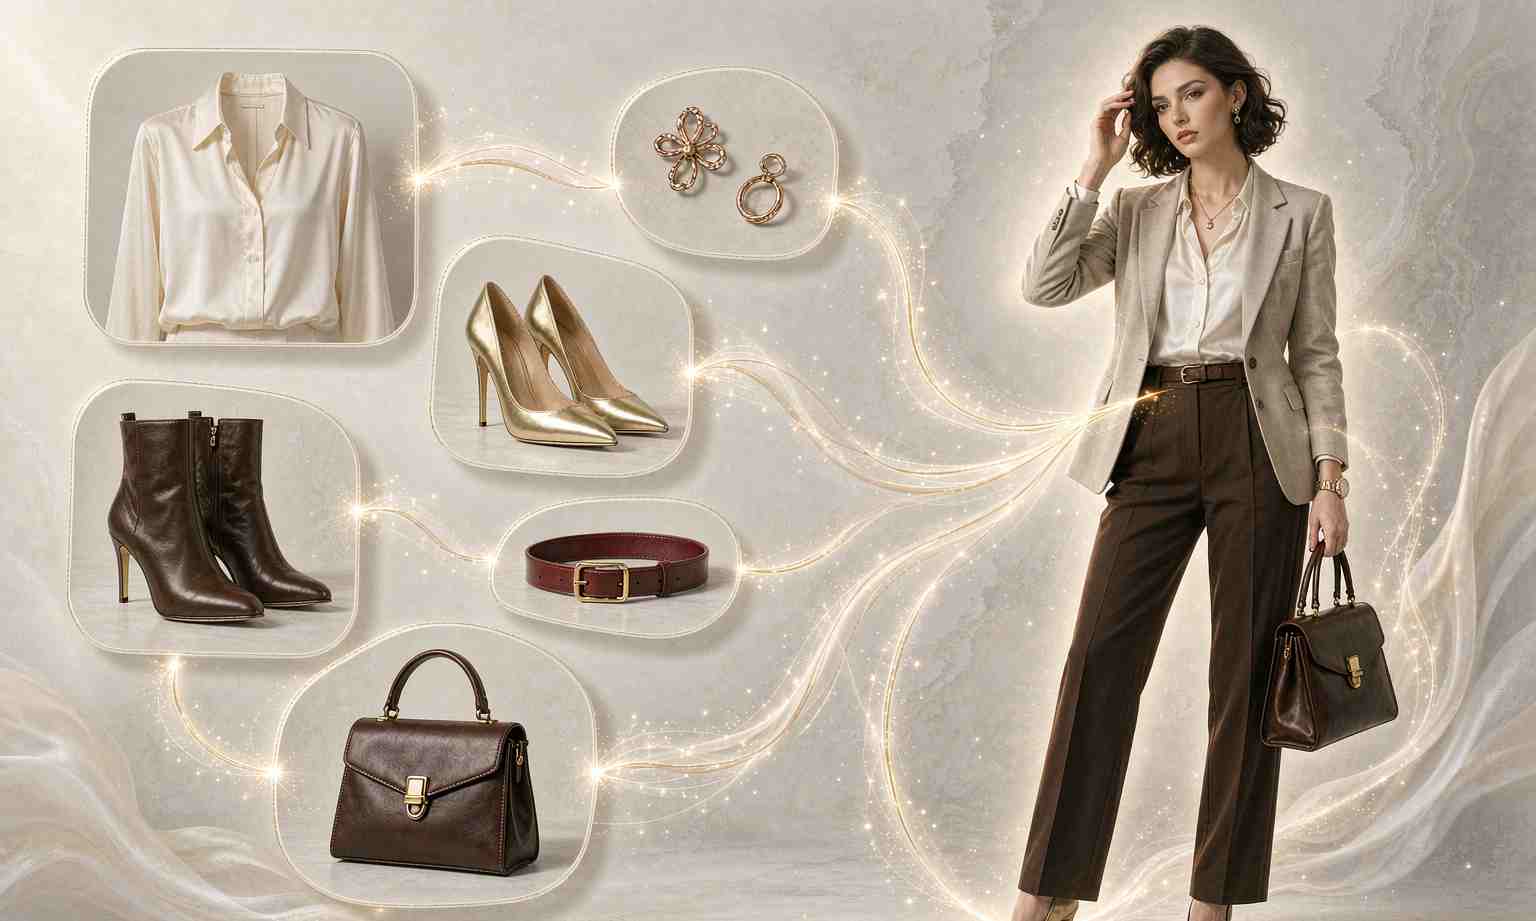
Qwen-Image 2.1 將參考圖數量提升到十張。這個模型可以取用六張各自獨立的人像,將它們合併成一張團體照;或從模特兒、襯衫、鞋子、包包和帽子各取一張參考圖,組合成一套完整穿搭。這與單圖編輯是不同類型的任務,而且這種任務在實際工作中不斷出現。
想想實際案例。某個品牌想要一張宣傳活動圖片,將旗下三項產品安排在一個場景中,每項產品都提供為獨立照片。婚禮攝影師想將幾張照片合成一張。時尚賣家想展示由型錄單品組成的完整造型。角色設計師想讓一張臉在十幾種變化中保持一致。單一參考圖編輯迫使你不斷重新生成和修補,一次餵入一張圖像,並希望模型讓其他一切保持一致。多重參考圖編輯則讓你將各個部分餵給模型,由它來進行合成。
困難的部分始終在於運算。更多參考圖像意味著更多 token,而更多 token 通常意味著生成更慢、記憶體用量更高。如果你天真地將十張參考圖餵入模型,並在擴散過程的每一步重新編碼它們,成本就會爆炸,而這個功能也將除了資料中心 GPU 之外都無法使用。Qwen 對此的做法是混合粒度注意力機制。文字指令使用 token 層級的因果遮罩,圖像生成則使用區塊層級的遮罩。KV 快取重用機制讓參考圖像和指令只需計算一次,並在後續步驟中作為靜態上下文重複使用,而不是每一步都重新計算。
這個想法很簡單。如果參考圖在生成過程中不會改變,就沒有理由在每一步重新編碼它們。將它們計算一次、快取起來,並把運算資源花在真正會改變的部分。這正是那種不會登上新聞頭條,卻決定了一項功能能否在消費級硬體上實際使用的工程設計。規格表上的「支援十張參考圖」與實務上的「支援十張參考圖且不會逾時」之間的差異,正是這種快取。
從兩張參考圖到十張參考圖的躍升,不只是數字變大。它改變了你所能描述的東西。單圖編輯產生的是變化,同一張圖片經過修改。多圖編輯產生的是組合,由各個部分組裝而成的新圖片,而大量商業價值正存在於組合之中。產品攝影、團體人像、穿搭型錄、場景合成、根據一組素材繪製分鏡腳本,當模型能一次容納多個輸入並推理它們如何搭配時,這一切都將成為可能。
這也預示了圖像模型更廣泛的發展方向。早期模型是文字轉圖像:描述一個場景,得到一張圖片。接著出現圖像轉圖像編輯:給它一張圖片,描述一項變更。現在的前沿是合成:將許多輸入餵給模型,讓它推理它們如何結合。這更接近人類設計師的工作方式,從部件進行組裝,而非從零開始描述,也指向那些行為不太像生成器、更像協作者的模型。
有一個隱私與控制的角度值得注意。當模型能從十張參考圖進行合成時,使用者仍掌控輸入內容。你不必描述一項產品,然後希望模型準確渲染它,而是直接餵入實際的產品照片。你不必描述一個人,而是餵入他們的真實圖像,並在適用的同意界線之內。多重參考圖編輯在某種意義上,是朝向有依據生成的一步:模型錨定於真實素材,而不是從文字描述中產生幻覺。
仍然存在真實的限制。在一張圖片中跨多個人保持身分一致性仍然很棘手,而且你餵入的參考圖越多,模型就越有可能混淆它們之間的屬性:錯誤的臉配到錯誤的身體、錯誤的顏色出現在錯誤的物件上。十張圖片的上限是一步進展,而不是已解決的問題,而且隨著輸入數量增加,失敗模式會變得更加怪異。團隊顯然已經完成了讓它變快的工程工作,但品質方面的工作仍在持續。
局部編輯控制是同一套功能的一部分。你可以畫圓圈、塗上標註,或傳入一張單獨的遮罩圖像,將編輯目標鎖定在某一區域而不影響其餘部分。結合多重參考圖輸入,這開始看起來像真正的合成工具,那種過去需要在圖形編輯器中使用圖層才能做到的事,現在可以表達為給單一模型的一組參考圖和指令。
對任何打造創意工具的人來說,教訓很直接。下一波差異化不是「更好的單張圖像」,而是「模型能一次容納並組合多少東西,以及你能多精確地告訴它要改變什麼」。十張參考圖是目前的答案。這個數字不會維持在十太久。
有一個更宏觀的框架值得套用在這個現象上。多年來,AI 圖像生成的承諾是「描述它,就能得到它」。這個承諾對一般休閒使用有效,但對專業人士卻始終不太管用,因為專業人士很少從空白描述開始。他們從素材開始:一張產品照、一張參考圖、一份品牌指南、一張必須保持一致臉孔。朝向多重參考圖編輯的轉變,核心上是對這個現實的讓步。模型正被教導從使用者已經擁有的東西開始,而不是從使用者能描述的東西開始。
這就是工程之所以重要的原因。在上下文中容納十張參考圖並讓它們保持區隔,不只是容納一張的放大版。這是不同的問題,就像記住一張臉與記住十個人、且要在團體照中足以分辨他們之間的差異。Qwen 所描述的區塊層級遮罩與 KV 快取重用,正是解決這個問題的具體技術,而這類細節決定了功能是在實務上可行,還是只存在於展示中。
商業意涵很直接。多重參考圖編輯所解鎖的工作流程,包括產品合成、團體肖像、穿搭型錄、品牌素材生成,全都是人們目前付費購買的東西,無論是付費使用工具還是支付人力。如果模型能做得夠好,價值就會從人工合成的勞動,轉移到模型容納與組合的能力上。這是真正的經濟轉變,也是為什麼這項功能,比起那些對基準測試友善的功能,更值得關注產業實際的走向。
還有一個容易被忽略的創意角度。多重參考圖編輯改變了什麼算是「提示」。餵入十張參考圖的使用者不是在寫描述,而是在策劃一組素材,做出要包含什麼、捨棄什麼的選擇。這更接近藝術指導,而非提示工程,也指向一個未來:在 AI 圖像工作中,創作行為既關乎語言,也同樣關乎選擇與組合。從這個意義上來說,十張參考圖的上限是朝向圖像模型把使用者視為導演、而非請求者的第一個真正步驟。
相關文章
原生透明正悄然成為 AI 圖像中最實用的新功能
大家都要求寫實感。設計師要求的是透明背景。為什麼原生 Alpha 通道生成,是那個默默改變真實工作流程的低調功能。
阿里巴巴的 Qwen-Image 2.1 剛剛改變了開源模型授權的討論
技術規格令人印象深刻,但授權才是真正的故事。Qwen-Image 2.1 放棄了 Apache 2.0,轉而採用研究授權,而細則現在比以往任何時候都更重要。
通義萬相 Qwen-Image 2.1 開源:7B 小模型如何把透明圖和 10 張圖編輯裝進一張消費級顯示卡
一個 7B 的開源生圖模型,憑什麼把透明圖、多圖編輯裝進一張 6G 顯示卡?拆解 Qwen-Image 2.1 的核心升級與授權轉折。
你還分得出 AI 圖像和真實照片嗎?老實說,不能。
破綻已經消失,偵測器也不可靠。辨識 AI 圖像的誠實答案是:沒辦法,而解決方案在你們眼球的上游。