
O LTX 2.5 quer renderizar seu esboço em blocos do Blender como uma tomada finalizada
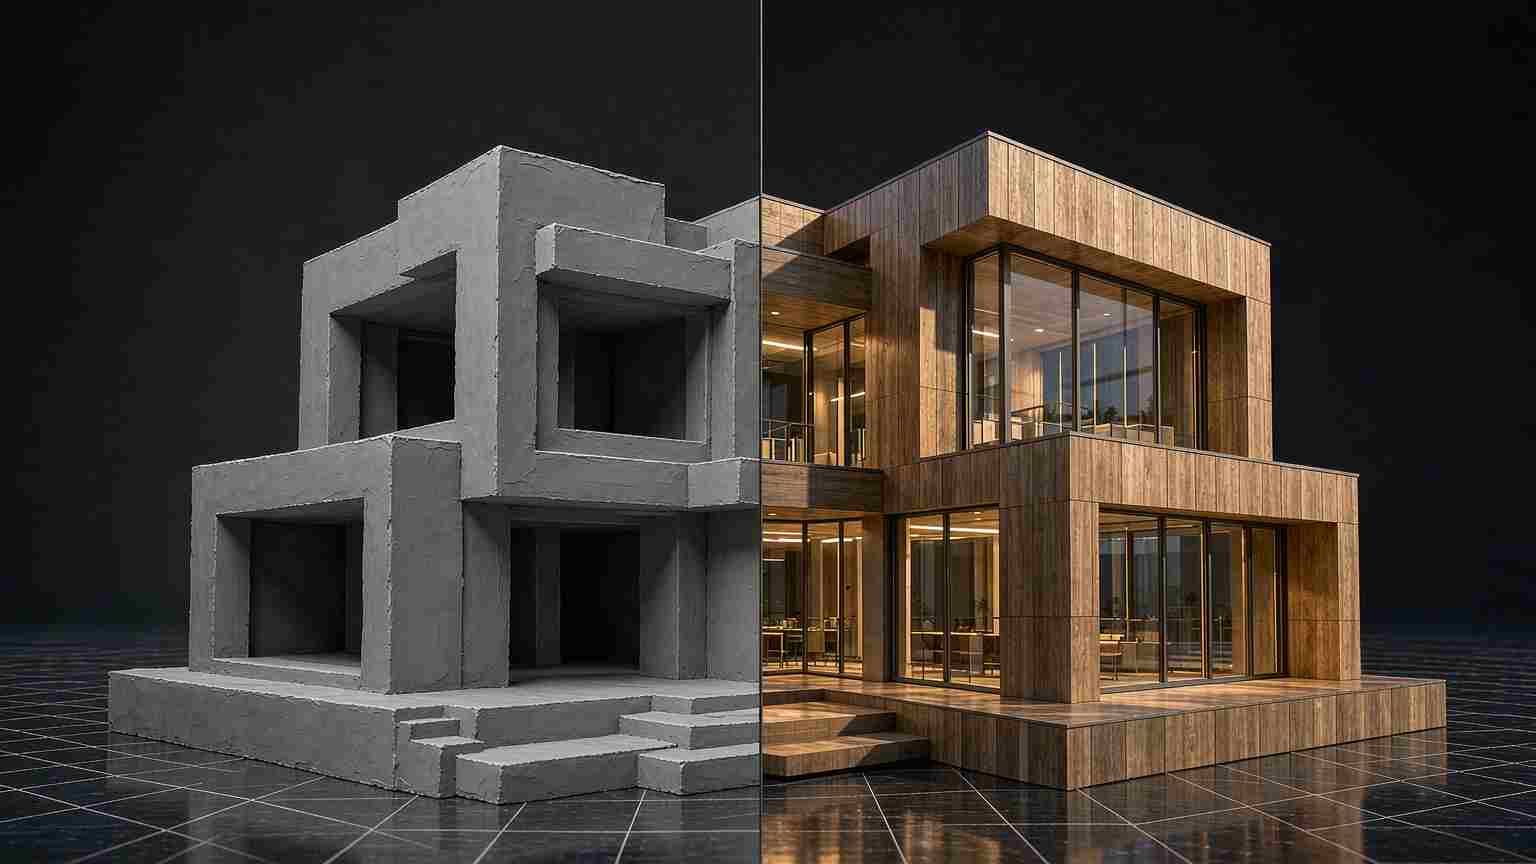
A Lightricks lançou um novo adaptador para seu modelo de vídeo LTX 2.5 que mira um problema muito específico e muito familiar: a lacuna entre uma animação 3D bruta e algo que você realmente mostraria a alguém.
A ferramenta é o que ela chama de Layout-to-Render, entregue como um IC-LoRA que roda no modelo de base LTX 2.5. Você alimenta com uma animação de viewport em clay ou um playblast de baixa qualidade, o tipo de prévia cinzenta em blocos que sai do Blender ou do Unreal, e ele renderiza a mesma tomada como um vídeo finalizado, iluminado e texturizado. Ele preserva o movimento de câmera, o enquadramento e a colocação dos objetos, e tira sua direção de arte de uma imagem de referência.
Por que esta é uma ferramenta de um tipo diferente
Quase todo gerador de vídeo no mercado funciona da mesma maneira. Você descreve o que quer, e o modelo decide tudo: para onde a câmera vai, o que o sujeito faz, como a cena se parece. Isso é bom para um clipe avulso. É inadequado para produção, onde o ponto central é que você decidiu o enquadramento de propósito.
O Layout-to-Render inverte a divisão do trabalho. O layout controla movimento e composição, porque você já fez o blocking em 3D. O modelo generativo cuida apenas do visual. Essa separação é o que torna a iteração de tomadas previsível, porque mudar o visual não bagunça a coreografia, e ajustar a câmera não exige gerar o clipe inteiro de novo e torcer para dar certo.
Para quem já passou uma tarde gerando clipes de texto para vídeo e descartando aqueles em que a câmera desviou alguns graus, isso ataca a reclamação real. O modo de falha do texto para vídeo não é que as imagens sejam feias. É que você não controla o que acontece. Um diretor que quer um push-in lento não quer gerar de novo até o modelo concordar. Ele quer especificar o push-in e seguir em frente.
O pipeline no qual ele se encaixa
O adaptador foi projetado para se encaixar nos fluxos de trabalho 3D existentes, em vez de substituí-los. Ele suporta Blender e Unreal e ferramentas similares, rodando por pipelines locais de ComfyUI e Python. A ideia é que um animador faça o blocking de uma tomada como sempre fez, renderize uma prévia barata e depois gaste poder computacional generativo no visual final, em vez de em adivinhação.
Isso é uma mudança significativa no propósito desses modelos. A primeira onda de geração de vídeo competia por espetáculo, por clipes que pareciam impressionantes isoladamente. A segunda onda, se isto for um sinal dela, compete por encaixe: quão limpo um modelo entra num pipeline que um profissional já usa, e quão pouco o profissional precisa mudar seu processo para extrair valor dele.
Há uma razão pela qual isso importa mais do que parece. Estúdios não adotam ferramentas que exigem reconstruir seu processo. Eles adotam ferramentas que se conectam ao processo que já têm. Um modelo que fala a linguagem das prévias de viewport e do blocking de tomadas encontra os animadores onde eles estão, o que é uma proposta muito diferente de um que pede que descrevam uma cena em um parágrafo.
Os custos honestos
Duas coisas moderam a promessa. A primeira é o hardware. O modelo LTX 2.5 de 22 bilhões de parâmetros e seu conjunto de dependências exigido elevam tanto o custo de configuração quanto os requisitos de VRAM, o que o coloca fora do alcance de usuários casuais e o empurra para pessoas que já têm uma máquina com GPU para trabalho 3D.
A segunda é que a saída é generativa, não precisa. O modelo não preserva a geometria no nível do pixel, então os artistas ainda precisam revisar o resultado em busca de continuidade, alinhamento e qualquer coisa que tenha derivado entre quadros. O áudio de origem não é mantido, e a contagem de quadros pode ser ajustada para se adequar ao formato suportado pelo pipeline. Esta é uma ferramenta de finalização, não um substituto do renderizador, e tratá-la como tal levará à decepção.
Os dois custos apontam para a mesma verdade prática: este é um software para pessoas que já têm um pipeline, e seu valor aparece em horas economizadas, não na capacidade de fazer algo impossível. Se você ainda não faz o blocking de tomadas em 3D, a ferramenta tem pouco a oferecer. Se faz, a aritmética muda rapidamente.
O que isso significa para a corrida do vídeo aberto
O próprio LTX 2.5 tem pesos abertos, e a história mais ampla dos últimos meses tem sido modelos de vídeo abertos se tornando genuinamente bons. Ferramentas como este adaptador são como essa abertura se transforma em adoção. Um modelo forte sem um fluxo de trabalho em volta é uma demo. Um modelo forte com um caminho layout-to-render, nós do ComfyUI e integração com Blender é algo que um estúdio pode realmente usar.
Há também um ponto mais silencioso sobre para onde a diferenciação está indo. Quando vários modelos conseguem produzir um belo clipe de cinco segundos a partir de um prompt de texto, a competição se desloca para o controle. Qual modelo permite especificar exatamente o que você quer, manter isso ao longo de uma sequência e mudar uma coisa sem quebrar o resto. O Layout-to-Render é a resposta da Lightricks a essa pergunta com um fluxo de trabalho 3D-first, apostando que as pessoas que mais se importam com controle são as que já pensam em tomadas.
O que ele não substitui
Vale deixar clara a fronteira. O Layout-to-Render não elimina a necessidade de trabalho em 3D. Alguém ainda precisa fazer o blocking da tomada, acertar a câmera e montar a cena. O que ele elimina é a caríssima etapa de render final e a tentativa e erro de tentar descrever uma tomada específica em palavras. Essa divisão se adequa à forma como os estúdios já alocam equipes em projetos: uma equipe pequena cuida do layout, e o orçamento de renderização vai para o desenvolvimento visual em vez de para iterar em movimentos de câmera. A ferramenta muda onde o esforço recai, não quanta imaginação o projeto exige.
A forma mais ampla disso
Vale nomear a trajetória aqui. A geração de vídeo começou como uma forma de criar clipes que não existiam. Está se tornando uma forma de fazer os clipes que você já planejou custarem menos para finalizar. Esses são produtos diferentes, voltados a compradores diferentes, e recompensam tipos diferentes de qualidade.
O primeiro tipo recompensa realismo e surpresa. O segundo recompensa fidelidade a um plano e previsibilidade ao longo de muitas tomadas. O adaptador do LTX 2.5 claramente mira o segundo, e é uma aposta razoável que o dinheiro na produção profissional de vídeo esteja aí. Um estúdio não precisa de um modelo que consiga inventar uma tomada. Precisa de um modelo que consiga renderizar a tomada que ele já desenhou, repetidas vezes, sem derivar.
Se o Layout-to-Render entrega isso em qualidade de produção é algo que os artistas vão decidir ao usá-lo. Mas a direção é a certa para as pessoas que pagam por este software, e só isso já faz dele mais do que outro gerador de clipes com um nome novo.
Artigos relacionados
Agility Digit 5 chega com um caso de segurança, não apenas uma ficha técnica
Um piso de armazém não é um laboratório. A certificação é o portão, não a demonstração.
Agentes de fronteira concluíram 30% de um workflow de pesquisa. Esse é o número.
Agentes conseguem executar pesquisa. Inventar o procedimento ainda está fora de alcance.
Figure AI garantiu US$ 3,5 bilhões em capacidade de computação antes mesmo de ter um produto para vender
A aposta é que a generalização é um problema de computação. O setor ainda não decidiu isso.
OpenAI finalmente coloca fundos transparentes na API de imagens
Um recurso pequeno que elimina uma etapa inteira do pipeline.