
LTX 2.5 vuole renderizzare la tua bozza Blender a blocchi in un'inquadratura finita
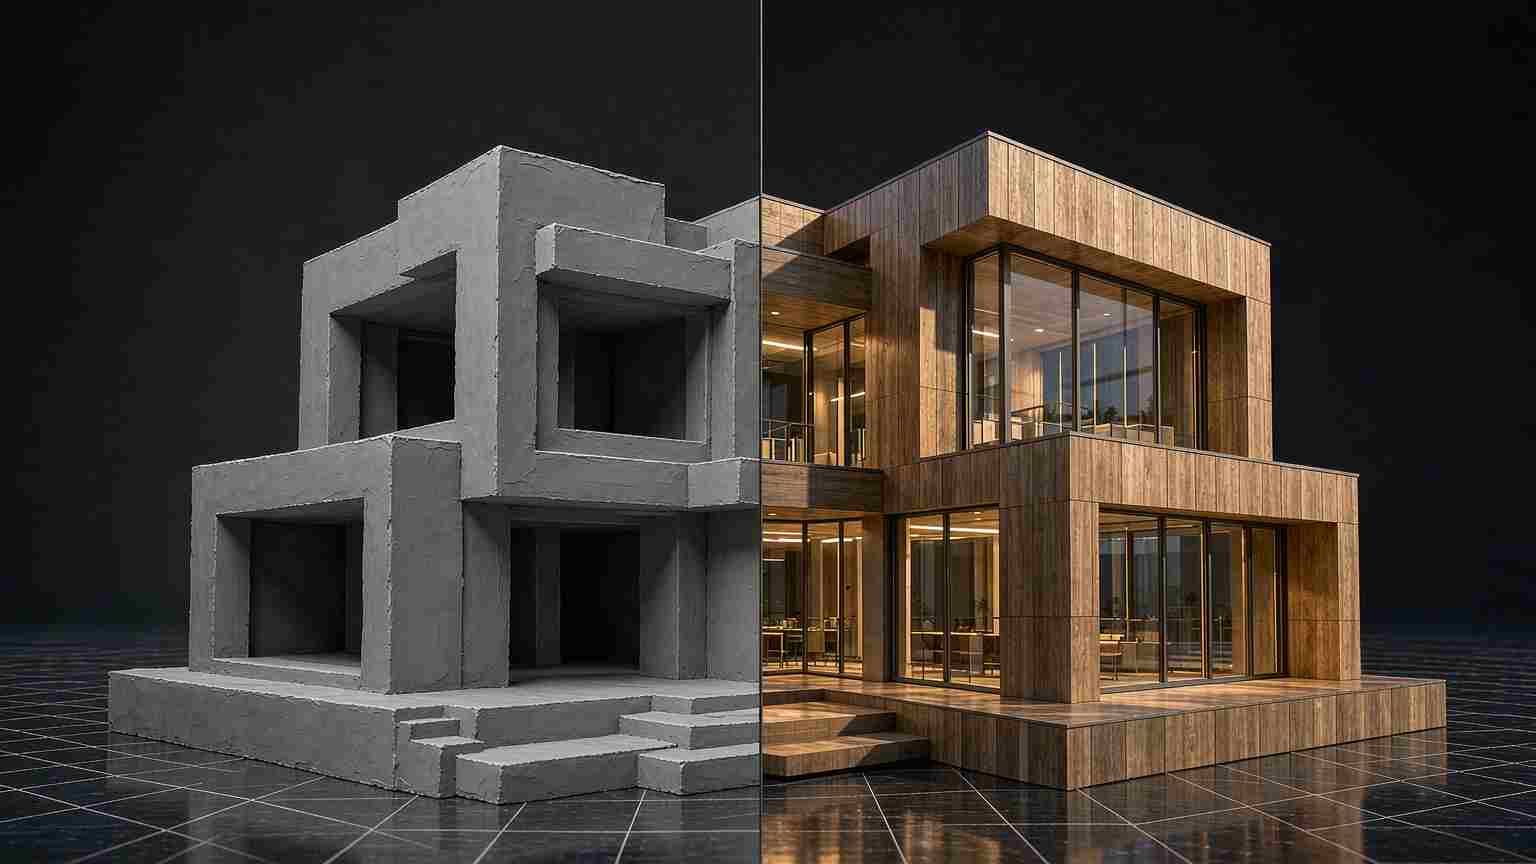
Lightricks ha rilasciato un nuovo adattatore per il suo modello video LTX 2.5 che affronta un problema molto specifico e molto familiare: il divario tra un'animazione 3D grezza e qualcosa che mostreresti davvero a qualcuno.
Lo strumento si chiama Layout-to-Render, fornito come IC-LoRA che gira sul modello di base LTX 2.5. Gli dai in input un'animazione viewport in stile clay o un playblast di bassa qualità, la tipica anteprima grigia a blocchi che esce da Blender o Unreal, e renderizza la stessa inquadratura come un video finito, illuminato e texturizzato. Preserva il movimento della camera, l'inquadratura e la disposizione degli oggetti, e prende la direzione artistica da un'immagine di riferimento.
Perché questo è un tipo diverso di strumento
Quasi ogni generatore video sul mercato funziona allo stesso modo. Descrivi ciò che vuoi, e il modello decide tutto: dove va la camera, cosa fa il soggetto, che aspetto ha la scena. Va bene per una clip una tantum. È inadatto alla produzione, dove il punto è che hai deciso l'inquadratura di proposito.
Layout-to-Render inverte la divisione del lavoro. Il layout controlla movimento e composizione, perché l'hai già impostato in 3D. Il modello generativo gestisce solo l'aspetto. È questa separazione a rendere prevedibile l'iterazione delle inquadrature, perché cambiare l'aspetto non scompagina la coreografia, e regolare la camera non richiede di rigenerare l'intera clip sperando bene.
Per chiunque abbia passato un pomeriggio a generare clip text-to-video e scartare quelle in cui la camera si era spostata di qualche grado, questo affronta il problema vero. Il modo in cui il text-to-video fallisce non è che le immagini siano brutte. È che non controlli ciò che succede. Un regista che vuole un lento push-in non vuole rigenerare finché il modello non è d'accordo. Vuole specificare il push-in e andare avanti.
La pipeline in cui si inserisce
L'adattatore è progettato per inserirsi nei flussi di lavoro 3D esistenti, non per sostituirli. Supporta Blender, Unreal e strumenti simili, funzionando tramite pipeline locali ComfyUI e Python. L'idea è che un animatore imposta un'inquadratura come ha sempre fatto, renderizza un'anteprima economica e poi spende potenza di calcolo generativa per l'aspetto finale invece che per tirare a indovinare.
È un cambiamento significativo in ciò a cui servono questi modelli. La prima ondata di generazione video competiva sullo spettacolo, su clip che sembravano impressionanti da sole. La seconda ondata, se questo ne è un segno, compete sull'integrazione: quanto pulitamente un modello si inserisce in una pipeline che un professionista già usa, e quanto poco il professionista deve cambiare il suo processo per trarne valore.
C'è un motivo se questo conta più di quanto sembri. Gli studi non adottano strumenti che richiedono di ricostruire il loro processo. Adottano strumenti che si innestano nel processo che già hanno. Un modello che parla la lingua delle anteprime viewport e dell'impostazione delle inquadrature incontra gli animatori dove sono, il che è una proposta molto diversa da quella di un modello che chiede loro di descrivere una scena in un paragrafo.
I costi onesti
Due cose temperano la promessa. La prima è l'hardware. Il modello LTX 2.5 da 22 miliardi di parametri e il suo stack richiesto aumentano sia il costo di configurazione sia i requisiti di VRAM, il che lo mette fuori portata per gli utenti occasionali e lo spinge verso chi ha già una postazione GPU per il lavoro 3D.
La seconda è che l'output è generativo, non accurato. Il modello non preserva la geometria a livello di pixel, quindi gli artisti devono comunque rivedere il risultato per continuità, allineamento e qualsiasi cosa sia andata alla deriva tra un frame e l'altro. L'audio sorgente non viene mantenuto, e il numero di frame può essere ridotto per adattarsi al formato supportato dalla pipeline. Questo è uno strumento di finitura, non un sostituto del renderer, e trattarlo come tale porterà a delusioni.
I due costi indicano la stessa verità pratica: questo è software per chi ha già una pipeline, e il suo valore si manifesta nelle ore risparmiate, non nella capacità di fare qualcosa di impossibile. Se non imposti già le inquadrature in 3D, lo strumento ha poco da offrire. Se lo fai, l'aritmetica cambia in fretta.
Che cosa significa per la corsa ai video open
LTX 2.5 stesso è open-weight, e la storia più ampia degli ultimi mesi è stata quella di modelli video aperti che diventano davvero buoni. Strumenti come questo adattatore sono il modo in cui quell'apertura si trasforma in adozione. Un modello forte senza un flusso di lavoro attorno è una demo. Un modello forte con un percorso layout-to-render, nodi ComfyUI e integrazione con Blender è qualcosa che uno studio può effettivamente usare.
C'è anche un punto più silenzioso su dove sta andando la differenziazione. Quando diversi modelli possono produrre una bellissima clip di cinque secondi da un prompt testuale, la competizione si sposta sul controllo. Quale modello ti permette di specificare esattamente ciò che vuoi, mantenerlo lungo una sequenza e cambiare una cosa senza rompere il resto. Layout-to-Render è la risposta di Lightricks a quella domanda con un flusso di lavoro 3D-first, scommettendo che le persone a cui importa di più il controllo siano quelle che già pensano per inquadrature.
Ciò che non sostituisce
Vale la pena essere chiari sul confine. Layout-to-Render non elimina la necessità del lavoro 3D. Qualcuno deve comunque impostare l'inquadratura, sistemare la camera e allestire la scena. Ciò che elimina è il costoso passaggio di render finale e le congetture del cercare di descrivere una specifica inquadratura a parole. Questa divisione si adatta al modo in cui gli studi già organizzano i progetti: una piccola squadra gestisce il layout, e il budget di rendering va verso lo sviluppo dell'aspetto invece che verso l'iterazione sui movimenti di camera. Lo strumento cambia dove finisce lo sforzo, non quanta immaginazione richiede il progetto.
Il quadro più ampio
Vale la pena dare un nome alla traiettoria. La generazione video è iniziata come un modo per creare clip che non esistevano. Sta diventando un modo per far costare meno il completamento delle clip che hai già pianificato. Questi sono prodotti diversi, rivolti a acquirenti diversi, e premiano tipi diversi di qualità.
Il primo tipo premia realismo e sorpresa. Il secondo premia fedeltà a un piano e prevedibilità su molte inquadrature. L'adattatore di LTX 2.5 è chiaramente rivolto al secondo, ed è una scommessa ragionevole che i soldi nella produzione video professionale stiano lì. Uno studio non ha bisogno di un modello che possa inventare un'inquadratura. Ha bisogno di un modello che possa renderizzare l'inquadratura che ha già disegnato, ancora e ancora, senza andare alla deriva.
Se Layout-to-Render offra questo a qualità di produzione è qualcosa che gli artisti decideranno usandolo. Ma la direzione è quella giusta per le persone che pagano per questo software, e già solo questo lo rende più di un altro generatore di clip con un nome nuovo.
Articoli correlati
Un semi-umanoide su ruote ha completato un'ora di lavanderia senza aiuto
I singoli compiti possono riuscire mentre un flusso di lavoro fallisce comunque. Dyna ha cambiato la metrica.
ServiceNow trasforma i fallimenti degli agenti in dati di addestramento
La generazione senza verifica è rumore. I cancelli sono il prodotto.
Un unico framework per linguaggio e visione: il modello aperto da 1,6 miliardi di Horizon
Una scommessa sul fatto che i ponti tra linguaggio e visione non siano mai stati necessari.
Il muro fotonico della memoria è la scommessa da 88 milioni di dollari che Volantis ha appena fatto
Il compromesso con cui tutti hanno imparato a convivere è la cosa che sta cercando di eliminare.