
Dez imagens de referência de uma vez: a edição de imagens com IA passa de tomadas únicas para composições
Por muito tempo, a edição de imagens com IA significava uma imagem de referência e uma instrução. Mostre ao modelo uma foto, diga o que mudar, receba um resultado. Isso cobria muita coisa, mas deixava de fora a forma como as pessoas realmente pensam sobre imagens, que frequentemente envolve combinar várias fontes em uma só.
O Qwen-Image 2.1 eleva o número de referências para dez. O modelo pode pegar seis retratos separados e mesclá-los em uma única foto de grupo, ou montar um look completo a partir de uma modelo, uma camisa, sapatos, uma bolsa e um chapéu, uma referência para cada. Esse é um tipo diferente de tarefa em relação à edição de imagem única, e é o tipo de tarefa que aparece constantemente no trabalho real.
Pense nos casos práticos. Uma marca quer uma imagem de campanha com três de seus produtos organizados em uma cena, cada produto fornecido como uma foto separada. Um fotógrafo de casamento quer combinar várias fotos em uma. Um vendedor de moda quer mostrar um visual completo montado a partir de peças de catálogo. Um designer de personagens quer manter um rosto consistente ao longo de uma dúzia de variações. A edição com referência única obriga você a regenerar e remendar, alimentando uma imagem por vez e torcendo para que o modelo mantenha todo o resto consistente. A edição com múltiplas referências permite fornecer as partes ao modelo e deixá-lo compor.
A parte difícil sempre foi computacional. Mais imagens de referência significam mais tokens, e mais tokens geralmente significam geração mais lenta e mais memória. Se você alimentar ingenuamente dez referências em um modelo e recodificá-las a cada etapa do processo de difusão, o custo explode, e o recurso se torna inutilizável em qualquer coisa que não seja uma GPU de datacenter. A abordagem da Qwen para isso é um esquema de atenção de granularidade mista. Instruções de texto recebem uma máscara causal em nível de token, enquanto a geração de imagem recebe uma máscara em nível de chunk. Um esquema de reuso de cache KV permite que as imagens de referência e as instruções sejam computadas uma vez e reutilizadas como contexto estático ao longo das etapas, em vez de serem recalculadas a cada passo.
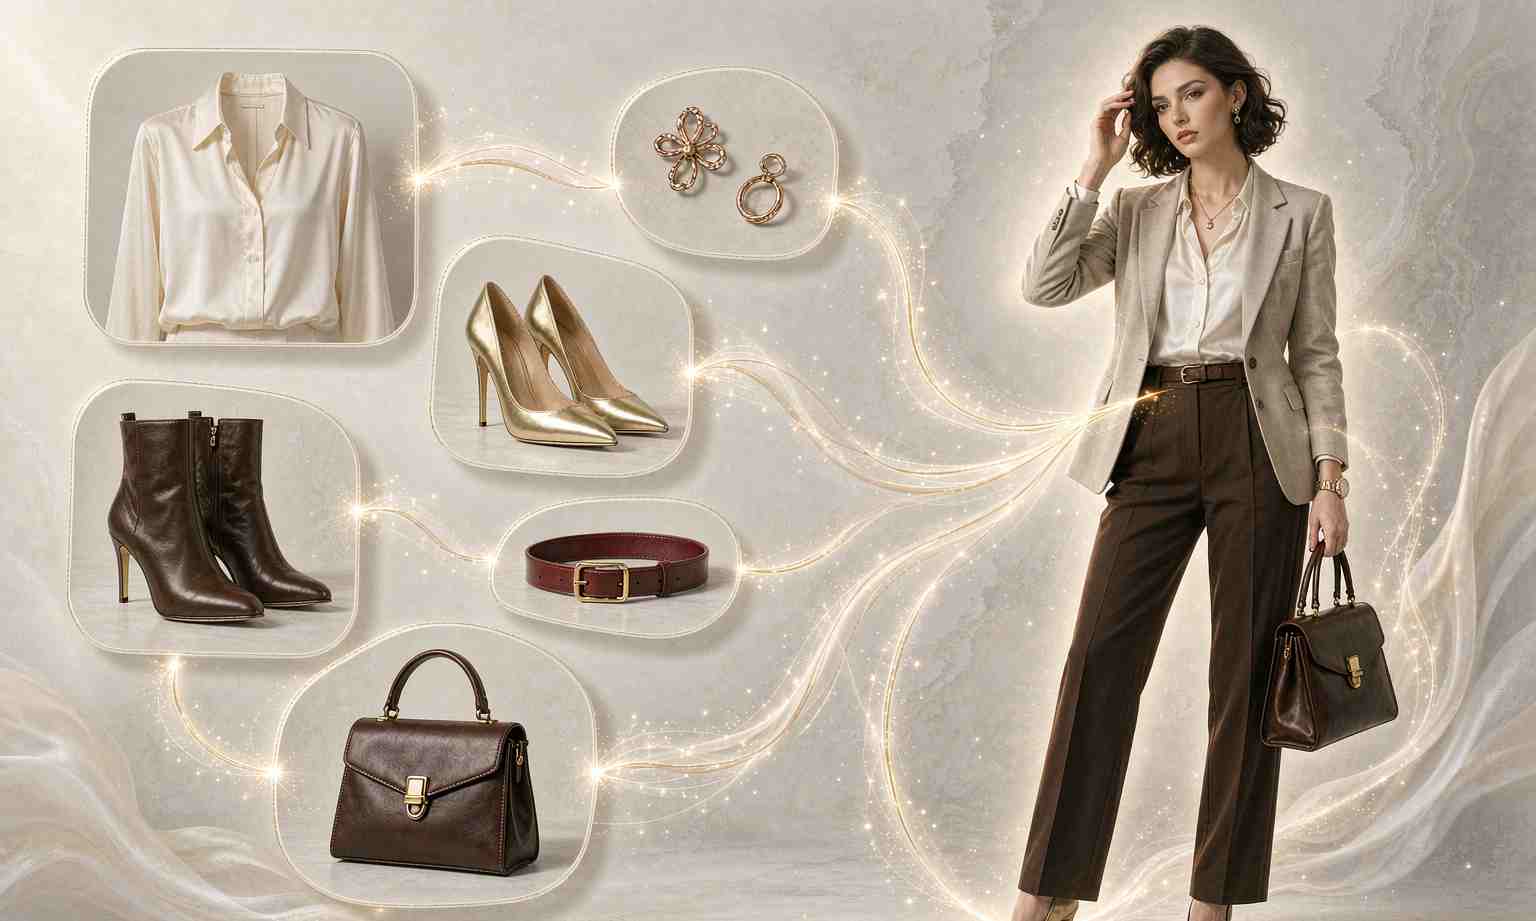
A ideia é bastante simples. Se as referências não mudam durante a geração, não há razão para recodificá-las a cada etapa. Calcule-as uma vez, armazene-as em cache e gaste o poder de computação nas partes que realmente mudam. Esse é o tipo de engenharia que não vira manchete, mas determina se um recurso é realmente utilizável em hardware de consumidor. A diferença entre “suporta dez referências” em uma ficha técnica e “suporta dez referências sem atingir o tempo limite” na prática é exatamente esse tipo de cache.
O salto de duas referências para dez é mais do que um número maior. Ele muda o que você pode descrever. A edição de imagem única produz variações, a mesma imagem alterada. A edição com múltiplas imagens produz combinações, novas imagens montadas a partir de partes, e combinações são onde reside muito valor comercial. Fotografia de produto, retratos em grupo, lookbooks, composição de cena, storyboards a partir de um conjunto de assets, tudo isso se abre quando o modelo consegue manter várias entradas ao mesmo tempo e raciocinar sobre como elas se encaixam.
Isso também sinaliza uma direção mais ampla para os modelos de imagem. Os primeiros modelos eram texto para imagem: descreva uma cena, receba uma imagem. Depois veio a edição imagem para imagem: dê uma imagem, descreva uma mudança. Agora a fronteira é a composição, alimentar um modelo com muitas entradas e deixá-lo raciocinar sobre como elas se combinam. Isso está mais próximo de como um designer humano trabalha, montando a partir de peças em vez de descrever do zero, e aponta para modelos que se comportam menos como geradores e mais como colaboradores.
Há um ângulo de privacidade e controle que vale a pena notar. Quando um modelo consegue compor a partir de dez referências, o usuário mantém o controle das entradas. Em vez de descrever um produto e torcer para que o modelo o renderize com precisão, você fornece a foto real do produto. Em vez de descrever uma pessoa, você fornece a imagem real dela, dentro dos limites de consentimento aplicáveis. A edição com múltiplas referências é, em certo sentido, um passo em direção à geração ancorada, em que o modelo se ancora em assets reais em vez de alucinar a partir de uma descrição textual.
Ainda existem limites reais. A preservação de identidade entre várias pessoas em uma mesma imagem continua complicada, e quanto mais referências você fornece, maiores as chances de o modelo confundir atributos entre elas, o rosto errado no corpo errado, a cor errada no objeto errado. O teto de dez imagens é um passo, não um problema resolvido, e os modos de falha ficam mais estranhos conforme o número de entradas cresce. A equipe claramente fez o trabalho de engenharia para torná-lo rápido, mas o trabalho de qualidade está em andamento.
Os controles de edição local fazem parte do mesmo pacote. Você pode desenhar círculos, pintar anotações ou passar uma imagem de máscara separada para direcionar uma edição a uma região sem tocar no restante. Combinados com a entrada de múltiplas referências, isso começa a se parecer com uma ferramenta de composição de verdade, o tipo de coisa que costumava exigir camadas em um editor gráfico, agora expressável como um conjunto de referências e instruções para um único modelo.
Para quem desenvolve ferramentas criativas, a lição é direta. A próxima onda de diferenciação não é “imagens únicas melhores”. É “quantas coisas o modelo consegue manter e combinar de uma vez, e com que precisão você consegue dizer o que mudar”. Dez referências é a resposta atual. Não vai ficar em dez por muito tempo.
Há um enquadramento mais amplo que vale a pena colocar em torno disso. Durante anos, a promessa da geração de imagens com IA foi “descreva, receba”. Essa promessa funcionou para uso casual, mas nunca funcionou muito bem para profissionais, porque profissionais raramente partem de uma descrição em branco. Eles partem de assets, uma foto de produto, uma imagem de referência, um guia de marca, um rosto que precisa permanecer consistente. O movimento em direção à edição com múltiplas referências é, no fundo, uma concessão a essa realidade. O modelo está sendo ensinado a partir do que o usuário já tem, em vez de partir do que o usuário consegue descrever.
É por isso que a engenharia importa. Manter dez referências em contexto e mantê-las distintas não é apenas uma versão maior de manter uma. É um problema diferente, a diferença entre lembrar de um único rosto e lembrar de dez pessoas bem o suficiente para distingui-las em uma foto de grupo. O mascaramento em nível de chunk e o reuso de cache KV que a Qwen descreve são as técnicas específicas para resolver esse problema, e são o tipo de detalhe que determina se o recurso funciona na prática ou apenas em uma demo.
A implicação comercial é direta. Os fluxos de trabalho que a edição com múltiplas referências desbloqueia, composição de produtos, retratos em grupo, lookbooks, geração de assets de marca, são todos coisas pelas quais as pessoas atualmente pagam, seja em ferramentas ou em mão de obra. Se um modelo consegue fazê-los bem o suficiente, o valor se desloca do trabalho humano de composição para a capacidade do modelo de manter e combinar. Essa é uma mudança econômica real, e é por isso que esse recurso, mais do que os que são amigáveis a benchmarks, é o que deve ser observado para saber para onde o setor realmente está indo.
Há também um ângulo criativo fácil de passar despercebido. A edição com múltiplas referências muda o que conta como “prompting”. Um usuário que fornece dez referências não está escrevendo uma descrição, está curando um conjunto, fazendo escolhas sobre o que incluir e o que deixar de fora. Isso está mais próximo de direção de arte do que de engenharia de prompt, e aponta para um futuro em que o ato criativo no trabalho de imagens com IA é tanto sobre seleção e combinação quanto sobre linguagem. O teto de dez referências é, nesse sentido, o primeiro passo real em direção a modelos de imagem que tratam o usuário como diretor, e não como solicitante.
Artigos relacionados
A transparência nativa é, discretamente, o recurso mais útil das novas imagens de IA
Todo mundo pede realismo. Designers pedem fundo transparente. Por que a geração nativa de canal alfa é o recurso discreto que muda fluxos de trabalho de verdade.
O Qwen-Image 2.1 da Alibaba acaba de mudar a conversa sobre licenciamento de modelos abertos
As especificações técnicas são impressionantes, mas a licença é a verdadeira história. O Qwen-Image 2.1 abandona a Apache 2.0 por uma licença de pesquisa, e as letras miúdas agora importam mais do que nunca.
Tongyi Wanxiang Qwen-Image 2.1 em código aberto: como um pequeno modelo de 7B coloca imagens transparentes e edição com 10 imagens em uma GPU de consumidor
Um modelo aberto de geração de imagens com 7B: por que ele consegue colocar imagens transparentes e edição com várias imagens em uma GPU de 6 GB? Uma análise das principais atualizações e da mudança de licença do Qwen-Image 2.1.
Você ainda consegue distinguir uma imagem de IA de uma real? A resposta honesta é não.
Os sinais reveladores sumiram e os detectores são pouco confiáveis. A resposta honesta para identificar imagens de IA é não, e a solução está a montante dos seus olhos.