
2,8 trilhões de parâmetros em uma GPU de 4 GB: como o AirLLM quebrou o muro da VRAM
O muro em que todo mundo esbarra
Existe um momento específico que todo desenvolvedor que quer rodar um modelo grande localmente encontra. Não é um problema de habilidade nem de custo. É um número numa ficha técnica: a memória de vídeo. Um modelo aberto sério não cabe na placa de vídeo que a maioria das pessoas tem, e a solução habitual, comprar uma placa maior, chegou a um preço que virou absurdo.
Então o campo se encheu de contornos. Quantizar os pesos até quatro bits. Descarregar parte do modelo para a RAM do sistema. Alugar o hardware de outra pessoa. Cada um funciona, cada um custa algo, e cada um muda o modelo de um jeito com o qual é preciso conviver. Depois existe o AirLLM, um repositório que neste mês está perto do topo das tendências do GitHub, cujo README faz uma afirmação que soa como erro de digitação: 2,8 trilhões de parâmetros, uma única GPU de 4 GB.
Em que consiste de fato o truque
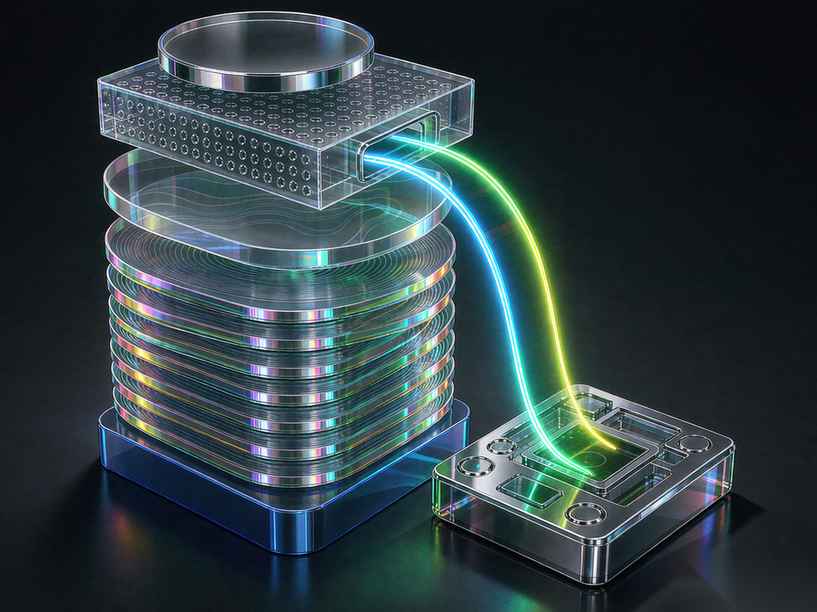
A ideia por trás do AirLLM não é deixar o modelo menor. É parar de tentar mantê-lo inteiro na memória de uma vez. Em vez de carregar cada camada da rede na placa de vídeo antes de gerar um token, a abordagem faz o modelo fluir camada por camada, buscando cada bloco do disco logo antes de precisar dele, usando-o e depois liberando-o.
A qualquer instante, só uma fatia fina do modelo precisa residir na memória rápida. O resto pode ficar num disco. A placa de vídeo deixa de ser um armazém e passa a ser uma bancada de trabalho, e o tamanho do modelo deixa de impor um teto rígido à máquina capaz de rodá-lo.
É a mesma razão pela qual uma pessoa consegue ler um livro de mil páginas numa escrivaninha muito pequena. Você não precisa do livro inteiro à sua frente. Precisa da página em que está, mais de um jeito de buscar a próxima.
O trade-off honesto
Se fazer as camadas fluírem por uma GPU pequena fosse de graça, todo mundo já faria isso, então vale a pena deixar claro quanto custa. Ler os pesos do disco a cada token é lento de um jeito fácil de subestimar. A placa de vídeo fica ociosa enquanto espera dados que poderia ter usado imediatamente se estivessem residentes.
A consequência prática é que essas configurações servem para um conjunto de tarefas diferente do de um modelo carregado inteiramente na memória. Se você precisa de um fluxo constante de respostas rápidas para um produto de chat, o streaming é a ferramenta errada. Se você quer rodar um modelo muito grande de vez em quando, em hardware que já possui, numa tarefa em que a vazão importa menos do que o simples fato de conseguir fazê-la, o trade-off pende a seu favor.
Ajuda colocar isso ao lado do contorno mais familiar. A quantização encolhe o próprio modelo, trocando um pouco de precisão por um menor consumo de espaço, e muda o que o modelo é. O streaming deixa os números do modelo intactos e muda onde eles vivem. Os dois não são rivais, eles se somam. Um modelo quantizado que também é transmitido camada por camada é menor e mais leve do que qualquer uma das técnicas isoladas, e é por isso que as duas abordagens tendem a aparecer juntas na prática.
Há um terceiro custo, menos divulgado: o disco. Transmitir os pesos significa lê-los do armazenamento a cada passagem, então um disco lento se torna o novo gargalo no instante em que o modelo deixa de caber na memória. Quem segue esse caminho aprende rápido que o hardware que importa não é só a GPU. Um SSD rápido pode fazer mais pela vazão aqui do que alguns gigabytes extras de memória de vídeo.
Essa distinção, entre interatividade e viabilidade, é a que a maioria das comparações deixa passar. Um modelo que roda a passo de tartaruga na sua mesa continua sendo um modelo que você consegue rodar na sua mesa. Para um pesquisador sem cluster, ou um desenvolvedor que quer testar um prompt específico contra um modelo enorme específico, isso pode bastar.
Por que continua nas tendências
O AirLLM não é novo. Existe há tempo suficiente para ser familiar a quem acompanha a inferência local de perto. Ele reaparece nas listas de tendências por um motivo que tem menos a ver com a implementação específica do que com a pressão por trás dela.
Modelos de pesos abertos não param de crescer. Os melhores modelos abertos de imagem, vídeo e linguagem agora estão firmemente numa faixa que nenhuma placa de vídeo de consumo consegue conter com folga. Ao mesmo tempo, o preço das placas com muita memória capazes de contê-los subiu, não caiu, impulsionado pela mesma demanda que está remodelando o resto do mercado de hardware. A lacuna entre o que dá para rodar e o que dá para rodar em hardware acessível não para de aumentar.
Qualquer projeto que faça frente a essa lacuna, mesmo de forma imperfeita, vai continuar encontrando público. A alternativa é um mundo em que a fronteira dos modelos abertos está teoricamente disponível para todos e praticamente só para quem tem um data center. Os contornos são o jeito de o aberto dos pesos abertos continuar honesto.
O que isso não resolve
Duas coisas diferentes se misturam aqui. Rodar um modelo grande numa GPU pequena é um problema de memória. Obter uma saída útil de um modelo grande é uma questão de capacidade, e as duas não são a mesma coisa. Um modelo de 2,8 trilhões de parâmetros transmitido por uma placa de 4 GB continua gerando texto num ritmo definido pelo seu disco e pela sua largura de banda, e a qualidade desse texto é a do modelo, não o que o contorno tornou possível.
Há também uma dimensão de licenciamento que a conquista técnica não toca. Poder rodar um modelo localmente não diz nada sobre se você tem permissão de usar seus pesos para o seu propósito. A configuração de inferência local mais impressionante do mundo continua presa aos termos ligados ao modelo que ela executa.
O ponto mais amplo
A fronteira da IA local não é um único avanço. É uma longa sequência de decisões de engenharia nada glamourosas sobre onde os dados vivem, quando se movem e pelo que você está disposto a esperar. O AirLLM é um bom exemplo porque é muito franco sobre a troca: você abre mão da velocidade e, em troca, consegue rodar algo que não deveria caber.
Para um número crescente de pessoas que se importam mais com o que um modelo pode fazer do que com a rapidez com que faz, é um acordo razoável. E para todo o resto, é um lembrete de que este modelo precisa de X gigabytes é uma decisão de projeto tanto quanto um limite de hardware. Alguém, em algum lugar, está sempre procurando a escrivaninha menor que o livro.
Artigos relacionados
O agente independente de harness: executar qualquer modelo de fronteira na sua própria máquina
O modelo é a inteligência, o harness é o encanamento, e os dois não precisam viver no mesmo pacote. Um conjunto de projetos de código aberto desfaz esse vínculo para executar qualquer modelo de fronteira na interface que você preferir, com acesso local por padrão.
Um bit basta: por que o BitNet da Microsoft continua conquistando
Um peso de um bit não é um truque. Como o esquema ternário do BitNet da Microsoft troca a multiplicação pela soma, faz grandes modelos rodarem numa CPU comum e a que preço.
O novo manual de regras do vídeo com IA: as etiquetas legíveis por máquina ao abrigo do EU AI Act
O artigo 50 do EU AI Act faz dos metadados de proveniência uma questão de conformidade. A etiqueta é incorporada na geração e a pipeline perde-a com facilidade.
O seu agente de IA esquece tudo: os truques de MCP que resolvem o inchaço do contexto
Um agente não fica mais inteligente por rodar muito tempo, fica mais burro porque o seu context window se enche de lixo. Do sandboxing de saídas de ferramentas à memória persistente e ao routing, esses projetos consertam a memória do agente.