
LTX 2.5, 투박한 블렌더 초안을 완성된 샷으로 렌더링하려 한다
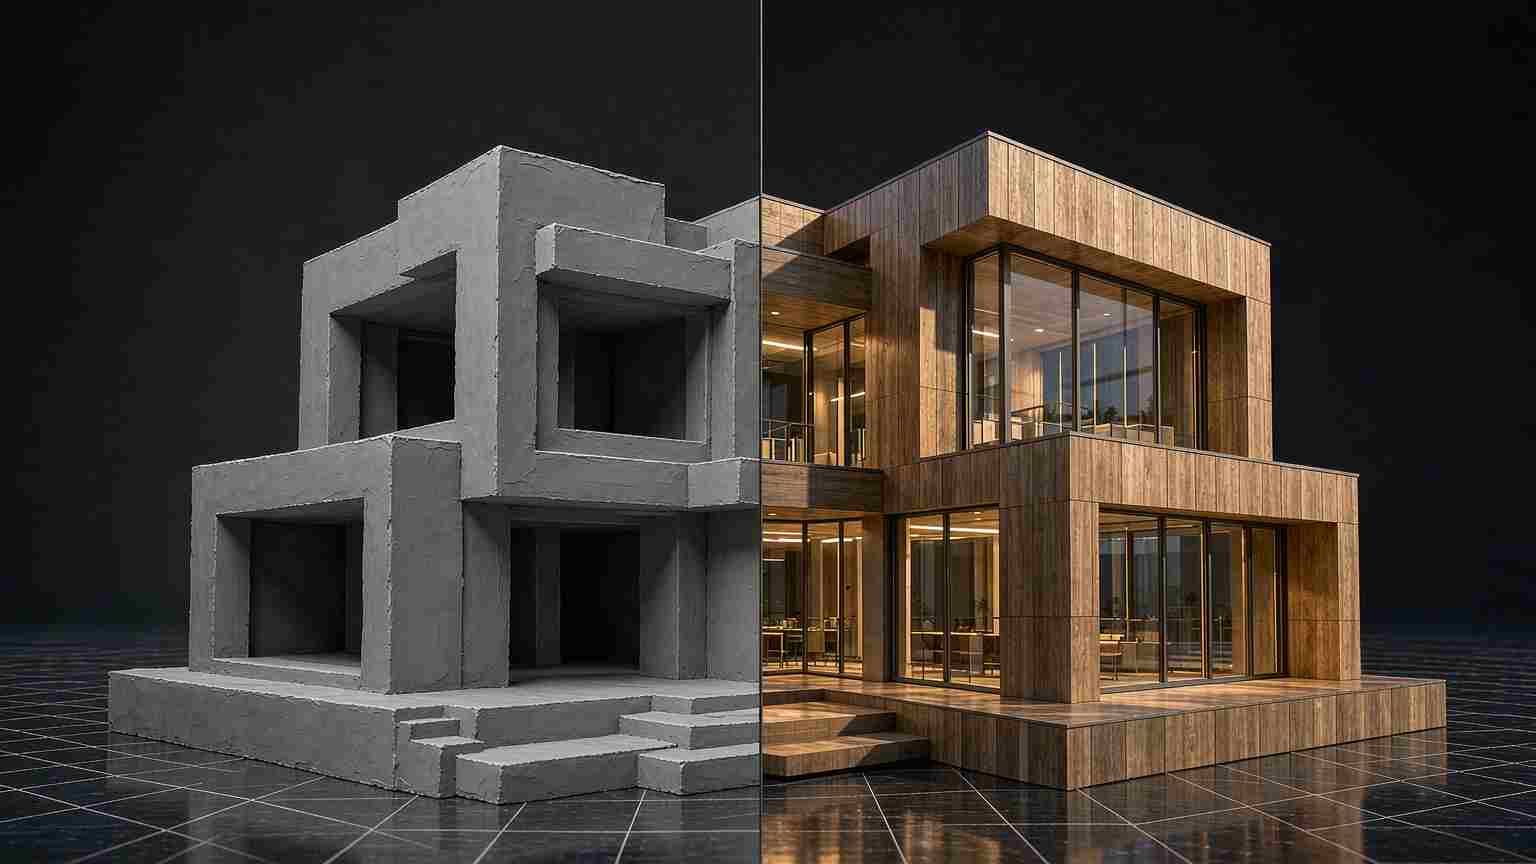
Lightricks가 LTX 2.5 비디오 모델용 새 어댑터를 공개했습니다. 이 어댑터는 아주 구체적이면서도 아주 익숙한 문제, 즉 거친 3D 애니메이션과 실제로 누군가에게 보여줄 만한 결과물 사이의 간극을 겨냥합니다.
이 도구의 이름은 Layout-to-Render로, LTX 2.5 파운데이션 모델에서 구동되는 IC-LoRA 형태로 제공됩니다. 클레이 뷰포트 애니메이션이나 저품질 플레이블래스트, 즉 블렌더나 언리얼에서 나오는 그 투박한 회색 미리보기를 입력하면, 동일한 샷을 조명과 텍스처가 완성된 비디오로 렌더링해 줍니다. 카메라 움직임과 프레이밍, 오브젝트 배치를 그대로 유지하며, 아트 디렉션은 참조 이미지에서 가져옵니다.
이 도구가 다른 종류인 이유
시장에 나온 거의 모든 비디오 생성기는 같은 방식으로 작동합니다. 원하는 것을 설명하면 모델이 카메라 위치, 피사체의 행동, 장면의 모습까지 모든 것을 결정합니다. 일회성 클립에는 괜찮습니다. 하지만 프레이밍을 의도적으로 결정하는 것이 핵심인 제작 환경에는 잘 맞지 않습니다.
Layout-to-Render는 이 역할 분담을 뒤집습니다. 이미 3D에서 블로킹을 해두었기 때문에 레이아웃이 움직임과 구도를 통제합니다. 생성 모델은 오직 룩만 담당합니다. 이러한 분리가 샷 반복 작업을 예측 가능하게 만듭니다. 룩을 바꿔도 카메라 안무가 흐트러지지 않고, 카메라를 조정한다고 해서 클립 전체를 다시 뽑으며 운에 맡길 필요도 없습니다.
텍스트-투-비디오 클립을 생성하며 카메라가 몇 도 어긋난 것들을 버리느라 오후를 다 보낸 사람이라면, 이것이 진짜 불만을 해결해 줍니다. 텍스트-투-비디오의 실패 지점은 이미지가 못생겼다는 게 아닙니다. 무슨 일이 일어날지 내가 통제할 수 없다는 것입니다. 느린 푸시인(push-in)을 원하는 감독은 모델이 동의할 때까지 다시 뽑고 싶지 않습니다. 푸시인을 지정하고 다음으로 넘어가고 싶어 합니다.
이것이 끼워지는 파이프라인
이 어댑터는 기존 3D 워크플로를 대체하는 것이 아니라 거기에 맞춰지도록 설계되었습니다. 블렌더와 언리얼 등 유사한 도구를 지원하며, 로컬 ComfyUI와 파이썬 파이프라인을 통해 구동됩니다. 애니메이터가 늘 하던 방식대로 샷을 블로킹하고 저렴한 미리보기를 렌더링한 뒤, 생성 컴퓨팅을 추측이 아니라 최종 룩에 쓴다는 발상입니다.
이는 이런 모델의 존재 목적이 달라졌다는 의미 있는 변화입니다. 비디오 생성의 1세대는 스펙터클, 즉 단독으로 봤을 때 인상적인 클립으로 경쟁했습니다. 이것이 그 징후라면, 2세대는 적합성으로 경쟁합니다. 모델이 전문가가 이미 쓰는 파이프라인에 얼마나 매끄럽게 들어가는지, 그리고 가치를 얻기 위해 전문가가 공정을 얼마나 조금 바꾸면 되는지입니다.
이것이 들리는 것보다 더 중요한 데에는 이유가 있습니다. 스튜디오는 공정을 재구축해야 하는 도구를 도입하지 않습니다. 이미 가진 공정에 그대로 꽂히는 도구를 도입합니다. 뷰포트 미리보기와 샷 블로킹의 언어를 구사하는 모델은 애니메이터가 있는 자리에서 그들을 만납니다. 장면을 문단으로 설명하라고 요구하는 모델과는 아주 다른 제안입니다.
솔직한 비용
이 약속을 누그러뜨리는 두 가지가 있습니다. 첫째는 하드웨어입니다. 220억 파라미터의 LTX 2.5 모델과 여기에 필요한 스택은 설정 비용과 VRAM 요구량을 모두 끌어올려, 일반 사용자에게는 손이 닿지 않는 영역이며 이미 3D 작업용 GPU 장비를 갖춘 사람 쪽으로 밀어 넣습니다.
둘째는 결과물이 생성적일 뿐 정확하지 않다는 점입니다. 모델은 픽셀 수준에서 지오메트리를 보존하지 않으므로, 아티스트는 여전히 연속성과 정렬, 프레임 간에 어긋난 부분이 없는지 결과를 검토해야 합니다. 원본 오디오는 전달되지 않으며, 파이프라인이 지원하는 포맷에 맞추기 위해 프레임 수가 줄어들 수 있습니다. 이것은 피니싱 도구이지 렌더러를 대체하는 것이 아니며, 그렇게 취급하면 실망으로 이어질 것입니다.
이 두 비용은 같은 실용적 진실을 가리킵니다. 이것은 이미 파이프라인을 가진 사람을 위한 소프트웨어이며, 그 가치는 불가능한 일을 할 수 있게 해준다는 데 있지 않고 절약된 시간으로 나타납니다. 이미 3D에서 샷을 블로킹하지 않는다면 이 도구가 줄 것이 거의 없습니다. 그렇다면 계산은 빠르게 달라집니다.
오픈 비디오 경쟁에서의 의미
LTX 2.5 자체는 오픈 웨이트이며, 지난 몇 달의 더 큰 흐름은 오픈 비디오 모델이 정말로 좋아지고 있다는 것이었습니다. 이 어댑터 같은 도구가 바로 그 개방성이 도입으로 이어지는 방식입니다. 워크플로가 없는 강력한 모델은 데모에 불과합니다. 레이아웃-투-렌더 경로와 ComfyUI 노드, 블렌더 통합을 갖춘 강력한 모델은 스튜디오가 실제로 쓸 수 있는 것입니다.
차별화가 어디로 향하는지에 대한 더 조용한 논점도 있습니다. 여러 모델이 텍스트 프롬프트로 아름다운 5초 클립을 만들 수 있게 되면, 경쟁은 통제로 옮겨갑니다. 어느 모델이 원하는 것을 정확히 지정하고, 시퀀스 전체에서 이를 유지하며, 나머지를 망가뜨리지 않고 한 가지만 바꿀 수 있게 해주는가. Layout-to-Render는 Lightricks가 3D 우선 워크플로로 이 질문에 답하는 것이며, 통제를 가장 중시하는 사람들이 바로 샷 단위로 사고하는 사람들이라는 데 걸고 있습니다.
대체하지 않는 것
경계를 분명히 할 필요가 있습니다. Layout-to-Render가 3D 작업의 필요성을 없애지는 않습니다. 샷을 블로킹하고, 카메라를 제대로 잡고, 장면을 구성하는 일은 여전히 누군가 해야 합니다. 이것이 없애는 것은 값비싼 최종 렌더 패스와, 특정 샷을 말로 설명하려는 시도의 추측입니다. 그런 분업은 스튜디오가 이미 프로젝트 인력을 꾸리는 방식과 잘 맞습니다. 소규모 팀이 레이아웃을 맡고, 렌더링 예산은 카메라 무브를 반복하는 데가 아니라 룩 개발에 쓰입니다. 이 도구는 노력이 어디에 떨어지는지를 바꿀 뿐, 프로젝트에 필요한 상상력의 양을 바꾸지는 않습니다.
더 큰 그림
여기서의 궤적은 이름 붙일 가치가 있습니다. 비디오 생성은 존재하지 않던 클립을 만드는 방법으로 시작했습니다. 지금은 이미 계획한 클립을 더 적은 비용으로 완성하는 방법이 되어가고 있습니다. 이 둘은 서로 다른 제품이고, 서로 다른 구매자를 겨냥하며, 서로 다른 종류의 품질을 보상합니다.
첫 번째 종류는 사실감과 놀라움을 보상합니다. 두 번째는 계획에 대한 충실성과 여러 샷에 걸친 예측 가능성을 보상합니다. LTX 2.5의 어댑터는 분명히 두 번째를 겨냥하고 있으며, 전문 비디오 제작의 돈이 그곳에 있다는 것은 합리적인 추측입니다. 스튜디오는 샷을 만들어낼 수 있는 모델이 필요하지 않습니다. 이미 그려둔 샷을, 계속해서, 어긋남 없이 렌더링할 수 있는 모델이 필요합니다.
Layout-to-Render가 그것을 프로덕션 품질로 구현하는지는 아티스트들이 써보면서 결정할 문제입니다. 하지만 그 방향성은 이 소프트웨어에 돈을 내는 사람들에게 옳은 것이며, 그것만으로도 새로운 이름을 붙인 또 하나의 클립 생성기 이상입니다.