
4GB の GPU で 2.8 兆パラメータ:AirLLM はどう VRAM の壁を破ったか
誰もがぶつかる壁
大規模モデルをローカルで動かしたい開発者が必ず迎える瞬間がある。それはスキルの問題でもコストの問題でもない。スペック表に書かれた一つの数字、VRAM だ。まともなオープンモデルは、多くの人が持っている GPU には収まらない。そして定番の解決策である、より大きなカードを買うという手段は、馬鹿げた水準まで値上がりしている。
そこでこの分野は回避策であふれた。重みを 4 ビットまで量子化する。モデルの一部をシステム RAM に退避させる。他人のハードウェアを借りる。どれも機能し、どれも何かの代償を払い、どれもあなたが受け入れざるを得ない形でモデルを変えてしまう。そこに AirLLM がある。今月 GitHub のトレンド上位に近い位置にあるリポジトリで、その README には誤植にしか見えない主張が書かれている。2.8 兆パラメータ、単一の 4GB GPU。
仕掛けの正体
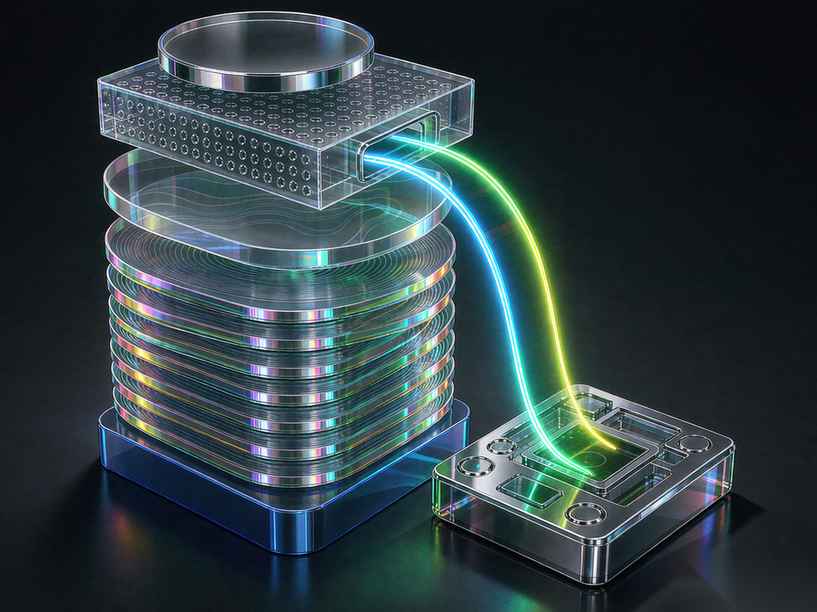
AirLLM の背後にある発想は、モデルを小さくすることではない。全体を一度にメモリに保持しようとするのをやめることだ。トークンを生成する前にネットワークのすべての層を GPU に読み込むのではなく、この手法はモデルを一層ずつ流れていく。各ブロックは必要になる直前にディスクから取り出し、使い、手放す。
どの瞬間でも、高速メモリに置く必要があるのはモデルのごく薄い一片だけだ。残りはドライブに置いておける。GPU は倉庫ではなく作業台になり、モデルの大きさは、どのマシンで動かせるかという厳しい上限を設けなくなる。
これは、人が千ページの本をとても小さな机で読めるのと同じ理屈だ。本全体を目の前に置く必要はない。必要なのは今開いているページと、次のページを手に入れる手段だけだ。
正直なトレードオフ
層を小さな GPU に流すのがただで済むなら、誰もがとっくにやっている。だからこそ、その代償をはっきりさせておく価値がある。トークンごとに重みをディスクから読むのは、見くびりやすいほど遅い。GPU は、常駐していればすぐ使えたはずのデータを待つ間、ただ遊んでいる。
実際の帰結として、こうした構成は、モデルを完全にメモリへ読み込む場合とは別の種類の作業に向いている。チャット製品のように高速な応答を絶えず返す必要があるなら、ストリーミングは間違った道具だ。非常に大きなモデルを、すでに持っているハードウェアで、スループットよりもそもそも動かせることが大事な作業として時々動かしたいなら、このトレードオフはあなたの側に傾く。
より身近な回避策と並べて見ると分かりやすい。量子化はモデルそのものを小さくし、わずかな精度と引き換えに占有を減らす。それはモデルが何であるかを変える。ストリーミングはモデルの数値をそのままにし、それが置かれる場所を変える。両者は敵ではなく、重ねられる。量子化され、さらに層ごとにストリーミングされるモデルは、どちらか一方だけの手法より小さく軽い。実務で両者が一緒に現れがちなのはそのためだ。
あまり宣伝されない第三の代償もある。ドライブだ。重みをストリーミングするということは、毎回ストレージから読み出すということで、モデルがメモリに収まらなくなった瞬間、遅いディスクが新たなボトルネックになる。この道に踏み込んだ人はすぐに、重要なハードウェアは GPU だけではないと学ぶ。ここでは高速な SSD のほうが、VRAM を数 GB 増やすよりもスループットに効く。
インタラクティブ性と実行可能性のこの区別こそ、多くの比較が見落とす点だ。机の上で亀のように遅く動くモデルでも、机の上で動かせるモデルではある。クラスタを持たない研究者や、特定のプロンプトを特定の巨大モデルで試したい開発者にとっては、それで十分なことがある。
なぜトレンドに上がり続けるのか
AirLLM は新しくない。ローカル推論を注意深く追う人にはなじみがあるくらいには、長く存在している。それでもトレンドリストに何度も現れるのは、具体的な実装よりも、その背後にある圧力によるところが大きい。
オープンウェイトのモデルは大きくなり続けている。現在の最高のオープンな画像・動画・言語モデルは、どのコンシューマ向け GPU でも快適には収まらない領域に、しっかり足を踏み入れている。同時に、それらを収められる大容量メモリのカードの価格は、下がるどころか上がっている。ハードウェア市場の残りを形づくっているのと同じ需要が、それを押し上げている。動かせるものと、手頃なハードウェアで動かせるものとの差は、広がり続けている。
その差に、たとえ不完全でも押し返そうとするプロジェクトは、必ず受け手を見つけ続ける。もう一つの可能性は、オープンモデルの最前線が理論上は誰にでも開かれ、実際にはデータセンターを持つ者だけが使える世界だ。回避策こそが、オープンウェイトのオープンを正直に保つ方法なのだ。
それでも解決しないこと
ここで二つの別物が混同されやすい。小さな GPU で大規模モデルを動かすのはメモリの問題だ。大規模モデルから役立つ出力を引き出すのは能力の問題で、両者は同じではない。2.8 兆パラメータのモデルを 4GB カードにストリーミングしても、テキストを生成する速度はディスクと帯域で決まり、そのテキストの品質はモデルそのもの次第であって、回避策が可能にしたものではない。
技術的な成果が触れないライセンスの側面もある。モデルをローカルで動かせることは、その重みをあなたの目的に使ってよいかどうかとは何の関係もない。世界で最も見事なローカル推論構成も、それが動かしているモデルに付いた条件には縛られている。
より大きな論点
ローカル AI の最前線は、一つの突破口ではない。データをどこに置き、いつ動かし、何を待つ用意があるかという、地味なエンジニアリング上の判断の長い積み重ねだ。AirLLM は好例だ。この取引についてあまりに率直だから。速度をあきらめ、その代わりに、収まるはずのなかったものを動かせる。
モデルが何をするかを、どれだけ速くやるかより重く見る人が増える中で、それは妥当な取引だ。そして他のすべての人には、こう気づかせる。このモデルには何ギガバイト必要だというのは、ハードウェアの限界であると同時に設計上の判断でもあるのだと。どこかで誰かがいつも、本より小さな机を探している。
関連記事
1ビットで十分:Microsoft の BitNet が支持され続ける理由
1ビットの重みは目新しい芸ではない。Microsoft の BitNet の三値方式が乗算を加算に置き換え、大規模モデルを普通の CPU で動かす仕組みと、その本当の代償を読み解く。
AI動画の新しいルールブック:EU AI法が求める機械可読ラベル
EU AI法第50条はAI動画の来歴メタデータをコンプライアンス問題に変えた。ラベルは生成時に組み込まれ、パイプラインで失われやすい。
あなたの AI エージェントは何も覚えていない:コンテキスト肥大化を直す MCP の工夫
エージェントは長く走るほど賢くなるのではなく、コンテキストウィンドウがゴミで埋まって鈍くなる。ツール出力の sandboxing から永続メモリ、routing まで、これらのプロジェクトがエージェントの記憶を直している。
Google が全 Veo エンドポイントを廃止へ:10 月 22 日の動画大刷新の内幕
Google は 2026 年 10 月 22 日に Gemini API 上の全 Veo エンドポイント(veo-3.1-lite-generate-preview を含む)を停止し、トークン課金の gemini-omni-1.1-flash に置き換える。