
Un LoRA sur Qwen-Image 2.1 transforme une photo en panorama 360°
Le 30 octobre, un modèle au nom à rallonge est apparu sur Hugging Face : qwen-image-2.1-360-panorama-outpaint-lora. L'auteur, nomadoor, a fait simple : ajouter un LoRA à Qwen-Image 2.1 pour qu'il étende une photo ordinaire dans toutes les directions, jusqu'à en faire un panorama 360° complet.
Le cas d'usage est très concret. Vous avez photographié le salon d'une location de vacances et vous voulez le montrer dans un casque VR, où l'on tourne la tête ; ou vous fabriquez un skybox de jeu, une texture d'éclairage d'environnement pour une scène 3D. Dans les deux cas il faut une image sphérique en 2:1, dont les bords gauche et droit se raccordent. La photo, vous l'avez. Ce qui manque, ce sont les 300° autour.
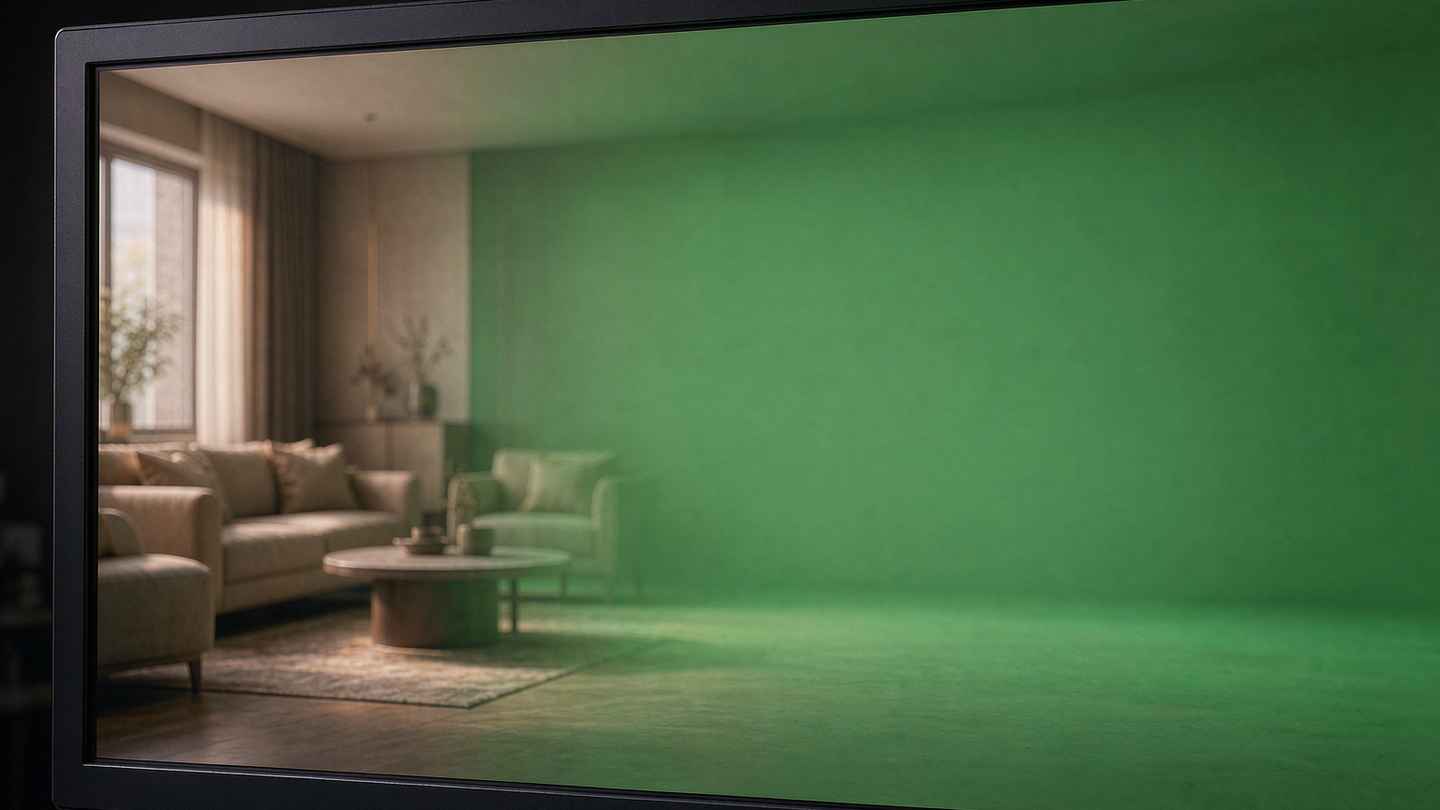
La méthode habituelle consistait à outpaintre une image, puis à recoller les coutures à la main. L'auteur a figé le protocole : canevas en 2:1, photo posée dessus, zones vides remplies de vert pur, prompt commençant par une phrase de déclenchement fixe. Le vert n'est pas décoratif. C'est un marqueur de frontière pour le modèle : il indique quelle portion est vide et quelle portion a déjà été photographiée.
Ce qu'il fait réellement
Beaucoup imaginent qu'un modèle qui « complète un panorama » invente une pièce entière. Ce LoRA ne fait pas ça. Il part de la photo placée au centre, étend vers la gauche, la droite, le haut et le bas, et referme l'image en anneau sur la sphère. Les réglages donnés par l'auteur : strength 0.8, 25 étapes, sortie en 2048×1024.
Le 2048×1024 mérite qu'on s'y arrête. C'est exactement du 2:1, et c'est aussi le format que digèrent la plupart des lecteurs de panorama, des skybox de moteurs de jeu et des textures d'environnement des logiciels 3D. Monter en résolution n'améliore pas la sensation d'espace, cela rend seulement les coutures plus difficiles à aligner. Ce choix dit quelque chose : l'auteur ne fabrique pas une image de démonstration, il fabrique un élément qui entre dans une chaîne de production.
Le plus dur n'est pas de dessiner, c'est d'aligner les deux bords
D'après les notes de test de l'auteur, l'essentiel du travail sur ce LoRA est allé à une seule chose : faire en sorte qu'on ne voie pas la couture quand le bord gauche rejoint le bord droit. Le principe est simple. Une fois le panorama déplié à plat, le bord extrême gauche et le bord extrême droit sont, en coordonnées monde, le même méridien. Or le modèle les traite comme deux images indépendantes et dessine chacune de son côté : un arbre apparaît en trop dans le ciel, une rambarde manque au sol, et le raccord se décale.
C'est aussi pourquoi le duo « vert pur + phrase de déclenchement fixe » est une obligation, pas une recommandation. Une zone mal remplie sur le canevas, et le modèle la prend pour du contenu réel à prolonger : la sémantique des bords ne correspond plus. Une phrase de déclenchement oubliée dans le prompt, et il ne sait peut-être pas qu'il complète un panorama — il travaille comme sur un simple agrandissement d'image.
Autrement dit, le plafond de ce LoRA ne dépend pas uniquement des poids. Il dépend beaucoup de la propreté du canevas que vous lui tendez.
La licence mérite une pause
Le dépôt est publié sous Qwen Research License. Ni Apache 2.0, ni MIT. C'est la catégorie « utilisable, mais lisez les clauses d'abord », en particulier si vous comptez mettre les panoramas générés dans un projet client, dans un pack de jeu commercialisé, ou les vendre comme assets. L'auteur le rappelle dans sa documentation.
L'écosystème open source a une mauvaise habitude : dès que les poids se téléchargent, on suppose que l'usage commercial est permis. L'écart entre licence de recherche et licence commerciale ne se voit généralement que le jour où le juridique pose la question. Les panoramas sont un terrain particulièrement glissant : on les retrouve dans des bureaux de vente immobilière, des guides touristiques, des visites VR, des cartes de jeu. Que des contextes commerciaux.
Pourquoi le panorama, et pourquoi maintenant
En prenant du recul, ce LoRA tombe à un endroit intéressant. Ces deux dernières années, les progrès des modèles d'image se sont concentrés sur « une image seule qui soit belle », et la cohérence spatiale est restée le point faible : on génère une très belle pièce, mais si la caméra tourne de 90°, les meubles ont changé de place. Le remplissage de panorama ramène le problème à une échelle qu'un LoRA peut traiter — sans demander au modèle de comprendre la 3D, seulement de rester cohérent sur une frontière fermée.
Cela explique aussi la multiplication de ces petits LoRA dans la communauté depuis six mois. Les modèles de base ont atteint le niveau suffisant en qualité d'image et en sémantique ; le travail restant consiste à leur enseigner une relation géométrique précise. Quelques dizaines de Mo de poids, un format de canevas fixe, une phrase de déclenchement, et toute une catégorie de besoins est couverte.
Le prix à payer, c'est la fragilité. Une mise à jour du modèle de base et il faut réentraîner ; un changement de format de canevas et les bords ne s'alignent plus ; un ton de prompt différent et le résultat part en vrille. C'est moins une boîte à outils qu'une clé plate dédiée.
Conseils pratiques
Si vous voulez essayer, n'inversez pas l'ordre. Commencez par ouvrir le canevas en 2:1 et placez la photo légèrement sous le centre : la ligne de fuite de la plupart des photos d'intérieur est à cette hauteur, et c'est le long de cette ligne que le modèle étend vers les côtés, là où la couture se voit le moins. Remplissez les zones vides de vert pur, sans semi-transparence ni dégradé.
Mettez la phrase de déclenchement en tête du prompt, la description de scène ensuite. Le plus utile dans la description, c'est la direction de la lumière : l'éclairage doit être continu entre le bord gauche et le bord droit, donc si vous précisez que la lumière vient de l'avant-gauche du cadre, le modèle saura que la droite doit s'assombrir. Partez de strength 0.8 et de 25 étapes pour un premier passage, et regardez la couture avant d'ajouter des étapes.
Enfin, ne réglez pas la couture en relançant le modèle dix fois. Dix tirages ne valent pas un recadrage de 128 pixels de chaque côté, avec un fondu en miroir dans un logiciel d'image. Le modèle produit le contenu, l'outil déterministe s'occupe du raccord : cette répartition est bien plus fiable que d'espérer une illumination du modèle.
Sur le panorama, la situation restera sans doute la même à court terme : le modèle de base gère la qualité d'image, le petit LoRA gère la géométrie, et l'humain, au milieu, lisse la frontière. Ce n'est pas très élégant, mais ça produit des images.
Articles associés
Une feuille de calcul communautaire de clics pour couper les publicités des Android chinois
Il ne touche pas au système, ne déverrouille rien, ne flashe rien. Il bascule un à un les interrupteurs que les fabricants ont déjà prévus. Le prix à payer, c'est la liste qu'il faut continuer d'écrire.
GPT Image 2.6 a tenu le prix des tokens et fait monter la facture
GPT Image 2.6 reprend chaque tarif au token de 2.5 et coûte malgré tout plus cher par image, parce qu'une part plus grande du travail se paie en tokens de sortie. Onze jours après le lancement, la grille tarifaire dit plus que le classement.
Quelqu'un a reconstruit IDM de l'extérieur et a écrit ce qu'il n'a pas touché
Une réimplémentation en Rust d'Internet Download Manager revendique 5 fois la vitesse et 86 langues. Le document le plus intéressant est le paragraphe qui explique comment elle a été construite sans rien copier.
Rune est un framework UI Rust conçu pour qu'un agent puisse vérifier son propre travail
Rune rend en headless, vide son arbre d'éléments et accepte des entrées scriptées, ce qui donne à un agent de codage un signal différable qu'aucune capture d'écran ne fournit. Le framework est en préversion et n'accepte pas de pull requests.