
Ein LoRA auf Qwen-Image 2.1 macht aus einem Foto ein 360-Grad-Panorama
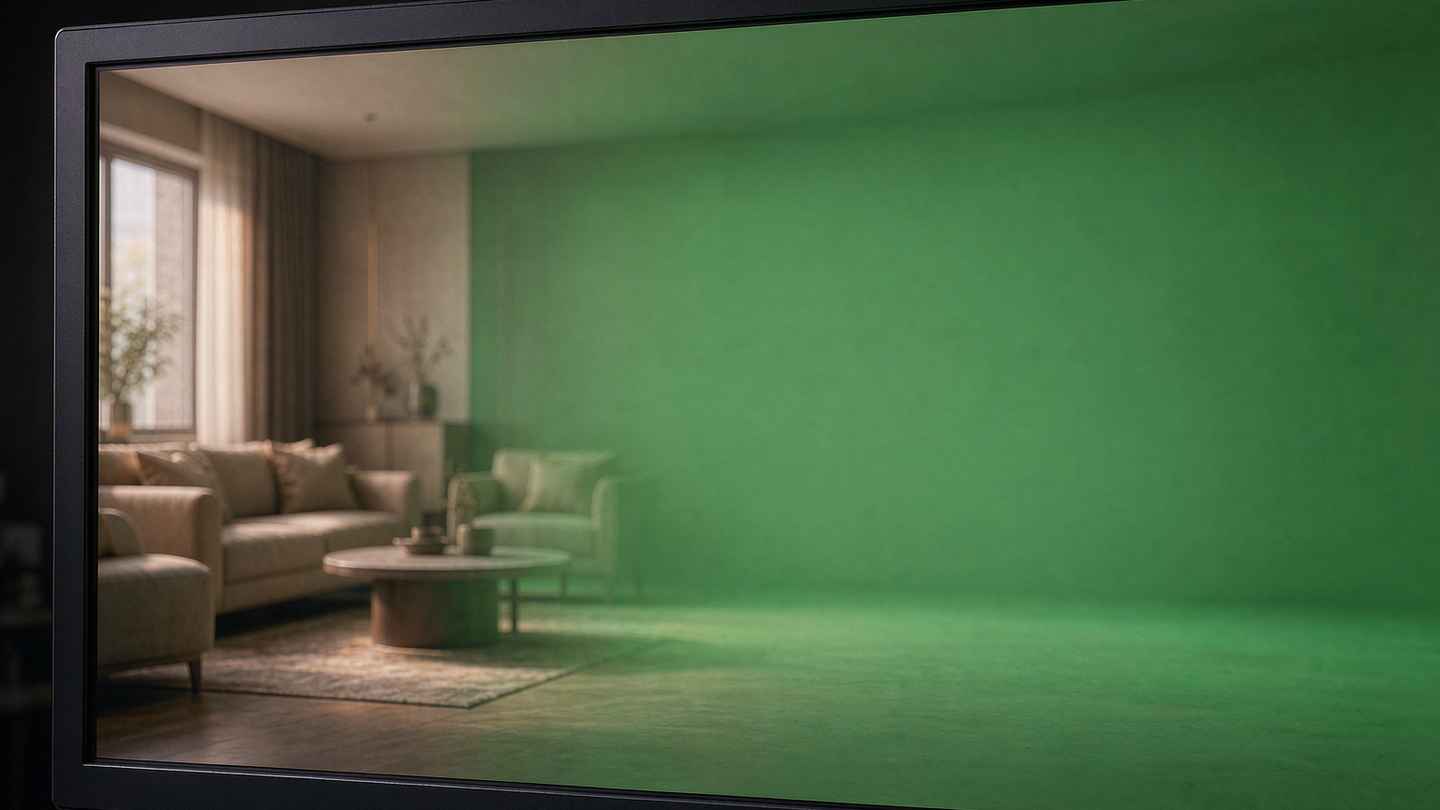
Am 30. Oktober tauchte auf Hugging Face ein Modellname auf, der einen Zeilenumbruch nötig macht: qwen-image-2.1-360-panorama-outpaint-lora. Autor ist nomadoor, und der Ansatz ist denkbar einfach: ein LoRA auf Qwen-Image 2.1, das ein gewöhnliches Foto nach allen Seiten erweitert, bis daraus ein vollständiges 360-Grad-Panorama wird.
Der Anwendungsfall ist sehr konkret. Sie haben das Wohnzimmer einer Ferienwohnung fotografiert und wollen es in einem VR-Headset zeigen, in dem man den Kopf drehen kann; oder Sie bauen eine Skybox für ein Spiel, eine Umgebungslicht-Textur für eine 3D-Szene. Beides braucht ein Kugelbild im Verhältnis 2:1, dessen linke und rechte Kante zusammenpassen. Das Foto ist da – es fehlen die 300 Grad dahinter.
Bisher hieß das: ein Bild outpainten und die Naht anschließend von Hand kaschieren. Hier ist der Ablauf festgeschrieben. Die Leinwand wird im Verhältnis 2:1 angelegt, das Foto darauf platziert, alle leeren Flächen mit reinem Grün gefüllt, und der Prompt beginnt mit einem festen Trigger-Satz. Das Grün ist keine Dekoration, sondern eine Grenzmarkierung für das Modell: Hier ist freie Fläche, dort steht bereits Aufgenommenes.
Was dabei tatsächlich passiert
Viele stellen sich unter „Panorama ergänzen“ vor, das Modell erfinde einen ganzen Raum. Dieses LoRA tut das nicht. Es nimmt das eingesetzte Foto als Zentrum und dehnt das Bild nach beiden Seiten sowie nach oben und unten, bis es sich auf der Kugel zu einem Ring schließt. Der Autor nennt strength 0.8, 25 Schritte und eine Ausgabe von 2048×1024.
Die Größe 2048×1024 verdient einen eigenen Satz. Sie ist exakt 2:1 und passt genau in das Raster, das die meisten Panorama-Player, Spiel-Engine-Skyboxen und Umgebungs-Texturen von 3D-Software verarbeiten. Höhere Auflösungen verbessern das Raumgefühl nicht, sie machen nur die Naht schwerer auszurichten. Die Wahl zeigt, dass der Autor keine Demo-Bilder baut, sondern etwas für die Pipeline.
Das Schwerste ist nicht das Zeichnen, sondern die Kante
Laut den Testnotizen des Autors ging der größte Aufwand in eine Sache: dass linke und rechte Kante beim Zusammensetzen keine Naht erkennen lassen. Das leuchtet ein. Eine entfaltete Panoramaaufnahme ist am linken und rechten Rand in Weltkoordinaten derselbe Meridian. Das Modell behandelt beide beim Generieren als getrennte Bildflächen und zeichnet sie einzeln – oben steht plötzlich ein Baum zu viel, unten fehlt ein Stück Geländer, und beim Zusammensetzen passt nichts.
Deshalb ist „reines Grün plus fester Trigger-Satz“ eine harte Vorgabe und keine Empfehlung. Bleibt auf der Leinwand eine unsauber gefüllte Fläche stehen, liest das Modell sie als echten Bildinhalt und setzt ihn fort; die Semantik an der Kante passt dann nicht mehr. Fehlt der Trigger-Satz im Prompt, weiß das Modell womöglich gar nicht, dass es ein Panorama ergänzt, und arbeitet wie bei einer normalen Bildererweiterung.
Anders gesagt: Die Obergrenze dieses LoRA hängt nicht allein an den Gewichten. Ein großer Teil liegt daran, wie sauber die Leinwand ist, die Sie ihm geben.
Ein Blick auf die Lizenz lohnt sich
Das Repository trägt die Qwen Research License. Das ist weder Apache 2.0 noch MIT. Sie gehört zu der Sorte „nutzbar, aber erst die Bedingungen lesen“ – besonders wenn die erzeugten Panoramen in Kundenprojekte, in ein Spiele-Release oder in einen Asset-Shop wandern sollen. Der Autor weist in der Beschreibung selbst darauf hin.
In der Open-Source-Szene gibt es eine unschöne Gewohnheit: Wenn sich die Gewichte herunterladen lassen, gilt kommerzielle Nutzung als selbstverständlich. Der Unterschied zwischen Forschungs- und kommerzieller Lizenz zeigt sich meist erst an dem Tag, an dem die Rechtsabteilung fragt. Panoramen sind dafür besonders anfällig – sie tauchen in Verkaufsräumen, Museumsführern, VR-Besichtigungen und Spielkarten auf, also fast immer in kommerziellen Kontexten.
Warum Panorama, warum jetzt
Mit etwas Abstand betrachtet, sitzt dieses LoRA an einer interessanten Stelle. Die Fortschritte der Bildmodelle der letzten zwei Jahre galten vor allem dem einzelnen schönen Bild; räumliche Konsistenz blieb die Schwachstelle. Man bekommt einen schönen Raum, aber sobald die Kamera 90 Grad schwenkt, stehen die Möbel woanders. Das Panorama-Outpainting verkleinert das Problem auf einen Bereich, den ein LoRA lösen kann: Das Modell muss nicht in 3D denken, nur entlang einer geschlossenen Kante zusammenhängend zeichnen.
Das erklärt auch, warum solche kleinen LoRAs seit einem halben Jahr häufiger auftauchen. Die Basismodelle liefern Bildqualität und Semantik; übrig bleibt, ihnen eine bestimmte geometrische Beziehung beizubringen. Ein paar Dutzend Megabyte Gewichte, ein festes Leinwandformat und ein Trigger-Wort reichen für eine ganze Bedarfsklasse.
Der Preis dafür ist Zerbrechlichkeit. Steigt das Basismodell auf eine neue Version, muss das LoRA neu trainiert werden; ändert sich das Leinwandformat, passen die Kanten nicht mehr; klingt der Prompt anders, driftet das Ergebnis. Es ist eher ein Spezialschlüssel als ein Werkzeugsatz.
Für die Praxis
Wer es ausprobiert, sollte die Reihenfolge nicht vertauschen. Zuerst die Leinwand im Verhältnis 2:1 anlegen und das Originalbild leicht unterhalb der Mitte platzieren – dort liegt bei den meisten Innenaufnahmen der Fluchtpunkt, und entlang dieser Höhe dehnt das Modell nach beiden Seiten, wo die Naht am wenigsten auffällt. Die leeren Flächen mit reinem Grün füllen, nicht halbtransparent, kein Verlauf.
An den Anfang des Prompts kommt der Trigger-Satz, danach die Szenenbeschreibung. Am nützlichsten ist darin die Lichtrichtung, denn das Licht muss über die gesamte Breite des Panoramas zusammenpassen. Wenn Sie schreiben, das Licht komme von vorn links, weiß das Modell, dass die rechte Seite dunkler werden muss. Mit strength 0.8 und 25 Schritten erst einmal einen Lauf machen und die Naht prüfen, nicht sofort die Schrittzahl erhöhen.
Und die Naht nicht durch wiederholtes Würfeln im Modell lösen. Zehn Versuche bringen weniger als ein Zuschnitt von je 128 Pixeln an beiden Seiten und eine Spiegel-Blende in der Bildsoftware. Das Modell zeichnet den Inhalt, die Naht übernimmt ein deterministisches Werkzeug – diese Arbeitsteilung ist deutlich verlässlicher, als auf eine Eingebung des Modells zu hoffen.
Auf der Panorama-Linie wird es kurzfristig wohl so bleiben: Das Basismodell liefert die Bildqualität, ein kleines LoRA die Geometrie, und dazwischen sitzt ein Mensch, der die Kante glättet. Klingt nicht elegant, liefert aber brauchbare Bilder.
Verwandte Artikel
Eine community-gepflegte Tabelle von Taps, die Werbung in chinesischen Android-Builds abschaltet
Es fasst das System nicht an, entsperrt nichts, flasht nichts. Es legt nur die Schalter um, die die Hersteller ohnehin vorgesehen haben. Der Preis ist eine Liste, die jemand weiterführen muss.
GPT Image 2.6 hielt den Tokenpreis und erhöhte die Rechnung
GPT Image 2.6 übernimmt jeden Tokenpreis von 2.5 und kostet pro Bild dennoch mehr, weil ein größerer Teil der Arbeit in Ausgabe-Token landet. Elf Tage nach dem Start sagt die Preisstruktur mehr als jede Rangliste.
Jemand hat IDM von außen nachgebaut und aufgeschrieben, was er nicht angefasst hat
Eine Rust-Neuimplementierung von Internet Download Manager verspricht 5x Tempo und 86 Sprachen. Das interessantere Dokument ist der Absatz, der erklärt, wie sie ohne jede Kopie entstanden ist.
Rune ist ein Rust-UI-Framework, das gebaut wurde, damit ein Agent seine eigene Arbeit prüfen kann
Rune rendert headless, gibt seinen Elementbaum aus und nimmt geskriptete Eingaben an. Damit bekommt ein Coding-Agent ein Signal zum Diffen, das ein Screenshot nie liefert. Das Framework ist Pre-Release und nimmt keine Pull Requests an.