
L'économie des sous-agents : pourquoi les modèles bon marché sont la vraie histoire des agents
La sortie IA la plus lourde de conséquences du début octobre a été la moins chère. Le 7 octobre, Anthropic a lancé Claude Haiku 5.5 et a indiqué que son coût d'exploitation moyen était inférieur d'environ 75 % à celui du Haiku précédent. Pour les requêtes de moins de 100 000 tokens, le prix de l'API a chuté d'environ 90 %, à dix cents par million de tokens en entrée et cinquante cents par million en sortie. Anthropic a aussi divisé par deux le prix de lecture du cache sur Sonnet 5.5.
Les modèles bon marché sont faciles à balayer d'un revers de main. Ils ressemblent à un coup tarifaire, pas à une avancée de capacités. Mais le détail intéressant de cette sortie n'est pas le prix. C'est à quoi sert Haiku 5.5.
Le petit modèle a grandi
Le vieux reproche adressé aux petits modèles était qu'ils convenaient aux tâches simples et ne servaient à rien pour les vraies. Cet écart s'est réduit vite. Sur l'évaluation de code Terminal-Bench, Haiku 4.5 a obtenu zéro. Haiku 5.5 a obtenu 39,2 %. Sur OSWorld, qui teste la capacité à piloter un ordinateur via son interface, il est passé de 15,7 % à 72,4 %, devant le GPT-6 Luna comparable à 48,9 %.
Anthropic a aussi doté Haiku du premier effort de raisonnement ajustable de la gamme, avec cinq niveaux, de faible à maximal. Cela permet à un développeur de dépenser du calcul là où c'est utile et de s'en passer là où ça ne l'est pas : une petite fonctionnalité au gros effet sur le coût d'exécution en continu.
Le cadrage en sous-agent
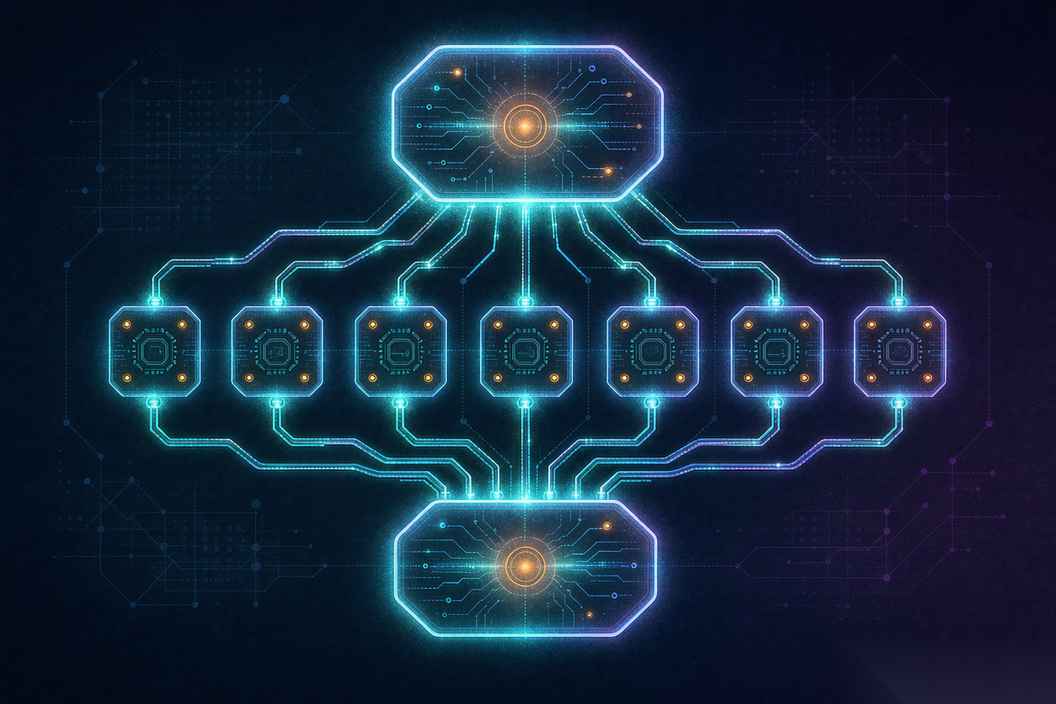
Le point de cette sortie qu'il faut souligner, c'est le positionnement. Anthropic a indiqué que Haiku 5.5 peut servir de sous-agent aux modèles plus gros Opus 5.5 et Sonnet 5.5. En clair : un modèle phare planifie et décide, et Haiku fait le travail — organiser des documents, piloter un ordinateur, traiter des données.
C'est un vrai changement d'architecture, et il recompose le débat sur les coûts. Non seulement chaque appel coûte moins cher, mais un appel de planification coûteux peut désormais se ramifier en de nombreux appels d'exécution bon marché. Un agent qui faisait tourner un modèle phare à chaque étape peut réserver le modèle phare à la partie difficile et confier tout le reste à Haiku. La facture peut baisser plus que ne le suggère la remise par token, parce que c'est le nombre d'appels coûteux lui-même qui change.
Les rivaux d'Anthropic convergent vers la même forme par d'autres angles. Gemini 4 Argon de Google, lancé le 1er octobre, vise le code, la recherche, la finance et le juridique, et prend en charge des sorties allant jusqu'à un million de tokens pour les grandes revues. Les modèles de milieu de gamme d'OpenAI multiplient les baisses de prix pour tenir le terrain. Les messages de lancement diffèrent, mais le pari de fond est commun : le travail n'est pas un modèle qui répond à une question. Ce sont de nombreux appels, orchestrés, et l'orchestrateur a besoin de mains bon marché.
Pourquoi le goulot d'étranglement s'est déplacé
Il y a un chiffre qui explique l'urgence. Les analystes qui suivent le domaine estiment à environ 79 millions le nombre d'agents actifs quotidiens dans le monde en 2026, contre quelque 29 millions l'année précédente, avec des projections à plusieurs milliards d'ici 2030. Quel que soit le chiffre exact, la direction est claire. Les agents passent de la démonstration à la production, et ce qui bloque un agent en production est rarement le fait que le modèle est trop bête. C'est que l'exécuter assez souvent coûte trop cher.
C'est pourquoi le secteur s'est mis à parler de la couche d'orchestration, celle qui découpe une requête en étapes, oriente chaque étape vers un modèle approprié et assemble le résultat. Quand les modèles de base deviennent moins chers, cette couche prend de la valeur, pas l'inverse, car c'est elle qui décide où va le modèle bon marché.
Comment une chaîne répartit réellement le travail
Le discours abstrait sur les sous-agents devient plus clair avec un cas concret. Supposez que vous demandiez à un agent d'étudier un marché et de produire une note de synthèse. Le modèle phare lit la demande, décide quoi chercher et planifie les étapes. Un petit modèle se charge ensuite du gros du labeur : il visite des pages, extrait des chiffres, remet en forme des tableaux, déduplique les sources et vérifie que chaque affirmation a une citation. Le modèle phare revient à la fin pour rédiger la synthèse et juger si le brouillon est suffisant. Un appel coûteux à chaque extrémité, beaucoup d'appels bon marché au milieu.
Ce schéma se répète d'une tâche à l'autre. Tout ce qui est à fort volume et à faible ambiguïté est un candidat pour le modèle bon marché : remplir des formulaires, lire des journaux, classer des tickets de support, vérifier qu'un document correspond à un modèle type. Tout ce qui demande de juger de la suite à donner reste au modèle phare. La frontière n'est pas fixe, et le travail d'ingénierie intéressant aujourd'hui consiste à décider où elle se situe pour chaque flux de travail.
L'effort de raisonnement ajustable d'Anthropic s'inscrit parfaitement ici. Une tâche qui demande une touche légère peut tourner à faible effort, et une tâche qui exige plus de soin peut être poussée plus haut sans changer de modèle. En pratique, cela signifie qu'un même modèle bon marché peut servir aussi bien à une classification rapide qu'à une revue minutieuse, ce qui réduit le nombre de pièces mobiles à gérer pour une équipe.
Ce que la baisse de prix change pour les produits
Une exécution moins chère change les produits qui valent la peine d'être construits. Une fonctionnalité qui lance un agent sur chaque message entrant n'avait aucun sens quand chaque exécution coûtait de l'argent réel. Elle en a un quand l'exécution coûte une fraction de centime. D'où une vague de fonctionnalités techniquement possibles depuis un an et économiquement impossibles jusqu'ici : des surveillances permanentes, l'enrichissement élément par élément, des relecteurs en arrière-plan qui vérifient chaque livrable plutôt qu'un échantillon.
Il y a un piège, et il est facile d'y tomber. Quand l'exécution est bon marché, les équipes cessent de la mesurer. Un flux qui lance mille appels bon marché par jour paraît inoffensif au niveau de l'appel unitaire et peut pourtant aboutir à une facture mensuelle surprenante une fois inclus les nouvelles tentatives, les échecs et les escalades vers un modèle coûteux. Le chiffre qui compte est le coût d'une tâche menée à bien, pas celui d'un appel isolé.
Le problème des benchmarks pour les petits modèles
Les petits modèles progressent sur les benchmarks, et c'est précisément là que la progression est la plus facile à surinterpréter. Un score marquant à un test de pilotage d'ordinateur dit que le modèle sait suivre une séquence connue d'étapes d'interface. Il dit beaucoup moins de choses sur sa capacité à savoir quand s'arrêter, quand demander de l'aide, ou quand une tâche a discrètement mal tourné. Ce sont ces comportements qui font échouer les agents bon marché en production, et ils sont difficiles à noter.
La défense pratique manque de glamour. Donnez à un sous-agent bon marché une tâche étroite, une définition claire de ce qui est terminé, et un moyen d'escalader plutôt que de deviner. Puis observez ce qu'il fait sur les cas limites pendant une semaine avant de lui confier quoi que ce soit d'important. Un modèle bon marché qui connaît les limites de sa tâche est plus utile qu'un modèle astucieux qui improvise.
Les réserves honnêtes
Un modèle bon marché sûr de lui et dans l'erreur est pire qu'un modèle coûteux, et les chaînes d'agents multiplient ce risque. Chaque étape supplémentaire est un endroit où une erreur peut entrer et se propager. Le prix par token ne dit rien de la manière dont le modèle bon marché a traité une instruction ambiguë par rapport à ce qu'aurait fait une personne.
Il existe aussi un vide de gouvernance qui n'a pas été comblé. Les recommandations du NIST et de la CISA fin septembre traitent les agents comme des identités non humaines à faible niveau de confiance et préconisent des identifiants à durée de vie courte, des inventaires tenus à jour et une validation humaine pour les actions à risque élevé. La plupart des organisations n'ont ni les inventaires ni les circuits de validation. Une exécution bon marché facilite le lancement de nombreux agents et complique le décompte de ceux qui tournent.
Ce que cela signifie si vous développez
La bonne habitude à prendre dès maintenant : cesser de se tourner par défaut vers le plus gros modèle. Découpez une tâche en planification et exécution, réservez le modèle phare aux endroits où le jugement est nécessaire et orientez le reste vers un petit modèle. Mesurez toute la chaîne, pas un appel isolé.
Haiku 5.5 n'est pas l'actualité parce qu'il est bon marché. Il l'est parce que le segment bon marché est enfin devenu assez bon pour porter les parties d'un agent qui exigeaient auparavant le modèle coûteux.
Articles associés
Le protocole PACT de Decagon veut faire du consentement un standard
Decagon a ouvert un protocole pour verifier l'identite d'un agent personnel et les permissions qu'un client lui a accordees. C'est de la plomberie, et elle decide si l'economie des agents fonctionne.
La vague des retrouvailles par IA : un debat que la Chine n'arrive pas a trancher
Des films hommage par IA ont ramene des figures disparues sur les ecrans chinois et recolte des centaines de milliers de likes. Puis la controverse est arrivee, et elle portait sur le consentement.
Apple a publie un modele multimodal ouvert et n'en a presque rien dit
Cette sortie axee sur la recherche a glisse sous les radars grand public, mais son ancrage visuel tres fin dit beaucoup de la direction de la pile IA d'Apple.
OpenCut et le moment du CapCut open source
Un editeur video gratuit sous licence MIT grimpe sans cesse dans les tendances GitHub, et sa feuille de route inclut un serveur MCP pour agents IA. Les outils autour des medias IA rattrapent les modeles.