
Dix images de référence à la fois : l'édition d'images par IA passe des prises uniques aux compositions
Pendant longtemps, l'édition d'images par IA se résumait à une image de référence et une instruction. On montrait une photo au modèle, on lui indiquait quoi modifier, et on obtenait un résultat. Cela couvrait beaucoup de cas, mais passait à côté de la façon dont les gens pensent réellement les images, souvent en termes de combinaison de plusieurs sources en une seule.
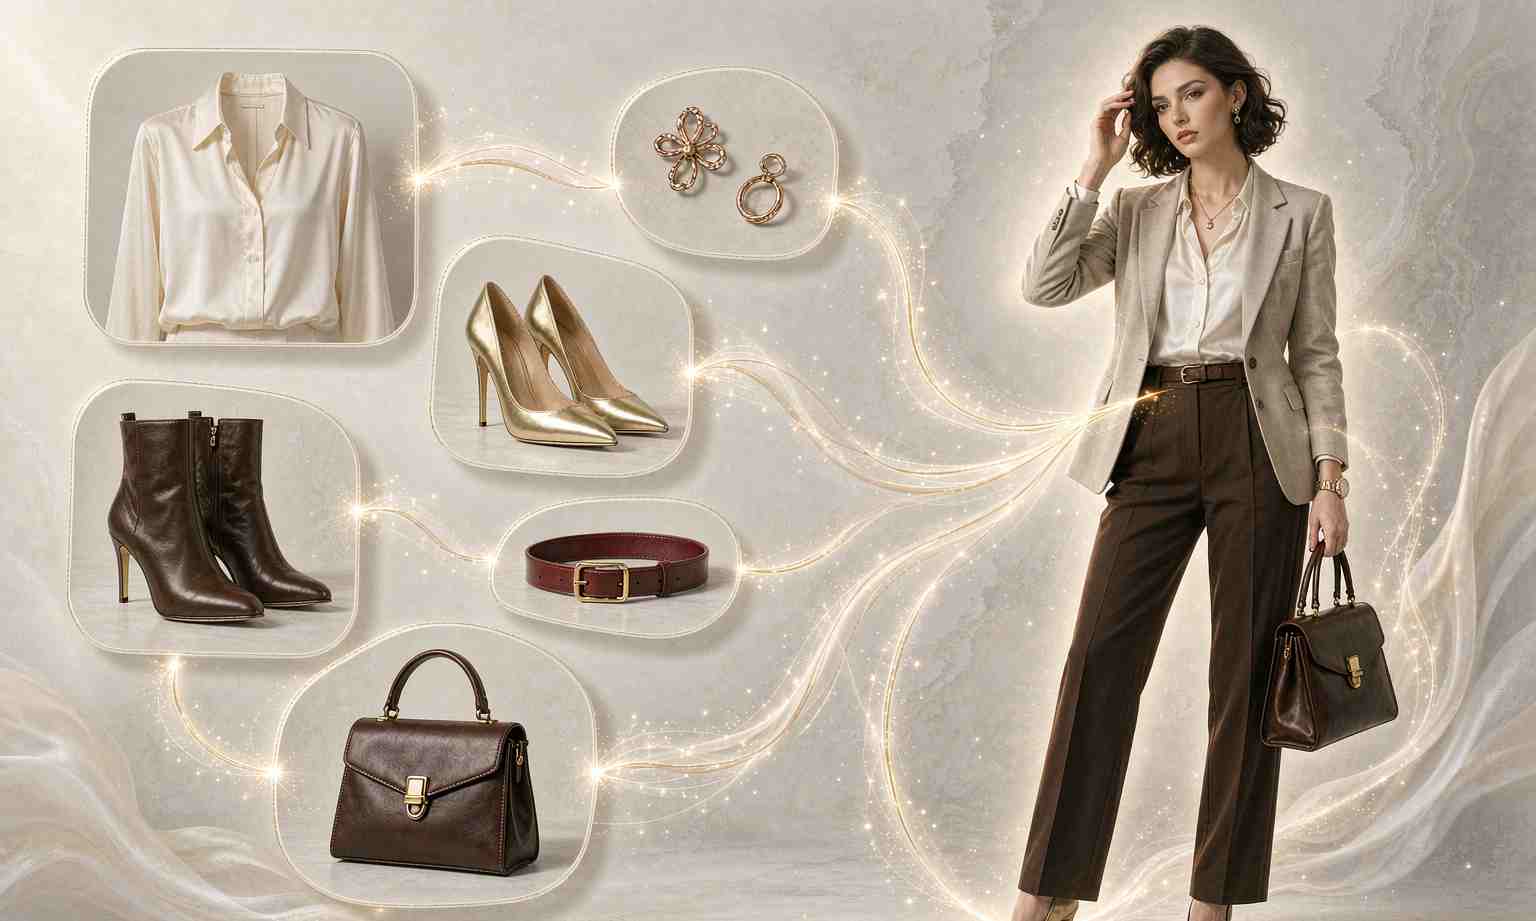
Qwen-Image 2.1 porte le nombre de références jusqu'à dix. Le modèle peut prendre six portraits distincts et les fusionner en une seule photo de groupe, ou assembler une tenue complète à partir d'un mannequin, d'une chemise, de chaussures, d'un sac et d'un chapeau, une référence chacun. C'est un type de tâche différent de l'édition mono-image, et c'est le genre de tâche qui revient constamment dans le travail réel.
Pensez aux cas pratiques. Une marque veut une image de campagne avec trois de ses produits disposés dans une scène, chaque produit fourni sous forme de photo distincte. Un photographe de mariage veut combiner plusieurs clichés en un seul. Un vendeur de mode veut montrer une silhouette complète construite à partir de pièces de catalogue. Un character designer veut garder un visage cohérent sur une douzaine de variations. L'édition à référence unique vous force à régénérer et à retoucher, en nourrissant une image à la fois et en espérant que le modèle garde tout le reste cohérent. L'édition multi-références vous permet de fournir les éléments au modèle et de le laisser composer.
La difficulté a toujours été computationnelle. Plus d'images de référence signifie plus de tokens, et plus de tokens signifie généralement une génération plus lente et davantage de mémoire. Si vous alimentez naïvement un modèle avec dix références et que vous les réencodez à chaque étape du processus de diffusion, le coût explose et la fonctionnalité devient inutilisable sur autre chose qu'un GPU de datacenter. L'approche de Qwen repose sur un schéma d'attention à granularité mixte. Les instructions textuelles reçoivent un masque causal au niveau des tokens, tandis que la génération d'images reçoit un masque au niveau des chunks. Un mécanisme de réutilisation du cache KV permet de calculer une fois les images de référence et les instructions, puis de les réutiliser comme contexte statique à chaque étape, au lieu de les recalculer à chaque fois.
L'idée est assez simple. Si les références ne changent pas pendant la génération, il n'y a aucune raison de les réencoder à chaque étape. On les calcule une fois, on les met en cache, et on dépense la puissance de calcul sur les parties qui changent réellement. C'est le genre d'ingénierie qui ne fait pas la une, mais qui détermine si une fonctionnalité est réellement utilisable sur du matériel grand public. La différence entre « prend en charge dix références » sur une fiche technique et « prend en charge dix références sans dépassement de délai » en pratique tient exactement à ce type de mise en cache.
Le saut de deux à dix références est bien plus qu'un simple nombre plus grand. Il change ce que l'on peut décrire. L'édition mono-image produit des variations, la même image modifiée. L'édition multi-images produit des combinaisons, de nouvelles images assemblées à partir d'éléments, et c'est dans les combinaisons que réside une grande partie de la valeur commerciale. Photographie de produit, portraits de groupe, lookbooks, composition de scènes, storyboards à partir d'un ensemble d'éléments : tout cela s'ouvre dès que le modèle peut tenir plusieurs entrées à la fois et raisonner sur la façon dont elles s'assemblent.
Cela signale aussi une direction plus large pour les modèles d'images. Les premiers modèles étaient du texte-vers-image : décrivez une scène, obtenez une image. Puis est venue l'édition image-vers-image : donnez une image, décrivez une modification. Aujourd'hui, la frontière est la composition : fournir de nombreuses entrées à un modèle et le laisser raisonner sur leur combinaison. Cela se rapproche de la façon dont travaille un designer humain, qui assemble à partir de pièces plutôt que de décrire à partir de zéro, et cela pointe vers des modèles qui se comportent moins comme des générateurs et plus comme des collaborateurs.
Il y a un angle confidentialité et contrôle qui mérite d'être souligné. Quand un modèle peut composer à partir de dix références, l'utilisateur garde le contrôle des entrées. Au lieu de décrire un produit en espérant que le modèle le rende fidèlement, vous lui fournissez la photo réelle du produit. Au lieu de décrire une personne, vous lui fournissez son image réelle, dans les limites de consentement qui s'appliquent. L'édition multi-références est, en un sens, un pas vers une génération ancrée dans le réel, où le modèle s'appuie sur des ressources authentiques plutôt que d'halluciner à partir d'une description textuelle.
Il reste de vraies limites. La préservation de l'identité de plusieurs personnes dans une même image demeure délicate, et plus vous fournissez de références, plus le modèle risque de confondre les attributs entre elles : le mauvais visage sur le mauvais corps, la mauvaise couleur sur le mauvais objet. Le plafond de dix images est une étape, pas un problème résolu, et les modes d'échec deviennent plus étranges à mesure que le nombre d'entrées augmente. L'équipe a manifestement fait le travail d'ingénierie pour que ce soit rapide, mais le travail sur la qualité se poursuit.
Les contrôles d'édition locale font partie du même ensemble. Vous pouvez dessiner des cercles, peindre des annotations ou fournir une image de masque distincte pour cibler une modification sur une région sans toucher au reste. Combiné à l'entrée multi-références, cela commence à ressembler à un véritable outil de composition, le genre de chose qui nécessitait auparavant des calques dans un éditeur graphique, désormais exprimable sous forme d'un ensemble de références et d'instructions adressées à un seul modèle.
Pour quiconque construit des outils créatifs, la leçon est simple. La prochaine vague de différenciation ne sera pas « de meilleures images uniques ». Elle sera « combien d'éléments le modèle peut-il tenir et combiner à la fois, et avec quelle précision pouvez-vous lui dire quoi modifier ». Dix références est la réponse actuelle. Elle ne restera pas longtemps à dix.
Il y a un cadre plus large à poser autour de tout cela. Pendant des années, la promesse de la génération d'images par IA était « décrivez, obtenez ». Cette promesse fonctionnait pour un usage occasionnel, mais n'a jamais vraiment fonctionné pour les professionnels, car ceux-ci partent rarement d'une description vide. Ils partent de ressources : une photo de produit, une image de référence, une charte de marque, un visage qui doit rester cohérent. Le mouvement vers l'édition multi-références est, au fond, une concession à cette réalité. On apprend au modèle à partir de ce que l'utilisateur possède déjà, plutôt que de ce qu'il peut décrire.
C'est pourquoi l'ingénierie compte. Garder dix références en contexte et les maintenir distinctes n'est pas simplement une version plus grande d'en garder une. C'est un problème différent : la différence entre se souvenir d'un seul visage et se souvenir de dix personnes assez bien pour les distinguer sur une photo de groupe. Le masquage au niveau des chunks et la réutilisation du cache KV décrits par Qwen sont les techniques spécifiques qui résolvent ce problème, et c'est le genre de détail qui détermine si la fonctionnalité marche en pratique ou seulement en démo.
L'implication commerciale est directe. Les flux de travail que l'édition multi-références débloque — composition de produits, portraits de groupe, lookbooks, génération de ressources de marque — sont tous des choses pour lesquelles les gens paient actuellement, que ce soit en outils ou en main-d'œuvre. Si un modèle peut les réaliser suffisamment bien, la valeur se déplace du travail humain de composition vers la capacité du modèle à tenir et combiner. C'est un véritable changement économique, et c'est pourquoi cette fonctionnalité, plus que celles taillées pour les benchmarks, est celle à surveiller pour savoir où l'industrie se dirige réellement.
Il y a aussi un angle créatif facile à manquer. L'édition multi-références change ce que l'on considère comme du « prompting ». Un utilisateur qui fournit dix références n'écrit pas une description : il organise une sélection, fait des choix sur ce qu'il faut inclure et ce qu'il faut laisser de côté. Cela relève davantage de la direction artistique que de l'ingénierie de prompt, et cela pointe vers un avenir où l'acte créatif dans le travail d'image par IA tient autant à la sélection et à la combinaison qu'au langage. Le plafond de dix références est, en ce sens, le premier vrai pas vers des modèles d'images qui traitent l'utilisateur comme un metteur en scène plutôt que comme un demandeur.
Articles associés
La transparence native est discrètement la nouvelle fonctionnalité la plus utile des images IA
Tout le monde demande du réalisme. Les designers demandent un arrière-plan transparent. Pourquoi la génération native de canal alpha est la fonctionnalité discrète qui change les vrais flux de travail.
Qwen-Image 2.1 d'Alibaba vient de changer la conversation sur les licences des modèles ouverts
Les spécifications techniques sont impressionnantes, mais la licence est la vraie histoire. Qwen-Image 2.1 abandonne Apache 2.0 pour une licence de recherche, et les petites lignes comptent désormais plus que jamais.
Tongyi Wanxiang Qwen-Image 2.1 passe en open source : comment un petit modèle 7B intègre les images transparentes et l’édition de 10 images dans une carte graphique grand public
Un modèle open source de génération d’images de 7B : comment parvient-il à faire tenir images transparentes et édition multi-images dans une carte graphique de 6 Go ? Décryptage des principales évolutions et du tournant de licence de Qwen-Image 2.1.
Peut-on encore distinguer une image générée par IA d’une image réelle ? La réponse honnête est non.
Les indices ont disparu et les détecteurs ne sont pas fiables. La réponse honnête à la détection d’images IA est non, et la solution se situe en amont de vos yeux.