
2 800 milliards de paramètres sur un GPU de 4 Go : comment AirLLM a franchi le mur de la VRAM
Le mur sur lequel tout le monde bute
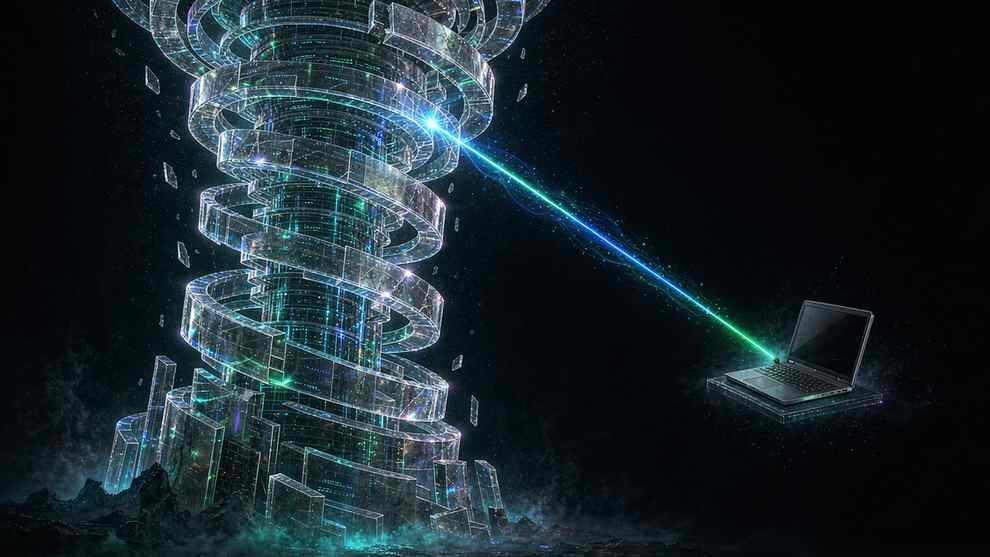
Il y a un moment précis que rencontre tout développeur qui veut faire tourner un grand modèle en local. Ce n'est pas une question de compétence ni de coût. C'est un chiffre dans une fiche technique : la mémoire vidéo. Un modèle ouvert sérieux ne tient pas sur la carte graphique que la plupart des gens possèdent, et la solution habituelle, acheter une carte plus grosse, a atteint un prix devenu absurde.
Alors le domaine s'est rempli de contournements. Quantifier les poids jusqu'à quatre bits. Déporter une partie du modèle vers la RAM système. Louer le matériel de quelqu'un d'autre. Chacun fonctionne, chacun coûte quelque chose, et chacun modifie le modèle d'une manière qu'il faut assumer. Puis il y a AirLLM, un dépôt situé près du sommet des tendances GitHub ce mois-ci, dont le README avance une affirmation qui ressemble à une coquille : 2 800 milliards de paramètres, un seul GPU de 4 Go.
En quoi consiste réellement l'astuce
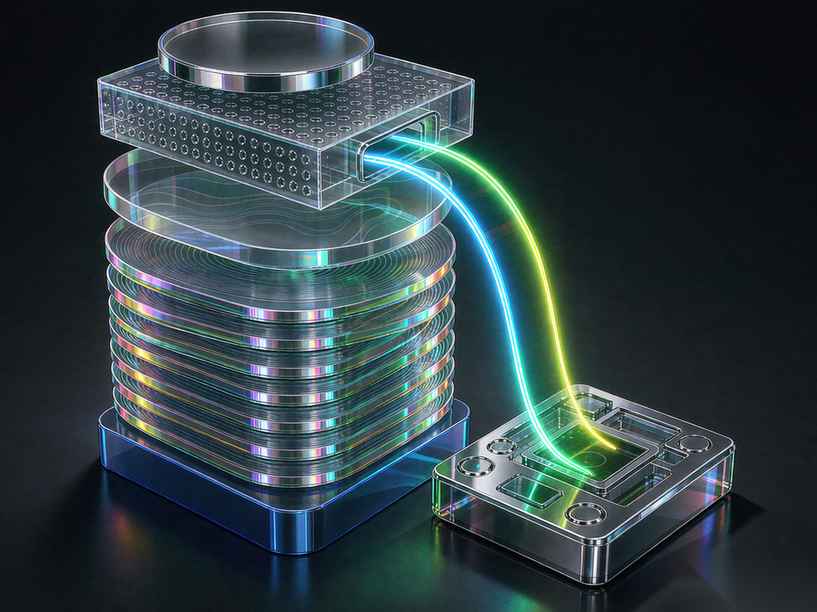
L'idée derrière AirLLM n'est pas de rendre le modèle plus petit. Elle est de cesser de vouloir le garder entier en mémoire d'un seul coup. Au lieu de charger chaque couche du réseau dans la carte graphique avant de générer un token, l'approche fait défiler le modèle une couche à la fois, en tirant chaque bloc du disque juste avant d'en avoir besoin, en l'utilisant, puis en le libérant.
À tout instant, seule une fine tranche du modèle doit résider dans la mémoire rapide. Le reste peut rester sur un disque. La carte graphique devient un plan de travail plutôt qu'un entrepôt, et la taille du modèle cesse d'imposer un plafond ferme à la machine capable de le faire tourner.
C'est la même raison qui permet à une personne de lire un livre de mille pages sur un bureau très petit. On n'a pas besoin du livre entier devant soi. On a besoin de la page en cours, plus d'un moyen d'aller chercher la suivante.
Le compromis honnête
Si faire défiler les couches dans un petit GPU était gratuit, tout le monde le ferait déjà, il vaut donc la peine de dire clairement ce que cela coûte. Lire les poids depuis le disque à chaque token est lent d'une manière facile à sous-estimer. La carte graphique reste à l'arrêt pendant qu'elle attend des données qu'elle aurait pu utiliser immédiatement si elles avaient été résidentes.
La conséquence pratique est que ces configurations conviennent à un ensemble de tâches différent de celui d'un modèle chargé entièrement en mémoire. Si vous avez besoin d'un flux constant de réponses rapides pour un produit de chat, le streaming est le mauvais outil. Si vous voulez faire tourner un très grand modèle occasionnellement, sur du matériel que vous possédez déjà, pour une tâche où le débit importe moins que le simple fait de pouvoir la réaliser, le compromis bascule en votre faveur.
Il est utile de placer cela à côté du contournement plus familier. La quantification réduit le modèle lui-même, échangeant un peu de précision contre un encombrement moindre, et elle change ce qu'est le modèle. Le streaming laisse les nombres du modèle intacts et déplace l'endroit où ils vivent. Les deux ne sont pas rivaux, ils se cumulent. Un modèle quantifié et de surcroît diffusé couche par couche est plus petit et plus léger que l'une ou l'autre technique seule, ce qui explique pourquoi les deux approches ont tendance à apparaître ensemble en pratique.
Il existe un troisième coût, moins mis en avant : le disque. Diffuser les poids signifie les lire depuis le stockage à chaque passe, si bien qu'un disque lent devient le nouveau goulot d'étranglement dès que le modèle cesse de tenir en mémoire. Les personnes qui s'engagent sur cette voie apprennent vite que le matériel qui compte n'est pas seulement le GPU. Un SSD rapide peut faire plus pour le débit, ici, que quelques gigaoctets de mémoire vidéo supplémentaires.
Cette distinction, entre interactivité et faisabilité, est celle que la plupart des comparaisons manquent. Un modèle qui tourne au ralenti sur votre bureau reste un modèle que vous pouvez faire tourner sur votre bureau. Pour un chercheur sans cluster, ou un développeur qui veut tester un prompt précis contre un modèle énorme précis, cela peut suffire.
Pourquoi cela reste dans les tendances
AirLLM n'est pas nouveau. Il existe depuis assez longtemps pour être familier à ceux qui suivent l'inférence locale de près. Il refait surface dans les listes de tendances pour une raison qui tient moins à l'implémentation précise qu'à la pression qui le pousse.
Les modèles à poids ouverts ne cessent de grandir. Les meilleurs modèles ouverts d'image, de vidéo et de langage se situent désormais fermement dans une fourchette qu'aucune carte graphique grand public ne peut contenir confortablement. En même temps, le prix des cartes à grande mémoire capables de les contenir a monté, pas baissé, porté par la même demande qui remodèle le reste du marché du matériel. L'écart entre ce qu'il est possible de faire tourner et ce qu'il est possible de faire tourner sur du matériel abordable ne cesse de se creuser.
Tout projet qui s'oppose à cet écart, même imparfaitement, continuera de trouver un public. L'alternative est un monde où la frontière des modèles ouverts est théoriquement accessible à tous et pratiquement réservée à ceux qui possèdent un data center. Les contournements sont la façon dont l'ouvert des poids ouverts reste honnête.
Ce que cela ne résout pas
Deux choses différentes se confondent ici. Faire tourner un grand modèle sur un petit GPU est un problème de mémoire. Obtenir une sortie utile d'un grand modèle est une question de capacité, et les deux ne sont pas identiques. Un modèle de 2 800 milliards de paramètres diffusé à travers une carte de 4 Go génère toujours du texte à un rythme fixé par son disque et sa bande passante, et la qualité de ce texte est celle du modèle, non ce que le contournement a rendu possible.
Il y a aussi une dimension de licence que la réussite technique ne touche pas. Le fait de pouvoir faire tourner un modèle en local ne dit rien sur la permission d'utiliser ses poids pour votre usage. La configuration d'inférence locale la plus impressionnante au monde reste liée aux conditions attachées au modèle qu'elle exécute.
Le point plus large
La frontière de l'IA locale n'est pas une percée unique. C'est une longue série de décisions d'ingénierie peu glorieuses sur l'endroit où vivent les données, quand elles se déplacent et ce que vous êtes prêt à attendre. AirLLM en est un bon exemple parce qu'il est très direct sur le marché : vous renoncez à la vitesse, et en échange vous pouvez faire tourner quelque chose qui n'était pas censé tenir.
Pour un nombre croissant de personnes qui se soucient plus de ce qu'un modèle peut faire que de sa vitesse, c'est un marché raisonnable. Et pour tous les autres, c'est un rappel : ce modèle a besoin de X gigaoctets est une décision de conception autant qu'une limite matérielle. Quelqu'un, quelque part, cherche toujours le bureau plus petit que le livre.
Articles associés
L'agent indépendant du harness : exécuter n'importe quel modèle de pointe sur sa propre machine
Le modèle est l'intelligence, le harness est la plomberie, et les deux n'ont pas besoin de vivre dans le même paquet. Une série de projets open source défait ce lien, pour exécuter n'importe quel modèle de pointe depuis l'interface que vous préférez, avec un accès local par défaut.
Un bit suffit : pourquoi le BitNet de Microsoft séduit toujours
Un poids à un bit n'est pas un gadget. Comment le schéma ternaire du BitNet de Microsoft remplace la multiplication par l'addition et fait tourner de grands modèles sur un CPU ordinaire, et à quel prix.
Le nouveau manuel des règles de la vidéo IA : les étiquettes lisibles par machine au titre de l'EU AI Act
L'article 50 de l'EU AI Act fait des métadonnées de provenance une question de conformité. L'étiquette est intégrée à la génération et le pipeline la perd facilement.
Votre agent IA oublie tout : les astuces MCP qui règlent l'engorgement du contexte
Un agent ne devient pas plus intelligent en tournant longtemps, il s'abrutit quand son context window se remplit de déchets. Du sandboxing des sorties d'outils à la mémoire persistante et au routing, ces projets réparent la mémoire des agents.