
La economía de los subagentes: por qué los modelos baratos son la verdadera historia de los agentes
El lanzamiento de IA más trascendental de principios de octubre fue el más barato. El 7 de octubre, Anthropic lanzó Claude Haiku 5.5 y dijo que su coste medio de ejecución era aproximadamente un 75 por ciento menor que el del Haiku anterior. Para solicitudes de menos de 100.000 tokens, el precio de la API bajó alrededor de un 90 por ciento, hasta diez centavos por millón de tokens de entrada y cincuenta centavos por millón de salida. Anthropic también redujo a la mitad el precio de lectura de caché en Sonnet 5.5.
Los modelos baratos son fáciles de descartar. Parecen un movimiento de precios, no una historia de capacidades. Pero el detalle interesante de este lanzamiento no es el precio. Es para qué sirve Haiku 5.5.
El modelo pequeño creció
La vieja crítica a los modelos pequeños era que servían para tareas simples y eran inútiles para las reales. Esa brecha se ha reducido rápido. En la evaluación de programación Terminal-Bench, Haiku 4.5 obtuvo cero. Haiku 5.5 obtuvo un 39,2 por ciento. En OSWorld, que evalúa operar una computadora a través de su interfaz, pasó del 15,7 por ciento al 72,4 por ciento, por delante del comparable GPT-6 Luna, con un 48,9 por ciento.
Anthropic también le dio a Haiku el primer esfuerzo de razonamiento ajustable de la línea, con cinco niveles de bajo a máximo. Eso permite a un desarrollador gastar cómputo donde ayuda y omitirlo donde no, lo cual es una función pequeña con un gran efecto en el coste de ejecutar algo de forma continua.
El encuadre de los subagentes
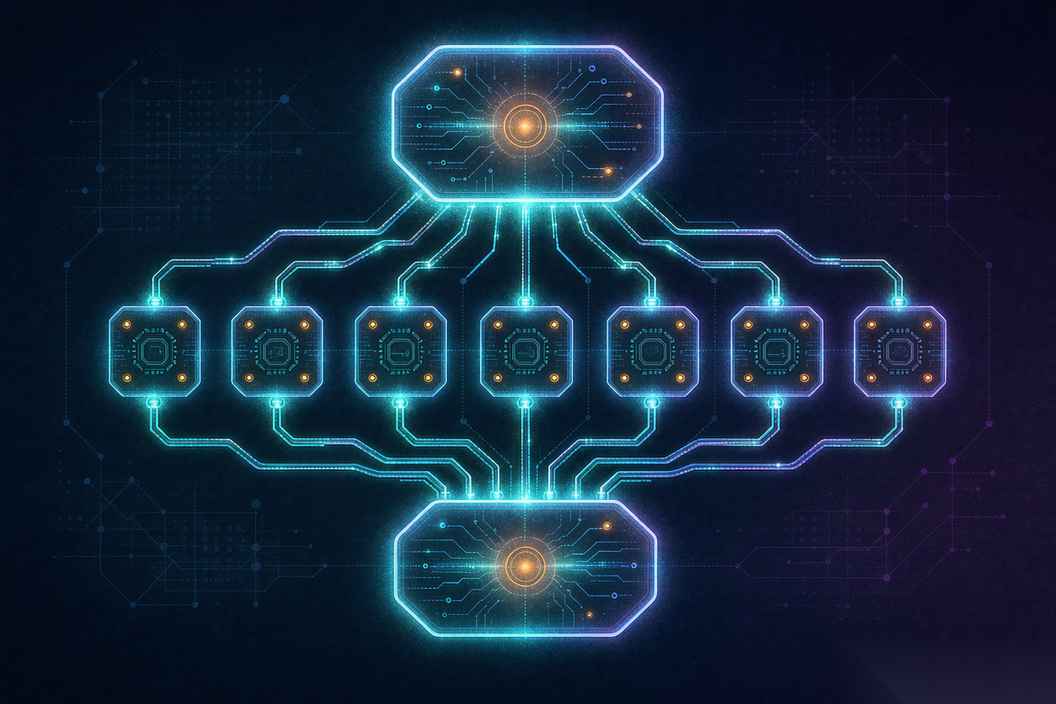
La parte del lanzamiento que vale la pena subrayar es el posicionamiento. Anthropic dijo que Haiku 5.5 puede servir como subagente para los más grandes Opus 5.5 y Sonnet 5.5. En términos sencillos, un modelo insignia planifica y decide, y Haiku hace la ejecución: organizar documentos, operar una computadora, manejar datos.
Eso es un verdadero cambio arquitectónico, y replantea la conversación sobre costes. No se trata solo de que cada llamada sea más barata. Se trata de que una llamada de planificación costosa ahora puede ramificarse en muchas llamadas de ejecución baratas. Un agente que antes ejecutaba un modelo insignia para cada paso puede ejecutar un insignia para la parte difícil y Haiku para todo lo demás. La factura puede caer más de lo que sugiere el descuento por token, porque estás cambiando cuántas llamadas costosas ocurren en total.
Los rivales de Anthropic convergen hacia la misma forma desde otros ángulos. Gemini 4 Argon de Google, lanzado el 1 de octubre, está orientado a programación, investigación, finanzas y trabajo legal, y admite salidas de hasta un millón de tokens para revisiones grandes. Los modelos de gama media de OpenAI han estado recortando precios para mantener su posición. El mensaje de lanzamiento difiere, pero la apuesta subyacente es compartida: el trabajo no es un modelo respondiendo una pregunta. Son muchas llamadas, orquestadas, y el orquestador necesita manos baratas.
Por qué se trasladó el cuello de botella
Hay un número que explica la urgencia. Los analistas que siguen el campo sitúan los agentes activos diarios globales en aproximadamente 79 millones en 2026, frente a unos 29 millones el año anterior, con proyecciones de miles de millones para 2030. Cualquiera que sea la cifra exacta, la dirección es clara. Los agentes están pasando de las demostraciones a la producción, y lo que detiene a un agente de producción rara vez es que el modelo sea demasiado tonto. Es que ejecutarlo suficientes veces cuesta demasiado.
Cómo una cadena reparte realmente el trabajo
La charla abstracta sobre subagentes se vuelve más clara con un trabajo concreto. Supongamos que le pides a un agente que investigue un mercado y produzca un informe. El modelo insignia lee la solicitud, decide qué buscar y planifica los pasos. Luego, un modelo pequeño hace el trabajo pesado: visita páginas, extrae números, reformatea tablas, deduplica fuentes y comprueba que cada afirmación tenga una cita. El insignia vuelve al final para escribir la síntesis y decidir si el borrador es lo suficientemente bueno. Una llamada costosa en cada extremo, muchas llamadas baratas en medio.
Ese patrón se repite en las tareas. Todo lo que es de alto volumen y baja ambigüedad es candidato para el modelo barato: rellenar formularios, leer registros, clasificar tickets de soporte, comprobar que un documento coincida con una plantilla. Todo lo que requiere criterio sobre qué hacer a continuación se queda con el insignia. La línea no es fija, y el trabajo de ingeniería interesante ahora mismo es decidir dónde se sitúa para cada flujo de trabajo.
El esfuerzo de razonamiento ajustable de Anthropic encaja perfectamente aquí. Una tarea que necesita un toque ligero puede ejecutarse con esfuerzo bajo, y una que necesita más cuidado puede subirse sin cambiar de modelo. En la práctica, eso significa que el mismo modelo barato puede servir tanto para una clasificación rápida como para una revisión cuidadosa, lo que reduce cuántas piezas móviles tiene que gestionar un equipo.
Qué cambia el recorte de precios en los productos
La ejecución más barata cambia qué productos vale la pena construir. Una función que ejecuta un agente en cada mensaje entrante no tenía sentido cuando cada ejecución costaba dinero real. Tiene sentido cuando la ejecución cuesta una fracción de centavo. El resultado es una ola de funciones que eran técnicamente posibles desde hace un año y económicamente imposibles hasta ahora: monitores siempre activos, enriquecimiento por elemento, revisores en segundo plano que comprueban cada artefacto en lugar de una muestra.
Hay una trampa en eso, y es fácil caer en ella. Cuando la ejecución es barata, los equipos dejan de medirla. Un flujo de trabajo que ejecuta mil llamadas baratas al día parece inofensivo por llamada y aun así puede sumar una factura mensual sorprendente una vez que se incluyen reintentos, fallos y escalado a un modelo costoso. El número que importa es el coste de una tarea completada, no el coste de una sola llamada.
El problema de los benchmarks con los modelos pequeños
Los modelos pequeños están mejorando en los benchmarks, y los benchmarks son exactamente donde la mejora es más fácil de sobreinterpretar. Una puntuación destacada en una prueba de operación de computadoras dice que el modelo puede seguir una secuencia conocida de pasos de interfaz. Dice mucho menos sobre si el modelo sabe cuándo detenerse, cuándo pedir ayuda o cuándo una tarea ha salido mal en silencio. Esos comportamientos son donde los agentes baratos fallan en producción, y son difíciles de puntuar.
La defensa práctica no tiene glamur. Dale a un subagente barato un trabajo acotado, una definición clara de terminado y una forma de escalar en lugar de adivinar. Luego observa lo que hace en los casos límite durante una semana antes de confiarle algo que importe. Un modelo barato que conoce los límites de su tarea es más útil que uno ingenioso que improvisa.
Las salvedades honestas
Un modelo barato que se muestra seguro y se equivoca es peor que uno costoso, y las cadenas de agentes multiplican ese riesgo. Cada paso adicional es un lugar por donde puede entrar y propagarse un error. El precio por token no dice nada sobre si el modelo barato manejó una instrucción ambigua como lo haría una persona.
También hay una brecha de gobernanza que no se ha cerrado. Las directrices de NIST y CISA de finales de septiembre tratan a los agentes como identidades no humanas de baja confianza y piden credenciales de corta duración, inventarios actualizados y aprobación humana para acciones de mayor riesgo. La mayoría de las organizaciones no tiene ni los inventarios ni los flujos de aprobación. La ejecución barata facilita ejecutar muchos agentes y dificulta saber cuántos están en marcha.
Qué significa esto si construyes
El hábito útil que hay que adquirir ahora es dejar de recurrir al modelo más grande por defecto. Divide una tarea en planificación y ejecución, usa el insignia donde se requiere criterio y dirige el resto a un modelo pequeño. Mide toda la cadena, no una sola llamada.
Haiku 5.5 no es la historia porque sea barato. Es la historia porque la gama barata finalmente se volvió lo suficientemente buena como para cargar con las partes de un agente que solían necesitar el costoso.
Artículos relacionados
El protocolo PACT de Decagon quiere que el consentimiento sea un estandar
Decagon abrio un protocolo para verificar la identidad de un agente personal y los permisos que un cliente le concedio. Es fontaneria, y decide si la economia de los agentes funciona.
La ola de reencuentros con IA: un debate que China aun no sabe como sentir
Peliculas homenaje hechas con IA devolvieron a figuras fallecidas a las pantallas chinas y reunieron cientos de miles de me gusta. Luego llego la reaccion, y era sobre el consentimiento.
Apple publico un modelo multimodal abierto y casi no lo conto
Este lanzamiento centrado en la investigacion paso desapercibido, pero su anclaje visual de grano fino dice mucho de hacia donde va la pila de IA de Apple.
OpenCut y el momento del CapCut de codigo abierto
Un editor de video gratuito con licencia MIT sigue subiendo en las tendencias de GitHub, y su hoja de ruta incluye un servidor MCP para agentes de IA. Las herramientas en torno a los medios con IA alcanzan a los modelos.