
Diez imágenes de referencia a la vez: la edición de imágenes con IA pasa de tomas individuales a composiciones
Durante mucho tiempo, la edición de imágenes con IA significaba una imagen de referencia y una instrucción. Muestra una foto al modelo, dile qué cambiar y obtén un resultado. Eso cubría mucho, pero pasaba por alto la forma en que las personas piensan realmente en las imágenes, que a menudo consiste en combinar varias fuentes en una sola.
Qwen-Image 2.1 eleva el número de referencias hasta diez. El modelo puede tomar seis retratos separados y fusionarlos en una sola foto de grupo, o montar un conjunto completo a partir de un modelo, una camisa, unos zapatos, un bolso y un sombrero, una referencia para cada uno. Es un tipo de tarea distinta de la edición de una sola imagen, y es el tipo de tarea que aparece constantemente en el trabajo real.
Piensa en los casos prácticos. Una marca quiere una imagen de campaña con tres de sus productos dispuestos en una escena, cada producto proporcionado como una foto independiente. Un fotógrafo de bodas quiere combinar varias tomas en una. Un vendedor de moda quiere mostrar un look completo construido a partir de piezas de catálogo. Un diseñador de personajes quiere mantener un rostro consistente a lo largo de una docena de variaciones. La edición con una sola referencia te obliga a regenerar y parchear, alimentando una imagen a la vez y esperando que el modelo mantenga todo lo demás consistente. La edición multirreferencia te permite alimentar al modelo con las partes y dejar que él componga.
La parte difícil siempre ha sido la computacional. Más imágenes de referencia significa más tokens, y más tokens normalmente significa una generación más lenta y más memoria. Si alimentas ingenuamente diez referencias a un modelo y las recodificas en cada paso del proceso de difusión, el coste se dispara y la función se vuelve inutilizable en cualquier cosa que no sea una GPU de centro de datos. El enfoque de Qwen para esto es un esquema de atención de granularidad mixta. Las instrucciones de texto reciben una máscara causal a nivel de token, mientras que la generación de imágenes recibe una máscara a nivel de fragmento. Un esquema de reutilización de caché KV permite que las imágenes de referencia y las instrucciones se calculen una vez y se reutilicen como contexto estático a lo largo de los pasos, en lugar de recalcularlas en cada paso.
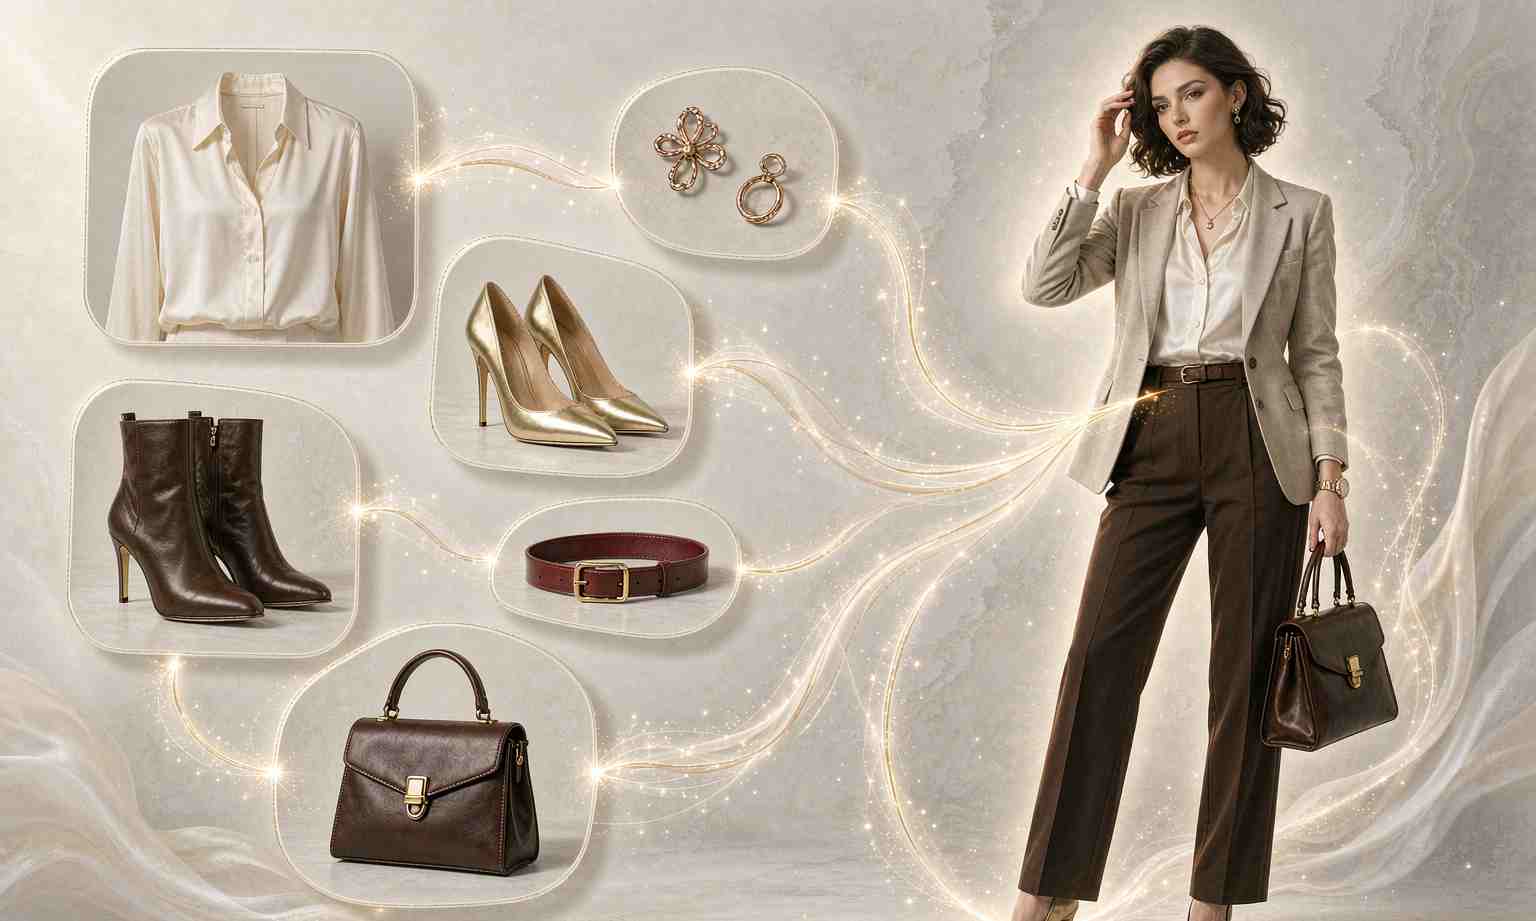
La idea es bastante sencilla. Si las referencias no cambian durante la generación, no hay razón para recodificarlas en cada paso. Calcúlalas una vez, guárdalas en caché y gasta el cómputo en las partes que realmente cambian. Ese es el tipo de ingeniería que no acapara titulares, pero determina si una función es realmente utilizable en hardware de consumo. La diferencia entre «admite diez referencias» en una ficha técnica y «admite diez referencias sin agotar el tiempo de espera» en la práctica es exactamente este tipo de caché.
El salto de dos referencias a diez es más que un número mayor. Cambia lo que puedes describir. La edición de una sola imagen produce variaciones, la misma imagen alterada. La edición con varias imágenes produce combinaciones, imágenes nuevas ensambladas a partir de partes, y en las combinaciones vive gran parte del valor comercial. Fotografía de producto, retratos de grupo, lookbooks, composición de escenas, storyboards a partir de un conjunto de recursos: todo eso se abre cuando el modelo puede sostener varias entradas a la vez y razonar sobre cómo encajan.
Esto también señala una dirección más amplia para los modelos de imagen. Los primeros modelos eran texto a imagen: describe una escena y obtén una imagen. Luego llegó la edición de imagen a imagen: dale una imagen, describe un cambio. Ahora la frontera es la composición: alimentar a un modelo con muchas entradas y dejar que razone sobre cómo se combinan. Eso se acerca más a cómo trabaja un diseñador humano, ensamblando a partir de piezas en lugar de describir desde cero, y apunta hacia modelos que se comportan menos como generadores y más como colaboradores.
Hay un ángulo de privacidad y control que merece la pena señalar. Cuando un modelo puede componer a partir de diez referencias, el usuario mantiene el control de las entradas. En lugar de describir un producto y esperar que el modelo lo represente con precisión, le proporcionas la foto real del producto. En lugar de describir a una persona, le proporcionas su imagen real, dentro de los límites de consentimiento que correspondan. La edición multirreferencia es, en cierto sentido, un paso hacia la generación fundamentada, donde el modelo se ancla a recursos reales en lugar de alucinar a partir de una descripción textual.
Todavía hay límites reales. La preservación de la identidad entre varias personas en una misma imagen sigue siendo delicada, y cuantas más referencias proporcionas, más posibilidades hay de que el modelo confunda atributos entre ellas: la cara equivocada en el cuerpo equivocado, el color equivocado en el objeto equivocado. El techo de diez imágenes es un paso, no un problema resuelto, y los modos de fallo se vuelven más extraños a medida que crece el número de entradas. Está claro que el equipo ha hecho el trabajo de ingeniería para que sea rápido, pero el trabajo de calidad sigue en curso.
Los controles de edición local forman parte del mismo paquete. Puedes dibujar círculos, pintar anotaciones o pasar una imagen de máscara independiente para dirigir una edición a una región sin tocar el resto. Combinado con la entrada multirreferencia, esto empieza a parecerse a una verdadera herramienta de composición, el tipo de cosa que antes requería capas en un editor de gráficos, ahora expresable como un conjunto de referencias e instrucciones para un único modelo.
Para cualquiera que construya herramientas creativas, la lección es clara. La próxima ola de diferenciación no es «mejores imágenes individuales». Es «cuántas cosas puede sostener y combinar el modelo a la vez, y con qué precisión puedes decirle qué cambiar». Diez referencias es la respuesta actual. No se quedará en diez por mucho tiempo.
Hay un marco más amplio que merece la pena poner alrededor de esto. Durante años, la promesa de la generación de imágenes con IA fue «descríbelo y lo obtienes». Esa promesa funcionó para el uso casual, pero nunca funcionó del todo para los profesionales, porque los profesionales rara vez parten de una descripción en blanco. Parten de recursos: una foto de producto, una imagen de referencia, una guía de marca, un rostro que tiene que mantenerse consistente. El avance hacia la edición multirreferencia es, en esencia, una concesión a esa realidad. Se está enseñando al modelo a partir de lo que el usuario ya tiene, en lugar de lo que el usuario puede describir.
Por eso importa la ingeniería. Sostener diez referencias en contexto y mantenerlas distintas no es solo una versión más grande de sostener una. Es un problema diferente, la diferencia entre recordar un solo rostro y recordar a diez personas lo suficientemente bien como para distinguirlas en una foto de grupo. El enmascaramiento a nivel de fragmento y la reutilización de caché KV que describe Qwen son las técnicas específicas para resolver ese problema, y son el tipo de detalle que determina si la función funciona en la práctica o solo en una demo.
La implicación comercial es directa. Los flujos de trabajo que desbloquea la edición multirreferencia —composición de productos, retratos de grupo, lookbooks, generación de recursos de marca— son cosas por las que la gente paga actualmente, ya sea en herramientas o en mano de obra. Si un modelo puede hacerlas lo suficientemente bien, el valor se desplaza del trabajo humano de composición a la capacidad del modelo de sostener y combinar. Es un cambio económico real, y es la razón por la que esta función, más que las favorables a los benchmarks, es la que hay que observar para saber hacia dónde se dirige realmente la industria.
También hay un ángulo creativo que es fácil pasar por alto. La edición multirreferencia cambia lo que cuenta como «prompting». Un usuario que proporciona diez referencias no está escribiendo una descripción, está curando un conjunto, tomando decisiones sobre qué incluir y qué dejar fuera. Eso se acerca más a la dirección de arte que a la ingeniería de prompts, y apunta hacia un futuro en el que el acto creativo en el trabajo con imágenes de IA tiene tanto que ver con la selección y la combinación como con el lenguaje. El techo de diez referencias es, en ese sentido, el primer paso real hacia modelos de imagen que tratan al usuario como un director en lugar de como un solicitante.
Artículos relacionados
La transparencia nativa es discretamente la nueva función más útil en las imágenes de IA
Todos piden realismo. Los diseñadores piden un fondo transparente. Por qué la generación nativa de canal alfa es la función discreta que cambia los flujos de trabajo reales.
El Qwen-Image 2.1 de Alibaba acaba de cambiar la conversación sobre las licencias de modelos abiertos
Las especificaciones técnicas son impresionantes, pero la licencia es la verdadera historia. Qwen-Image 2.1 deja atrás Apache 2.0 por una licencia de investigación, y la letra pequeña ahora importa más que nunca.
¿Todavía puedes distinguir una imagen de IA de una real? La respuesta honesta es no.
Los indicios han desaparecido y los detectores no son fiables. La respuesta honesta a la hora de detectar imágenes de IA es no, y la solución está aguas arriba de tus ojos.
El silencioso cambio en las licencias que podría cambiar las imágenes de IA de código abierto
Los pesos abiertos ya no significan lo que significaban hace un año. La letra pequeña de las licencias se está volviendo más complicada justo cuando los modelos mejoran.