
Die Sub-Agent-Ökonomie: Warum günstige Modelle die eigentliche Agenten-Story sind
Die folgenreichste KI-Veröffentlichung Anfang Oktober war die günstigste. Am 7. Oktober brachte Anthropic Claude Haiku 5.5 heraus und gab an, dass seine durchschnittlichen Betriebskosten etwa 75 Prozent niedriger lagen als beim vorherigen Haiku. Für Anfragen unter 100.000 Tokens fiel der API-Preis um rund 90 Prozent auf zehn Cent pro Million Input-Tokens und fünfzig Cent pro Million Output-Tokens. Anthropic halbierte außerdem den Cache-Read-Preis für Sonnet 5.5.
Billige Modelle werden leicht abgetan. Sie wirken wie ein Preisschritt, nicht wie eine Geschichte über Fähigkeiten. Doch das interessante Detail an dieser Veröffentlichung ist nicht der Preis. Es ist der Zweck von Haiku 5.5.
Das kleine Modell ist erwachsen geworden
Der alte Vorwurf an kleine Modelle war, dass sie für einfache Aufgaben taugen und für echte nutzlos sind. Diese Lücke ist schnell kleiner geworden. In der Coding-Evaluierung Terminal-Bench erreichte Haiku 4.5 null Punkte. Haiku 5.5 erreichte 39,2 Prozent. Bei OSWorld, wo das Bedienen eines Computers über seine Oberfläche getestet wird, ging es von 15,7 Prozent auf 72,4 Prozent – und lag damit vor dem vergleichbaren GPT-6 Luna mit 48,9 Prozent.
Anthropic gab Haiku außerdem den ersten anpassbaren Reasoning-Aufwand der Reihe, mit fünf Stufen von niedrig bis maximal. Entwickler können Rechenleistung dort einsetzen, wo sie hilft, und dort überspringen, wo nicht – ein kleines Feature mit großer Wirkung auf die Kosten des Dauerbetriebs.
Die Sub-Agent-Einordnung
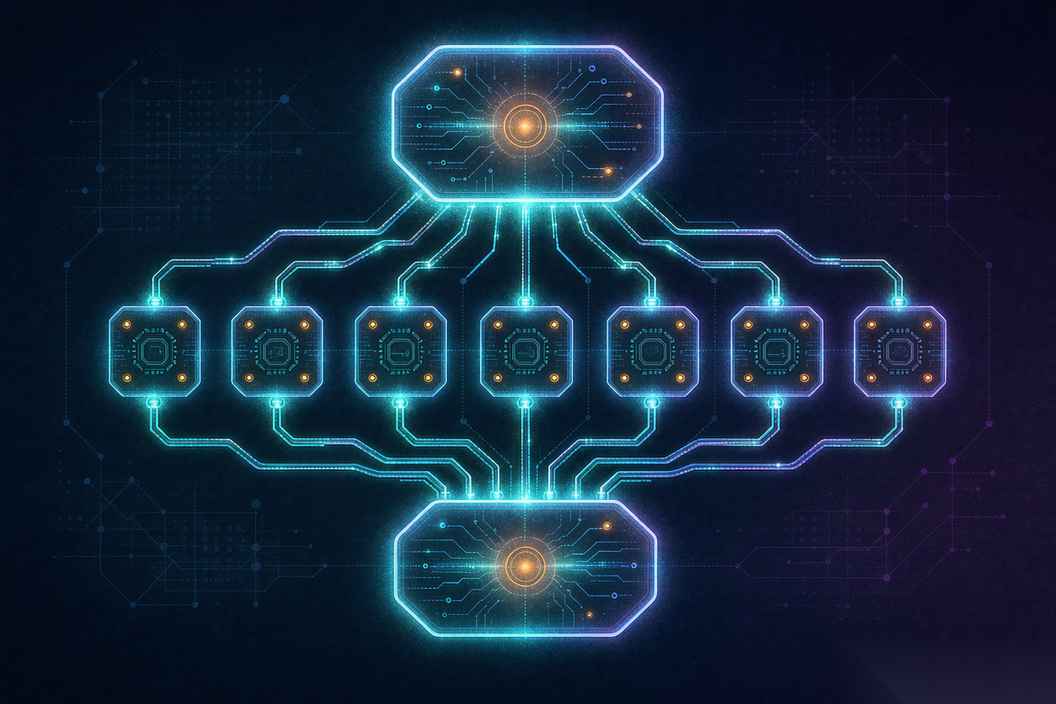
Der Teil der Veröffentlichung, der hervorgehoben werden sollte, ist die Positionierung. Anthropic sagte, Haiku 5.5 könne als Sub-Agent für die größeren Opus 5.5 und Sonnet 5.5 dienen. Klar gesagt: Ein Flaggschiffmodell plant und entscheidet, und Haiku erledigt die Arbeit: Dokumente organisieren, einen Computer bedienen, Daten verarbeiten.
Das ist ein echter architektonischer Wandel, und er verschiebt die Kostenbetrachtung. Es ist nicht nur so, dass jeder Aufruf billiger ist. Es ist so, dass ein teurer Planungsaufruf jetzt auf viele billige Ausführungsaufrufe verteilt werden kann. Ein Agent, der früher für jeden Schritt ein Flaggschiffmodell laufen ließ, kann ein Flaggschiff für den schwierigen Teil und Haiku für alles andere nutzen. Die Rechnung kann stärker sinken, als der Rabatt pro Token vermuten lässt, weil sich ändert, wie viele teure Aufrufe überhaupt stattfinden.
Anthropics Rivalen bewegen sich aus anderen Richtungen auf dieselbe Form zu. Googles Gemini 4 Argon, am 1. Oktober eingeführt, zielt auf Coding, Forschung, Finanz- und Rechtsarbeit und unterstützt Ausgaben von bis zu einer Million Tokens für große Prüfungen. OpenAIs Mittelklasse-Modelle senken die Preise, um Boden zu halten. Die Launch-Botschaften unterscheiden sich, aber die zugrunde liegende Wette ist dieselbe: Die Arbeit besteht nicht darin, dass ein Modell eine Frage beantwortet. Es sind viele orchestrierte Aufrufe, und der Orchestrator braucht billige Hände.
Warum sich der Engpass verschoben hat
Es gibt eine Zahl, die die Dringlichkeit erklärt. Analysten, die das Feld beobachten, schätzen die weltweit täglich aktiven Agenten im Jahr 2026 auf rund 79 Millionen, gegenüber etwa 29 Millionen im Vorjahr, mit Prognosen in den Milliardenbereich bis 2030. Wie auch immer die genaue Zahl lautet, die Richtung ist klar. Agenten bewegen sich von Demonstrationen in die Produktion, und was einen Produktionsagenten stoppt, ist selten, dass das Modell zu dumm ist. Es ist, dass es zu viel kostet, ihn oft genug laufen zu lassen.
Deshalb spricht die Branche zunehmend über die Orchestrierungsschicht, den Teil, der eine Anfrage in Schritte zerlegt, jeden Schritt an ein passendes Modell weiterleitet und das Ergebnis zusammensetzt. Wenn die Basismodelle billiger werden, wird diese Schicht wertvoller, nicht weniger wertvoll, denn sie entscheidet, wohin das billige Modell kommt.
Wie eine Kette die Arbeit tatsächlich aufteilt
Abstraktes Gerede über Sub-Agenten wird klarer mit einer konkreten Aufgabe. Angenommen, Sie bitten einen Agenten, einen Markt zu recherchieren und ein Briefing zu erstellen. Das Flaggschiffmodell liest die Anfrage, entscheidet, wonach gesucht werden soll, und plant die Schritte. Ein kleines Modell erledigt dann die Fleißarbeit: Es besucht Seiten, extrahiert Zahlen, formatiert Tabellen um, dedupliziert Quellen und prüft, ob jede Aussage eine Quellenangabe hat. Das Flaggschiff kommt am Ende zurück, um die Synthese zu schreiben und zu entscheiden, ob der Entwurf gut genug ist. Ein teurer Aufruf an jedem Ende, viele billige Aufrufe in der Mitte.
Dieses Muster wiederholt sich über Aufgaben hinweg. Alles, was hohes Volumen und geringe Mehrdeutigkeit hat, ist ein Kandidat für das billige Modell: Formulare ausfüllen, Logs lesen, Support-Tickets klassifizieren, prüfen, ob ein Dokument zu einer Vorlage passt. Alles, was Urteilsvermögen darüber erfordert, was als Nächstes zu tun ist, bleibt beim Flaggschiff. Die Grenze ist nicht fest, und die interessante Ingenieursarbeit besteht derzeit darin, zu entscheiden, wo sie für jeden Workflow liegt.
Anthropics anpassbarer Reasoning-Aufwand passt hier gut. Eine Aufgabe, die nur einen leichten Eingriff braucht, kann mit niedrigem Aufwand laufen, und eine, die mehr Sorgfalt erfordert, kann hochgedreht werden, ohne das Modell zu wechseln. In der Praxis bedeutet das, dass dasselbe billige Modell sowohl eine schnelle Klassifizierung als auch eine sorgfältige Prüfung übernehmen kann, was die Zahl der beweglichen Teile verringert, die ein Team verwalten muss.
Was die Preissenkung bei Produkten ändert
Billigere Ausführung verändert, welche Produkte es wert sind, gebaut zu werden. Ein Feature, das bei jeder eingehenden Nachricht einen Agenten laufen lässt, ergab keinen Sinn, wenn jeder Lauf echtes Geld kostete. Es ergibt Sinn, wenn der Lauf einen Bruchteil eines Cents kostet. Das Ergebnis ist eine Welle von Features, die ein Jahr lang technisch möglich und bis jetzt wirtschaftlich unmöglich waren: Always-on-Monitore, Anreicherung pro Element, Hintergrund-Reviewer, die jedes Artefakt statt einer Stichprobe kontrollieren.
Darin steckt eine Falle, in die man leicht tappt. Wenn Ausführung billig ist, hören Teams auf, sie zu messen. Ein Workflow, der tausend billige Aufrufe pro Tag ausführt, wirkt pro Aufruf harmlos und kann trotzdem zu einer überraschenden Monatsrechnung führen, sobald Wiederholungen, Fehler und Eskalation zu einem teuren Modell eingerechnet werden. Die Zahl, auf die es ankommt, sind die Kosten einer abgeschlossenen Aufgabe, nicht die Kosten eines einzelnen Aufrufs.
Das Benchmark-Problem mit kleinen Modellen
Kleine Modelle werden bei Benchmarks besser, und Benchmarks sind genau der Ort, an dem Verbesserungen am leichtesten überinterpretiert werden. Ein Schlagzeilenwert in einem Test zum Bedienen eines Computers sagt, dass das Modell einer bekannten Abfolge von Oberflächenschritten folgen kann. Er sagt viel weniger darüber aus, ob das Modell weiß, wann es aufhören soll, wann es um Hilfe bitten sollte oder wann eine Aufgabe still und leise schiefgelaufen ist. Genau bei diesen Verhaltensweisen versagen billige Agenten in der Produktion, und sie sind schwer zu bewerten.
Die praktische Absicherung ist wenig glamourös. Geben Sie einem billigen Sub-Agenten eine eng umrissene Aufgabe, eine klare Definition von „erledigt“ und eine Möglichkeit zu eskalieren, statt zu raten. Beobachten Sie dann eine Woche lang, was er bei Randfällen tut, bevor Sie ihm etwas anvertrauen, das wichtig ist. Ein billiges Modell, das die Grenzen seiner Aufgabe kennt, ist nützlicher als ein kluges, das improvisiert.
Die ehrlichen Vorbehalte
Ein billiges Modell, das selbstsicher und falsch ist, ist schlimmer als ein teures, und Agentenketten vervielfachen dieses Risiko. Jeder zusätzliche Schritt ist ein Ort, an dem ein Fehler eindringen und sich ausbreiten kann. Der Preis pro Token sagt nichts darüber aus, ob das billige Modell eine mehrdeutige Anweisung so behandelt hat, wie ein Mensch es tun würde.
Außerdem gibt es eine Governance-Lücke, die nicht geschlossen wurde. Leitlinien von NIST und CISA Ende September behandeln Agenten als nicht-menschliche Identitäten mit geringem Vertrauen und fordern kurzlebige Anmeldedaten, gepflegte Inventare und menschliche Genehmigung für risikoreichere Aktionen. Die meisten Organisationen haben weder die Inventare noch die Genehmigungsprozesse. Billige Ausführung macht es einfacher, viele Agenten laufen zu lassen, und schwerer zu wissen, wie viele laufen.
Was das bedeutet, wenn Sie bauen
Die nützliche Gewohnheit, die es jetzt aufzubauen gilt, ist, nicht mehr standardmäßig zum größten Modell zu greifen. Zerlegen Sie eine Aufgabe in Planung und Ausführung, setzen Sie das Flaggschiff dort ein, wo Urteilsvermögen gefragt ist, und leiten Sie den Rest an ein kleines Modell weiter. Messen Sie die ganze Kette, nicht einen einzelnen Aufruf.
Haiku 5.5 ist nicht deshalb die Story, weil es billig ist. Es ist die Story, weil die billige Klasse endlich gut genug geworden ist, um die Teile eines Agenten zu übernehmen, für die früher das teure Modell nötig war.
Verwandte Artikel
Decagons PACT-Protokoll will Zustimmung zum Standard machen
Decagon hat ein Protokoll offengelegt, das die Identitat eines personlichen Agenten und die vom Kunden erteilten Berechtigungen pruft. Es ist unspektakulare Infrastruktur, und sie entscheidet, ob die Agentenwirtschaft funktioniert.
Die KI-Wiedervereinigungswelle: eine Debatte, die China noch nicht einordnen kann
KI-Hommagefilme brachten Verstorbene zuruck auf chinesische Bildschirme und sammelten Hunderttausende Likes. Dann kam der Widerspruch, und es ging um Zustimmung.
Apple veroffentlichte ein offenes multimodales Modell und sagte es kaum jemandem
Dieser forschungsorientierte Launch glitt an der Offentlichkeit vorbei, doch das feinkornige visuelle Grounding verrat, wohin Apples KI-Stack geht.
OpenCut und der Moment des Open-Source-CapCut
Ein kostenloser Videoeditor unter MIT-Lizenz klettert weiter in den GitHub-Trends, und seine Roadmap enthalt einen MCP-Server fur KI-Agenten. Die Werkzeuge um KI-Medien holen die Modelle ein.