
LTX 2.5 يريد تصيير مسودتك المتكتلة من Blender إلى لقطة نهائية
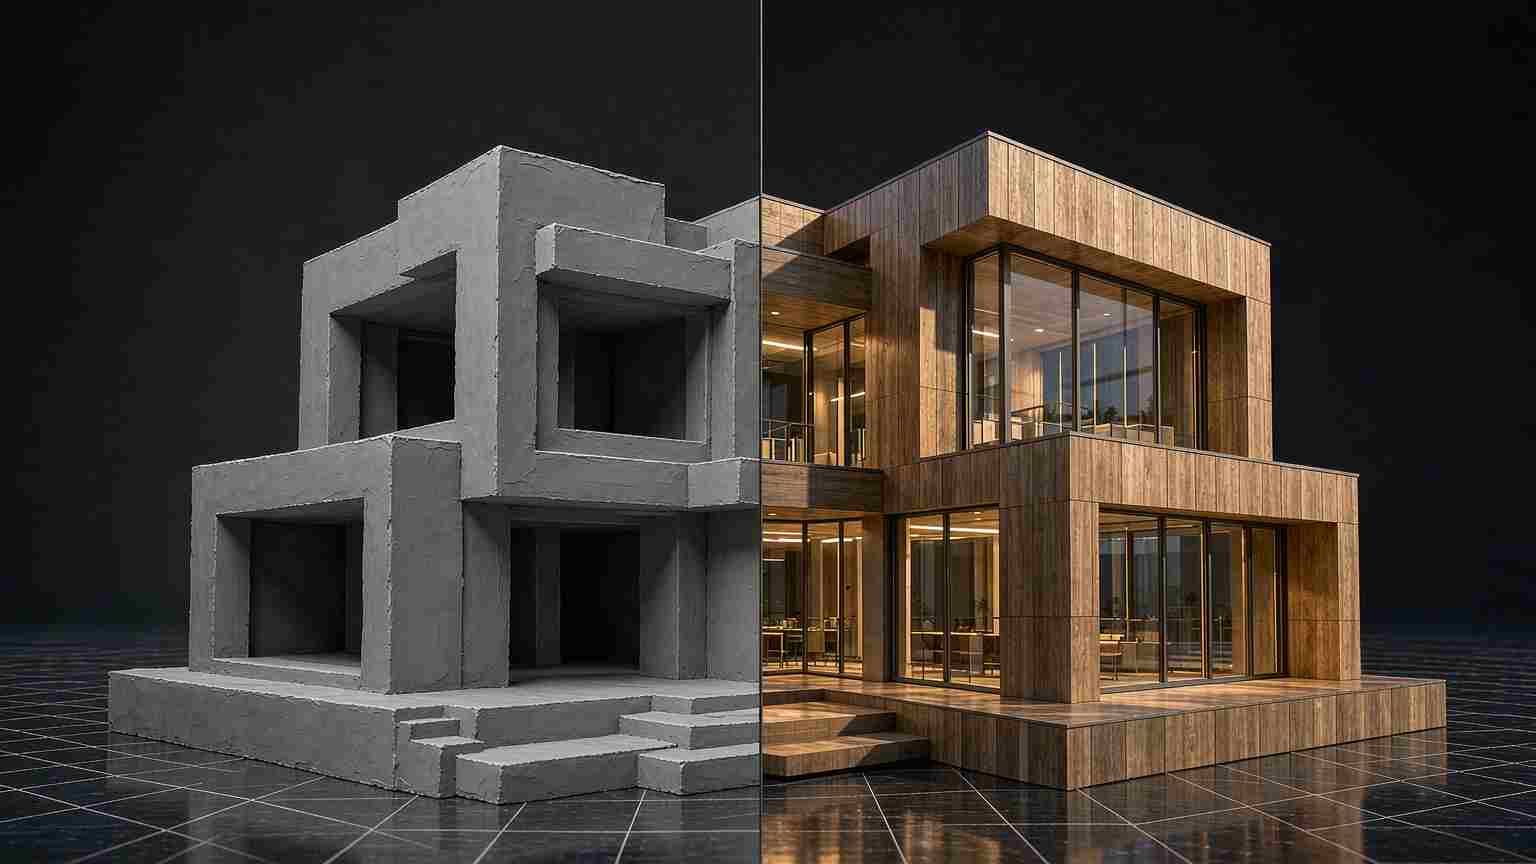
أصدرت Lightricks مهايئًا جديدًا لنموذج الفيديو LTX 2.5 الخاص بها يستهدف مشكلة محددة جدًا ومألوفة جدًا: الفجوة بين رسوم متحركة ثلاثية الأبعاد خشنة وشيء يمكنك فعلاً أن تعرضه على أحد.
الأداة هي ما تسميه Layout-to-Render، وتُقدَّم على هيئة IC-LoRA يعمل على نموذج LTX 2.5 الأساسي. تُغذّيها برسوم متحركة طينية في نافذة العرض أو بمعاينة playblast منخفضة الجودة، من ذلك النوع الرمادي المتكتل الذي يخرج من Blender أو Unreal، فتُصيّر اللقطة نفسها كمقطع فيديو نهائي، مُضاء ومكسو بالخامات. وهي تحافظ على حركة الكاميرا والتأطير ومكان الأجسام، وتستمد توجهها الفني من صورة مرجعية.
لماذا هذه أداة من نوع مختلف
يكاد كل مولّد فيديو في السوق يعمل بالطريقة نفسها. تصف ما تريد، فيقرر النموذج كل شيء: إلى أين تتحرك الكاميرا، وماذا يفعل الموضوع، وكيف يبدو المشهد. هذا لا بأس به لمقطع عابر. لكنه غير مناسب للإنتاج، حيث بيت القصيد هو أنك قررت التأطير عن قصد.
يقلب Layout-to-Render تقسيم العمل. التخطيط يتحكم في الحركة والتكوين، لأنك سبق أن حددت تكوينه الأولي في ثلاثي الأبعاد. أما النموذج التوليدي فيتولى المظهر فقط. هذا الفصل هو ما يجعل تكرار اللقطة متوقعًا، لأن تغيير المظهر لا يبعثر الإخراج الحركي، وضبط الكاميرا لا يتطلب إعادة توليد المقطع كاملًا والأمل في أن ينجح.
بالنسبة لأي شخص أمضى بعد الظهر في توليد مقاطع من النص إلى الفيديو ويرمي تلك التي انحرفت فيها الكاميرا بضع درجات، فإن هذا يعالج الشكوى الحقيقية. نمط فشل التوليد من النص إلى الفيديو ليس أن الصور قبيحة، بل أنك لا تتحكم في ما يحدث. المخرج الذي يريد دفعًا بطيئًا إلى الداخل لا يريد إعادة التوليد حتى يوافق النموذج. يريد أن يحدد حركة الدفع إلى الداخل ويمضي قدمًا.
خط الإنتاج الذي يندمج فيه
صُمم المهايئ ليلائم سير العمل ثلاثي الأبعاد القائم بدل أن يستبدله. وهو يدعم Blender وUnreal والأدوات المشابهة، ويعمل عبر ComfyUI المحلي ومسارات Python. الفكرة أن يقوم رسام التحريك بتخطيط اللقطة كما اعتاد دائمًا، ويصيّر معاينة رخيصة، ثم ينفق قدرة الحوسبة التوليدية على المظهر النهائي بدل إنفاقها على التخمين.
هذا تحول ذو معنى في الغرض من هذه النماذج. الموجة الأولى من توليد الفيديو تنافست على الإبهار، على مقاطع تبدو مبهرة في عزلة. أما الموجة الثانية، إن كان هذا مؤشرًا عليها، فتتنافس على الملاءمة: مدى سلاسة انغماس النموذج في خط إنتاج يستخدمه المحترف بالفعل، ومدى ضآلة ما يحتاج المحترف إلى تغييره في عمله ليستفيد منه.
هناك سبب يجعل هذا أهم مما يبدو. لا تتبنى الاستوديوهات أدوات تتطلب إعادة بناء عملية العمل لديها. بل تتبنى أدوات تُوصَل بالعملية التي تملكها بالفعل. النموذج الذي يتحدث لغة معاينات نافذة العرض وتخطيط اللقطات يلتقي برسامي التحريك حيث هم، وهذا طرح مختلف جدًا عن نموذج يطلب منهم وصف مشهد في فقرة.
التكاليف الصادقة
هناك أمران يخففان الوعد. الأول هو العتاد. نموذج LTX 2.5 ذو 22 مليار معامل ومكوّناته المطلوبة يرفعان كلفة الإعداد ومتطلبات VRAM، ما يجعله خارج متناول المستخدمين العاديين ويدفعه نحو من يملكون بالفعل تجهيزًا بوحدة GPU لأعمال ثلاثية الأبعاد.
الثاني أن المخرجات توليدية، لا دقيقة. لا يحافظ النموذج على الهندسة على مستوى البكسل، لذا لا يزال على الفنانين مراجعة النتيجة من حيث الاستمرارية والمحاذاة وأي شيء انزلق بين الإطارات. لا يُنقل الصوت المصدر، وقد تُقلَّص أعداد الإطارات لتلائم الصيغة المدعومة في خط الإنتاج. هذه أداة إنهاء، وليست بديلًا عن المُصيّر، والتعامل معها كبديل سيؤدي إلى خيبة أمل.
تشير الكلفتان إلى الحقيقة العملية نفسها: هذا برنامج لمن يملكون خط إنتاج بالفعل، وقيمته تظهر في الساعات الموفرة، لا في القدرة على فعل شيء مستحيل. إن كنت لا تخطط اللقطات في ثلاثي الأبعاد أصلًا، فالأداة لا تقدم الكثير. وإن كنت تفعل، فتتغير الحسبة سريعًا.
ماذا يعني ذلك لسباق الفيديو المفتوح
LTX 2.5 نفسه مفتوح الأوزان، والقصة الأوسع في الأشهر القليلة الماضية كانت تحسّن نماذج الفيديو المفتوحة بشكل حقيقي. أدوات مثل هذا المهايئ هي كيف تتحول هذه الانفتاحية إلى تبنٍّ. النموذج القوي بلا سير عمل حوله مجرد عرض تجريبي. أما النموذج القوي مع مسار Layout-to-Render وعُقد ComfyUI وتكامل Blender فهو شيء يمكن للاستوديو أن يستخدمه فعلاً.
هناك أيضًا نقطة أهدأ حول إلى أين يتجه التمايز. عندما تستطيع عدة نماذج إنتاج مقطع جميل مدته خمس ثوانٍ من وصف نصي، تنتقل المنافسة إلى التحكم. أي نموذج يتيح لك تحديد ما تريد بالضبط، والحفاظ عليه عبر تسلسل، وتغيير شيء واحد دون إفساد الباقي. Layout-to-Render هو جواب Lightricks على ذلك السؤال بسير عمل يضع ثلاثي الأبعاد أولًا، مع رهان على أن أكثر الناس اهتمامًا بالتحكم هم من يفكرون أصلًا باللقطات.
ما الذي لا يستبدله
يجدر التوضيح بشأن الحدود. لا يلغي Layout-to-Render الحاجة إلى العمل ثلاثي الأبعاد. لا يزال على أحدهم تخطيط اللقطة وضبط الكاميرا وإعداد المشهد. ما يلغيه هو مرحلة التصيير النهائي المكلفة، والتخمين في محاولة وصف لقطة محددة بالكلمات. هذا التقسيم يناسب الطريقة التي يوظف بها الاستوديو مشاريعه بالفعل: فريق صغير يتولى التخطيط، وتذهب ميزانية التصيير إلى تطوير المظهر بدلًا من تكرار حركات الكاميرا. الأداة تغيّر أين يقع الجهد، لا مقدار الخيال الذي يحتاجه المشروع.
الصورة الأكبر لذلك
يستحق المسار هنا أن يُسمّى. بدأ توليد الفيديو كطريقة لصنع مقاطع لم تكن موجودة. وهو يتحول إلى طريقة لجعل المقاطع التي خططت لها بالفعل أقل كلفة في الإنهاء. هذان منتجان مختلفان، موجهان إلى مشترين مختلفين، ويكافئان نوعين مختلفين من الجودة.
النوع الأول يكافئ الواقعية والمفاجأة. والثاني يكافئ الوفاء بخطة والقابلية للتنبؤ عبر لقطات كثيرة. مهايئ LTX 2.5 موجّه بوضوح إلى الثاني، ومن الرهان المعقول أن المال في إنتاج الفيديو الاحترافي يقع هناك. لا يحتاج الاستوديو إلى نموذج يبتكر لقطة. بل يحتاج إلى نموذج يستطيع تصيير اللقطة التي رسمها بالفعل، مرارًا وتكرارًا، دون انحراف.
سواء قدّم Layout-to-Render ذلك بجودة إنتاجية أم لا، فالفنانون سيقررون ذلك باستخدامه. لكن الاتجاه صحيح بالنسبة للأشخاص الذين يدفعون ثمن هذا البرنامج، وهذا وحده يجعله أكثر من مجرد مولّد مقاطع آخر باسم جديد.
مقالات ذات صلة
Agility Digit 5 يأتي مع ملف سلامة، لا مجرد ورقة مواصفات
أرضية المستودع ليست مختبرًا. الاعتماد هو البوابة، وليس العرض التوضيحي.
أنهى الوكلاء المتقدمون 30 بالمئة من مسار عمل بحثي. هذا هو الرقم.
يستطيع الوكلاء تشغيل البحث. لكن اختراع الإجراء لا يزال بعيد المنال.
Figure AI تحجز 3.5 مليار دولار من القدرة الحاسوبية قبل أن يكون لديها منتج للبيع
الرهان هو أن التعميم مشكلة حوسبة. والمجال لم يحسم ذلك بعد.
أخيرًا، أضافت OpenAI خلفيات شفافة إلى واجهة برمجة تطبيقات الصور
ميزة صغيرة تحذف خطوة كاملة من خط المعالجة.