
蚂蚁集团的 Ming-Image:以图层设计,而非平面图片
大多数图像模型评判的是单张图片看起来有多好。蚂蚁集团于 9 月 22 日发布了两款模型,它们邀请人们换一种测试方式:你拿到的东西在你看完之后,是否仍然可以被编辑。
蚂蚁旗下的 inclusionAI 实验室在 Hugging Face 上发布了 Ming-Image-0.1-Design 和 Ming-Image-0.1-Design-Layer,两者均为 60 亿参数,采用 MIT 许可证。该许可证在这里比往常更重要,因为它允许公司无需事先协商即可将输出用于商业用途。这对模型面向的是设计工作,而非摄影。界面屏幕、信息图、海报,以及文字必须真正可读的那种版式。
小字号文字正是开放图像模型通常崩掉的地方。Ming-Image-0.1-Design 生成完整构图,包括文字,并且可以写出 RGBA 文件,因此背景输出为透明,而不是一个纯白矩形。模型卡建议使用 2048 × 2048,若想更快则用 1024 × 1024,采样步数为 12,CFG 比例为 1.0。对扩散模型来说,12 步算低。权重加载完成后,输出很快。它运行在标准 diffusers 库上,并支持 vLLM-Omni 用于服务部署。
第二个模型才是有趣的那个。Ming-Image-0.1-Design-Layer 接收一个已完成、已扁平化的设计,并按照你交给它的图层计划——说明你想要多少个部分——将其重新拆分为透明图层。你最终得到的东西,比一张单一扁平 PNG 更接近可工作的设计文件。
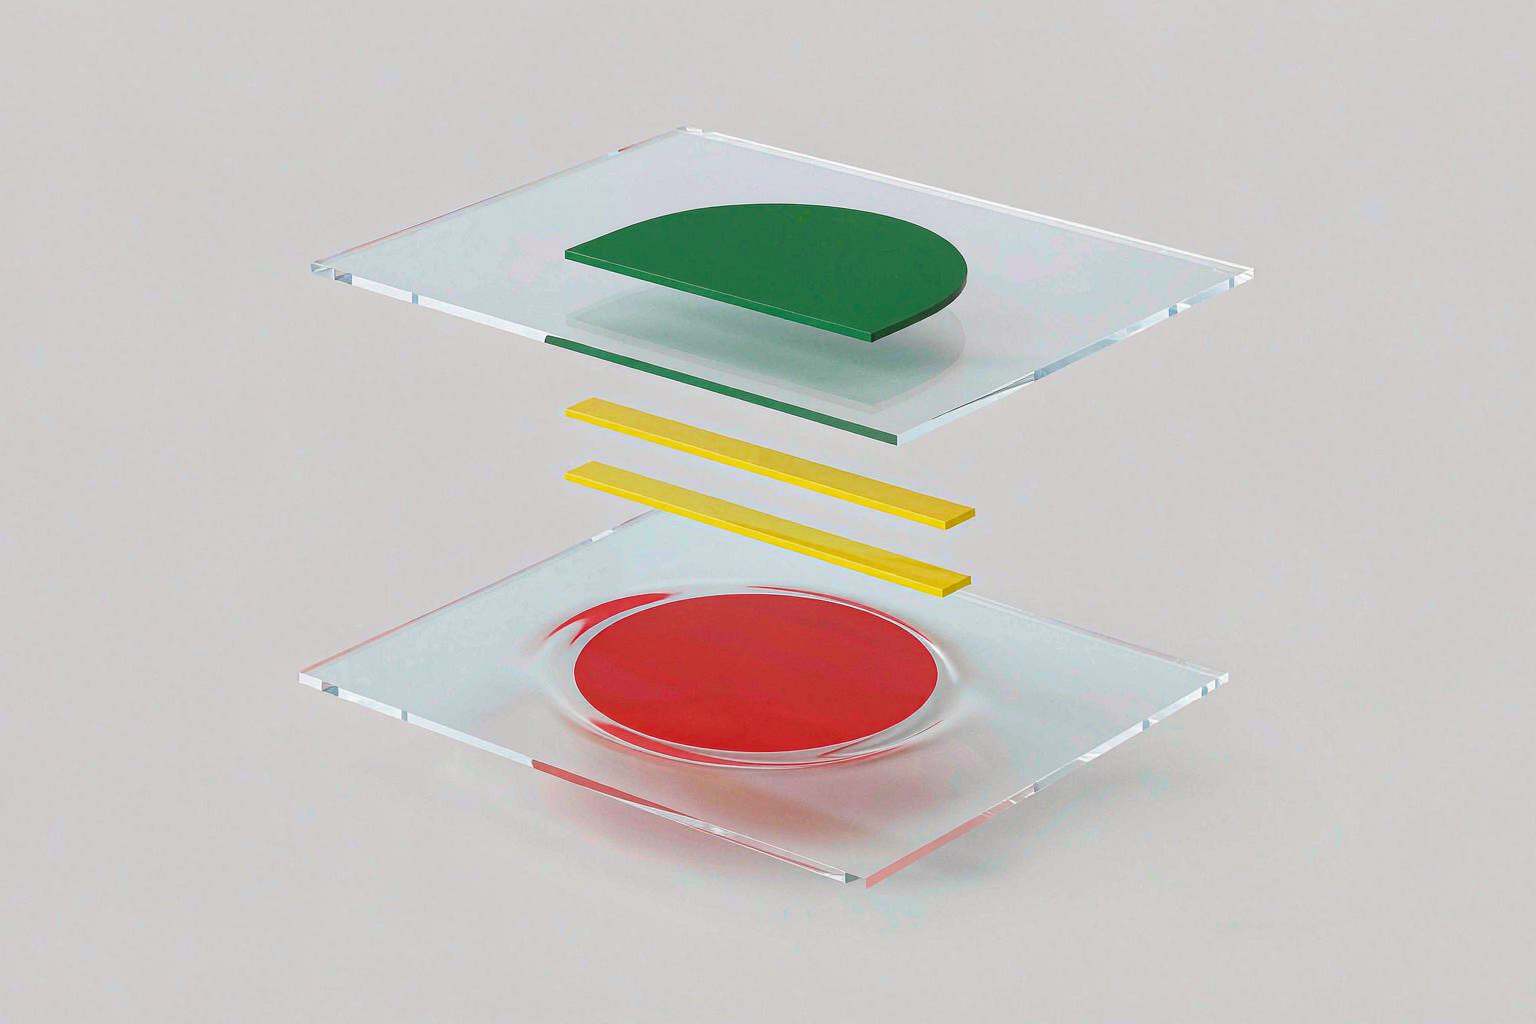
这一差距正是大多数图像模型止步于真正设计工作的原因。如果客户想要移动标题并替换标志,一张扁平 PNG 会迫使你完全重新生成,画布上的其他一切也随之改变。图层让你只改那一个东西。蚂蚁在 Crello 测试集上对此进行评估,衡量每个恢复图层在颜色和形状上的接近程度。
蚂蚁没有公布的数字
没有任何你可以引用的数字。模型卡指向 Artificial Analysis UI/UX Design 排行榜和 Crello 结果,但两者都只以图表图像形式出现。正文中没有数字,也没有点名竞争对手。你无法从发布信息中判断 Ming-Image-0.1-Design 与 Qwen-Image、Seedream 或任何商业模型相比如何,而且如果不自己重新运行评估,这些说法也都无法核实。
硬件指南也存在缺口。蚂蚁在单块拥有 80 GiB 显存的 CUDA GPU 上验证了 6B 模型,这比参数规模所暗示的余量要大得多。模型卡没有为 24 GB 消费级显卡提供指导,尽管专为这些显卡打造的社区量化版本在数小时内就上线了。INT4、INT8、FP8、GGUF 和 ComfyUI 构建都在同一天出现。
最后一个细节值得细想。一个模型实验室公布了 80 GiB 的要求,而社区的回应是让模型在只有其三分之一大小的显卡上运行。官方数字描述的是蚂蚁测试了什么,而不是模型需要什么。任何考虑采用的团队都应把经过验证的配置当作起点,并检查量化构建在自己硬件上的实际表现。
为什么图层会改变工作流
设计工作不是一连串完成图像,而是一连串修改。客户看到草稿,要求标题更大、背景更冷,然后又决定标志应该放在另一边。这些请求每一个都很小。但在扁平图像上,每一个也很昂贵,因为更改一个元素意味着重新生成一个在其他所有方面都已获批的构图。
图层化输出扭转了这一点。一旦设计以独立部件的形式存在,一次修改只会触及它相关的那一块,其余部分保持不变。对于按小时计费的机构,这种差异体现在利润率上。对于独立设计师,它体现在工具是否比手工操作更快。
图层的另一个回报场景是交接。一张扁平 PNG 是死路。下游任何需要调整它的人都得从头开始。分层文件可以进入设计团队已经在使用的工具中,这正是 AI 工具“位于工作流旁边”与“加入工作流”之间的区别。
它所属的编辑竞赛
蚂蚁并非在空白市场中发布。在整个图像市场,编辑已成为模型拉开差距的地方。GPT Image 2.5 Sunburst 位居编辑排行榜榜首,其同门 Flare 紧随其后。Nano Banana Pro 仍然是无须微调即可锁定身份的便捷途径,并且最多可融合十四张图像和五个人。Seedream 5.0 将编辑与实时网络搜索配对,这在编辑需要真实参考时很有帮助。在开放阵营,FLUX.1 Kontext 处理由你自己运行的保持布局的编辑,而 Qwen-Image-Edit 在开放权重编辑排名中领先。
面对这样的竞争格局,Ming-Image 做的是一个狭窄的押注。它并不试图赢得通用编辑领域。它押注的是:文字密集型设计是一个足够大的细分市场,能够支撑一个专用模型;而图层分解是通用模型不会费心去构建的功能,因为它不会出现在演示短片中。
这个押注背后有历史。开放图像模型花了两年时间追逐照片级真实感,开放权重与闭源权重之间的质量差距已经缩小了很多。尚未缩小的是“产出图片的模型”与“产出资产的模型”之间的差距。图片在看起来正确时就完成了。资产在可以交给别人并修改时才完成。Ming-Image 瞄准的是第二类,这更难在发布帖中展示,但更适合在周二下午真正派上用场。
它实际上适合谁
如果你批量产出设计资产,并且其中的文字必须清晰可读,那么现在就值得测试。一个制作社交卡片、广告变体和内部演示文稿的小型营销团队是最明确的适用对象,而 MIT 许可证的条款不会在你与商业使用之间设置任何障碍。
我会从分层模型开始,因为分层输出几乎可以肯定是你现有图像工具做不到的事情。这里的其他一切——一个能渲染可读文字的文本到图像模型——都有竞争。而拿一个已完成的扁平设计并交回可编辑文件的能力则没有。
第一个值得运行的测试,是非英语语言中小字号文字的渲染。这正是这一类模型通常失败的地方,而发布信息对此只字未提。多语言字体排印是大多数真实设计工作背后的隐藏需求,一个只擅长处理拉丁字母的模型是有天花板的模型。
如果你的输出是摄影性的而非字体排印性的,那么这一切都不适用。Ming-Image 并不试图与那些渲染俊美人物和美丽风景的模型竞争。它瞄准的是设计中不那么光鲜的那一半:海报需要标题在正确位置,产品卡需要人类能读清的价格。这一半已经等待了许久,盼着一个认真对待它的模型。