
Ming-Image di Ant Group progetta a livelli, non come immagini piatte
La maggior parte dei modelli di immagini viene giudicata in base a quanto bella appare una singola immagine. Ant Group ha rilasciato due modelli il 22 settembre che invitano a un test diverso: se ciò che ottieni può ancora essere modificato quando hai finito di guardarlo.
Il laboratorio inclusionAI di Ant ha pubblicato Ming-Image-0.1-Design e Ming-Image-0.1-Design-Layer su Hugging Face, entrambi da sei miliardi di parametri con licenza MIT. Qui quella licenza conta più del solito, perché consente a un'azienda di usare l'output commercialmente senza dover prima negoziare nulla. La coppia è pensata per il lavoro di design più che per la fotografia. Schermate di interfaccia, infografiche, poster e quel tipo di impaginazione in cui le parole devono davvero essere leggibili.
I caratteri piccoli sono il punto in cui i modelli di immagini open di solito crollano. Ming-Image-0.1-Design genera l'intera composizione, testo incluso, e può scrivere file RGBA, così lo sfondo risulta trasparente invece che un rettangolo bianco piatto. La model card suggerisce 2048 per 2048, oppure 1024 per 1024 se lo si vuole più veloce, con 12 passi di campionamento e una scala CFG di 1.0. Dodici passi sono pochi per un modello di diffusione. Una volta caricati i pesi, l'output arriva rapidamente. Funziona con la libreria standard diffusers e supporta vLLM-Omni per il serving.
Il secondo modello è quello interessante. Ming-Image-0.1-Design-Layer prende un design finito e appiattito e lo suddivide di nuovo in livelli trasparenti, seguendo un piano di livelli che gli fornisci e che indica quante parti vuoi. Quello che ottieni è più vicino a un file di design di lavoro che a un singolo PNG piatto.
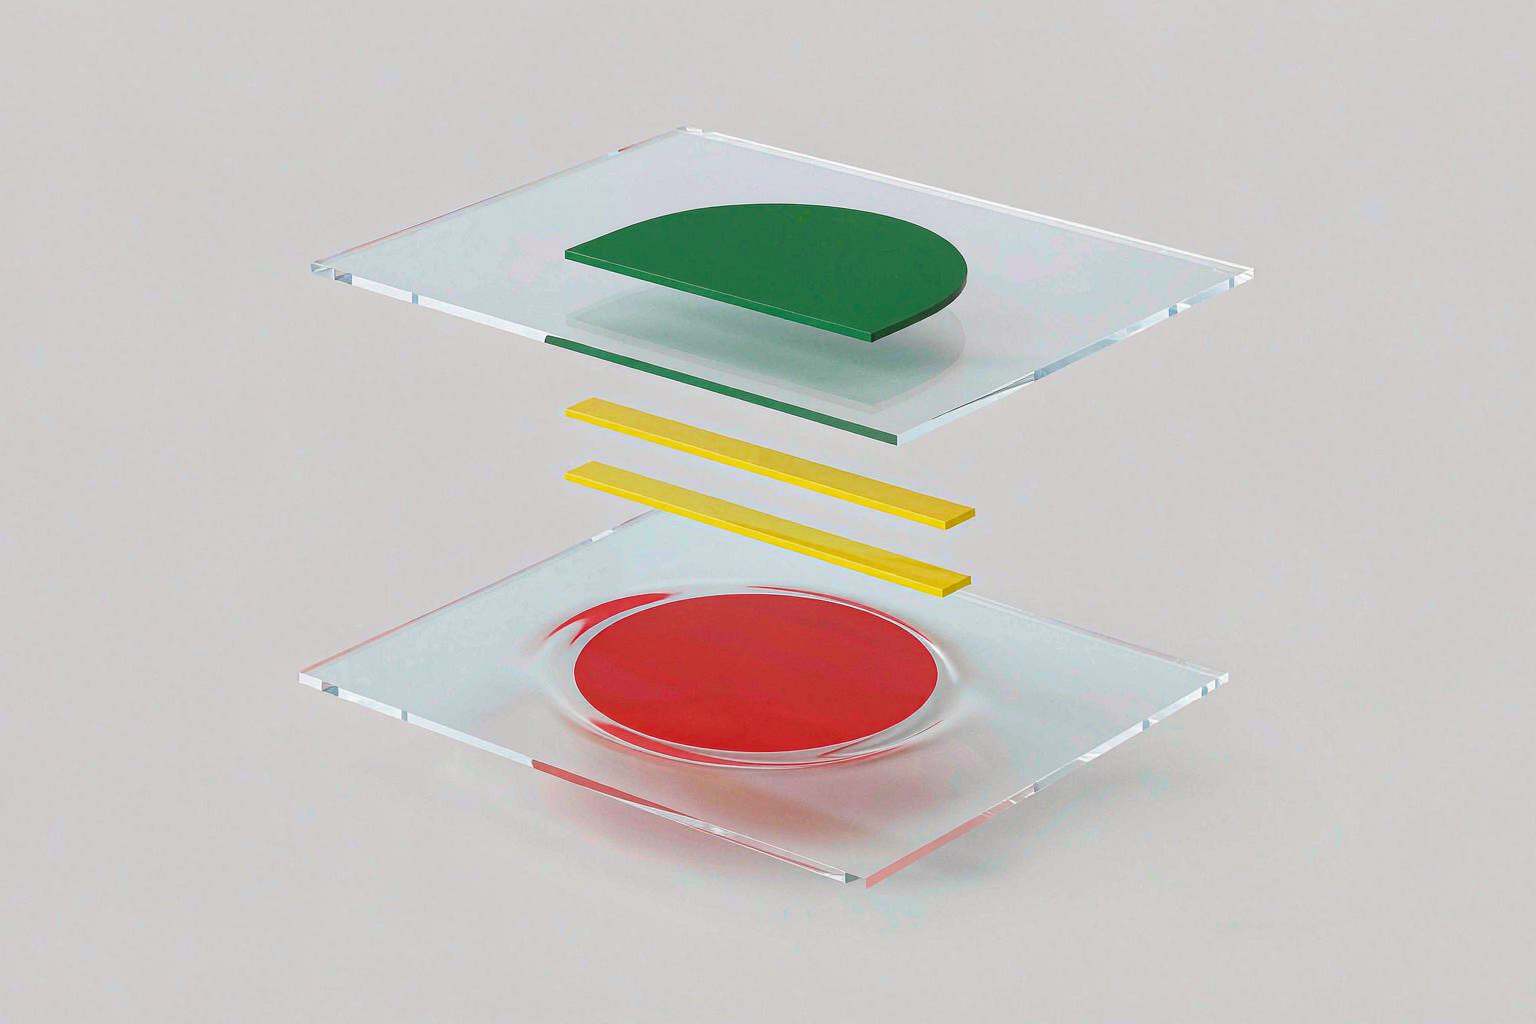
Questo divario è il motivo per cui la maggior parte dei modelli di immagini si ferma prima del vero lavoro di design. Se un cliente vuole che il titolo venga spostato e il logo scambiato, un PNG piatto obbliga a una rigenerazione completa, e tutto il resto sulla tela segue. I livelli ti permettono di cambiare solo quella cosa. Ant valuta questo sul set di test Crello, misurando quanto ogni livello recuperato sia vicino per colore e forma.
I numeri che Ant non ha pubblicato
Non c'è alcun dato che si possa citare. La model card rimanda alla classifica UI/UX Design di Artificial Analysis e ai risultati Crello, ma entrambi compaiono solo come immagini di grafici. Nessun numero nel testo, nessun concorrente nominato. Dal rilascio non si può capire come Ming-Image-0.1-Design si confronti con Qwen-Image, Seedream o qualsiasi modello commerciale, e nessuna delle due affermazioni può essere verificata senza rieseguire personalmente la valutazione.
Anche le indicazioni hardware presentano una lacuna. Ant ha convalidato il modello 6B su una singola GPU CUDA con 80 GiB di VRAM, un margine molto superiore a quanto suggerisca il numero di parametri. La card non fornisce indicazioni per schede consumer da 24 GB, anche se le quantizzazioni della community create esattamente per quelle schede erano disponibili nel giro di poche ore. Le build INT4, INT8, FP8, GGUF e ComfyUI sono apparse tutte lo stesso giorno.
Vale la pena soffermarsi su quest'ultimo dettaglio. Un laboratorio di modelli pubblica un requisito di 80 GiB, e la community risponde facendo girare il modello su una scheda grande un terzo. Il numero ufficiale descrive ciò che Ant ha testato, non ciò di cui il modello ha bisogno. Qualsiasi team che valuti l'adozione dovrebbe considerare la configurazione convalidata come punto di partenza e verificare cosa fanno realmente le build quantizzate sul proprio hardware.
Perché i livelli cambiano il flusso di lavoro
Il lavoro di design non è una sequenza di immagini finite. È una sequenza di revisioni. Un cliente vede una bozza, chiede che il titolo sia più grande e lo sfondo più freddo, poi decide che il logo dovrebbe stare dall'altra parte. Ognuna di queste richieste è piccola. Su un'immagine piatta, ognuna è anche costosa, perché cambiare un elemento significa rigenerare una composizione già approvata in tutto il resto.
L'output a livelli ribalta la situazione. Una volta che il design esiste come pezzi separati, una revisione tocca il pezzo a cui si riferisce e lascia stare il resto. Per un'agenzia che fattura a ore, la differenza si vede nei margini. Per un designer freelance, si vede nel fatto che lo strumento sia più veloce del farlo a mano.
L'altro ambito in cui i livelli ripagano è il passaggio di consegne. Un PNG appiattito è un vicolo cieco. Chiunque a valle debba modificarlo riparte da zero. Un file a livelli può passare negli strumenti che un team di design già usa, ed è la differenza tra uno strumento AI che sta accanto a un flusso di lavoro e uno che vi si unisce.
La corsa all'editing a cui appartiene
Ant non sta arrivando in uno spazio vuoto. In tutto il mercato delle immagini, l'editing è diventato il terreno su cui i modelli si distinguono. GPT Image 2.5 Sunburst è in cima alle classifiche di editing, con la sua controparte Flare subito dietro. Nano Banana Pro resta la via facile al blocco dell'identità senza fine-tuning, e combina fino a quattordici immagini e cinque persone. Seedream 5.0 abbina l'editing alla ricerca web in tempo reale, il che aiuta quando una modifica richiede un riferimento reale. Sul versante open, FLUX.1 Kontext gestisce modifiche che preservano il layout e che esegui tu stesso, e Qwen-Image-Edit guida la classifica di editing open-weight.
Rispetto a questo panorama, Ming-Image fa una scommessa ristretta. Non cerca di vincere l'arena generale dell'editing. Scommette che il design ricco di testo sia una fetta di mercato abbastanza grande da sostenere un modello specializzato, e che la scomposizione in livelli sia una funzionalità che i modelli generali non si preoccuperanno di costruire perché non si vede in un video dimostrativo.
Questa scommessa ha una storia alle spalle. I modelli di immagini open hanno passato due anni a inseguire il fotorealismo, e il divario di qualità tra pesi aperti e chiusi si è ridotto molto. Ciò che non si è colmato è il divario tra un modello che produce un'immagine e un modello che produce un asset. Un'immagine è finita quando appare giusta. Un asset è finito quando può essere passato a qualcun altro e modificato. Ming-Image punta alla seconda categoria, una cosa più difficile da dimostrare in un post di lancio e più utile da avere di martedì pomeriggio.
A chi è davvero destinato
Se produci asset di design in volume e il testo al loro interno deve essere leggibile, vale la pena testarlo ora. Un piccolo team di marketing che sforna card social, varianti di annunci e presentazioni interne è il caso d'uso più chiaro, e la licenza MIT non mette nulla nei termini tra te e l'uso commerciale.
Il modello a livelli è da dove inizierei, perché l'output a livelli è la cosa che il tuo strumento di immagini esistente quasi certamente non sa fare. Tutto il resto qui, un modello text-to-image che rende caratteri leggibili, ha concorrenza. La capacità di prendere un design piatto finito e restituire un file modificabile, invece, non ne ha.
Il primo test da eseguire è il rendering del testo a piccole dimensioni in una lingua diversa dall'inglese. È qui che i modelli di questa classe di solito falliscono, e il rilascio non ne dice nulla. La tipografia multilingue è il requisito nascosto dietro la maggior parte del vero lavoro di design, e un modello che gestisce bene solo l'alfabeto latino è un modello con un tetto.
Se il tuo output è fotografico anziché tipografico, nulla di tutto ciò si applica. Ming-Image non cerca di competere con i modelli che rendono persone e paesaggi bellissimi. Mira alla metà poco glamour del design, la parte in cui un poster ha bisogno di un titolo nel posto giusto e una scheda prodotto ha bisogno di un prezzo che un essere umano possa leggere. Quella metà aspetta da un po' un modello che la prenda sul serio.
Articoli correlati
Gli strumenti video AI ottengono 9 su 10 per facilità d'uso. Il punteggio di conformità è un'altra storia.
Gli utenti adorano i generatori video AI. I reparti legali non sono ancora stati interpellati.
InternLumina-U2 riunisce testo, immagini, video e 3D in un unico modello da 16B, poi distribuisce due set di pesi
L'elenco delle attività è ambizioso. Il formato di rilascio porta più segnali.
HappyOyster vende un mondo in cui puoi entrare, non una clip da guardare
La maggior parte dei modelli video ti consegna un file. Questo ti consegna una stanza con dentro una porta.
Luma Ray3 Modify mantiene la performance e rinegozia il mondo che la circonda
Il problema più difficile nell'editing video con AI non è l'effetto. È non rovinare la ripresa che hai già pagato.