
动漫模型学会了读火柴人,0.37 到 0.83 这段差距才是重点
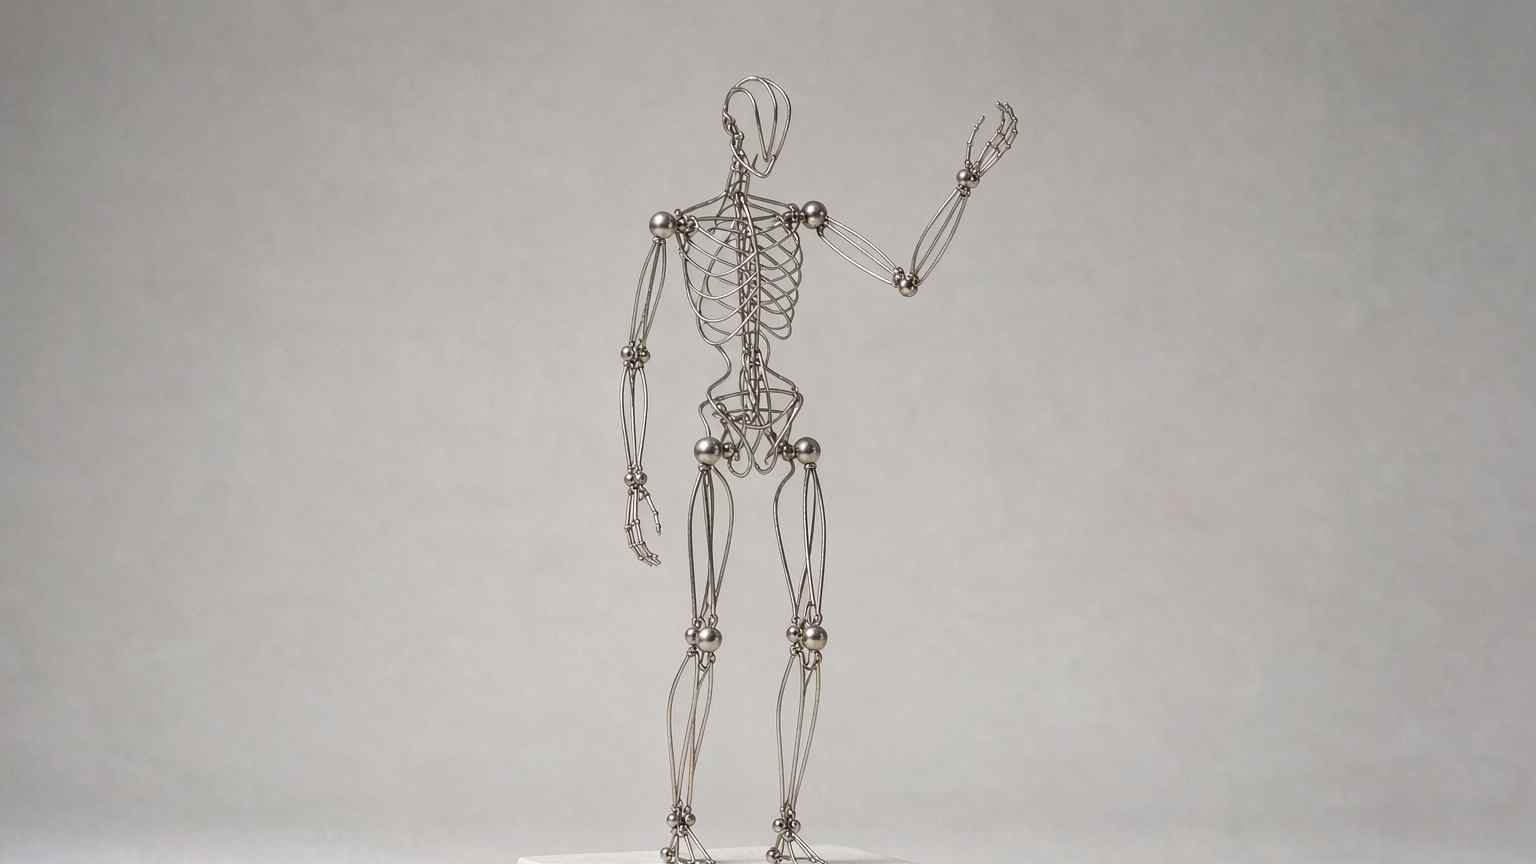
11 月 2 日,一个叫 Anima-Control-Pose 的仓库上线了,里面是给一个动漫图像模型用的姿势引导,目前还是一个预览版。用法很直接:你给这个模型一张参考照片,它自带的检测器会在照片里的人身上画出一套骨架,然后角色就照着这套骨架摆出姿势。
发布说明写得简短克制,而且难得地把不管用的地方讲得很具体。奔跑、跳跃和坐下的姿势是最不靠谱的。手到现在还是会糊在一起,分不出指头。检测器是照着照片训练出来的,所以它读动漫图读得很吃力。
最后这一句,才是真正说明作者用过这个工具的那句话。
姿势控制是干什么用的,动漫为什么需要自己的一套
姿势条件控制在通用图像生成里,已经算是解决了的问题。骨架叠加、深度图、边缘图这几种控制输入成为标准做法,到现在已经有两年多,而通用模型面对一张人物照片,还原度也还算说得过去,不至于明显走形。
动漫是另一个问题。它的比例是风格化的:头大,四肢细,手画出来是五根干净的线,而不是拍下来的那种几何形状。一个拿照片训练出来的检测器,看一格漫画的时候,画出的骨架在躯干上大致是对的,其他地方基本全错,因为它依赖的那些线索,比如关节处的鼓起、皮肤上的明暗过渡,在动漫图里根本不存在。
所以一条动漫的生成流程,需要同时具备两样东西:一个是模型能够跟得住的控制信号,另一个是把这个信号从画师手头实际有的东西里推导出来的办法,而画师手头通常只有一张草稿、一张参考照片,或者一个粗略的人形。
Anima-Control-Pose 走的是间接的那条路:照片进去,骨架出来,角色跟着走。一个插画师手上有张姿势参考照片的时候,真正想要的就是这套流程,这个工具存在的理由也在这里。
这个数字,以及它到底量的是什么
作者在说明里给出的说法是,在 1024 像素下,姿势准确率从没装这个附加组件时的 0.37 左右,提升到装上之后的 0.83 左右。在 512 和 768 下,提升的幅度要小一些。
这个数字有三件事,值得分开来看。
第一,它是作者自己的指标,跑在作者自己的评测集上。没有第三方来复核,没有标准的基准测试,也没有说清什么样的姿势才算准确,评测协议是缺的。这个数字可以当作一个方向来看,也可以当作证据,说明这个附加组件确实做了一件不小的事。但它没办法和公开发表的基准数字放在一起比。
第二,对分辨率的依赖在机制上是讲得通的。角色占据的像素变少的时候,骨架提取和姿势贴合这两步都会退化,而 512 像素的动漫生成一直是控制层最难处理的场景。提升在那里缩水,这是一个限制,不该被当成脚注带过。
第三,0.37 到 0.83 之间那段差距,才是更有意思的一半。一个在姿势贴合上只有 0.37 的模型并不是不能用,它给出的是一个大致姿态对、四肢在旁边做点相近动作的角色,画师就靠反复重摇来对付它。到了 0.83,重摇就变成了导演,而一个镜头要花多少次生成,这个成本也跟着变了。
它还有三件事做不到
这三条都写在模型卡上,值得照字面当真。
奔跑、跳跃和坐下是最不靠谱的。值得想想为什么。这些姿势都涉及自我遮挡、透视压缩,还有和一块看不见的表面的接触。骨架编码进去的是关节位置,而关节位置恰好是在身体折叠起来的时候最不提供信息。一个坐着的角色,胯部的角度在火柴人身上根本看不见,骨架里没有这个信息。
手会糊在一起。手是生成图像里最老的毛病,而修它的从来不是姿势条件控制。检测器只能以很低的置信度给出腕部和手指的关键点,模型画出一个手的示意,画师再把它重画一遍。生产环境里每一条动漫流程都有一步修手。这个工具并没有把这一步去掉。
检测器会读错动漫图。这一条是结构性的问题。这个工具看照片很准,因为它就是在照片上训练的。如果你的参考是一格漫画、一张草稿,或者另一张 AI 生成的图,它画出来的骨架可能看着合理,其实是错的,而一个错的骨架会产出一个自信地错着的角色。
第三条限制划定了这个工具的范围。它在流程里站在最前面,负责把现实世界的参考转成控制信号,而不是两张动漫图之间的桥。
0.37 这个基线,其实也是关于底模的一句评语,值得这么读。没有这个附加组件的时候,一个被要求跟着骨架走的动漫模型,大概只能把姿势做对三分之一。插画师为了绕开这一点所做的一切,从过一遍 img2img 到一条胳膊一条胳膊地修补,都是从那个数字来的。把它提到 0.83 减少的是工作量,并没有省掉检查结果这一步。
交付了什么,用起来要付什么代价
这个包本身不大:两个 ComfyUI 节点文件夹,四个示例工作流,入口文件是 pose_control_demo.json,还有一个 316MB 左右的检测器。
把 ComfyUI 当作分发渠道,现在已经是常态,而它有一个副作用值得留意。一个工作流 JSON 文件同时是文档、教程,也是可复现性的凭证。只要你能加载这个文件,作者用过的每一个参数你都看得见,这种程度的公开,是大多数模型发布从来不提供的东西。它同时也意味着这个工具的行为可以在你的机器上、用你的 seed 复现,而这是 0.83 那个说法能被作者以外的人检验的唯一途径。
权重是非商用的。对一个有着庞大爱好者社区的动漫模型来说,这是一种熟悉的安排:给画同人图的人免费,给拿它卖钱的人另外授权。它同时也意味着一家工作室想采用它,得先跟对方谈一谈。而对大多数专业用户来说,不管准确率这个数字是多少,这一条才是决定性的。
这次发布代表的那套模式
动漫生成这两年的方向,是收敛到一套栈上:一个底模,一组角色 LoRA 模型,再加上姿势、线稿、构图这几层控制。每一层都是另一个作者的一次小规模发布,往往配一个工作流文件,和一张把失败项一条条列出来的模型卡。
这种结构当然是有代价的。层与层之间的兼容性不归任何人负责,底模更新一次,可能同时弄坏四个附加组件。它也有一个好处,而且是市场上做得最精致的那一端一直想花钱买、却始终买不到的东西:失败清单是公开的,因为写这些工具的人,自己就是用户。
Anima-Control-Pose 是一次小规模的发布,附了一张诚实的卡。有意思的问题不是 0.83 好不好。真正的问题是,这个生态还会不会继续把数字公布出来,还是下一个版本只给一段好看的演示片,分母不见了。
把分母留着。它是唯一能让你自己做判断的那部分。
相关文章
十份降级报告,没有一份改了订单数字
十份降级报告都在讲不确定性,没有一份改动订单。真正的变量是 158 美元的恐慌低点和 5.1% 的十年期收益率。
三十三年来第一次,黄仁勋不在电话会上
数字几乎无悬念,真正要看的是克雷斯如何在首次独自主持的电话会上回答指引、Rubin 与毛利率三个问题。
一份社区维护的点击表,关掉了国产 Android 系统里的广告
它不动系统,不解锁,不刷机,只把厂商本来就留出来的开关一个个拨过去。代价是这份名单得一直有人续写。
GPT Image 2.6 守住 token 价格,账单却涨了
GPT Image 2.6 沿用了 2.5 的全部 token 费率,单张图却更贵,因为更多的活现在花在输出 token 上。上线十一天,定价结构说的比排行榜更多。