
螞蟻集團的 Ming-Image 以圖層設計,而非平面圖片
多數圖像模型的評價標準,是一張圖看起來有多好。螞蟻集團在 9 月 22 日發布了兩款模型,邀請大家用另一種方式檢驗:你拿回來的東西,在你看完它之後,是否還能繼續編輯。
螞蟻旗下的 inclusionAI 實驗室在 Hugging Face 上發布了 Ming-Image-0.1-Design 與 Ming-Image-0.1-Design-Layer,兩者皆為 60 億參數、採 MIT 授權。這個授權在這裡比平常更重要,因為它讓企業可以直接將輸出用於商業用途,無須事先協商。這對模型鎖定的是設計工作,而非攝影。介面畫面、資訊圖表、海報,以及那種文字必須真正清晰可讀的版面配置。
小字級向來是開放圖像模型崩解的地方。Ming-Image-0.1-Design 會生成整個構圖,文字也包含在內,而且能寫出 RGBA 檔案,因此背景會是透明的,而不是一片死白的矩形。模型卡建議使用 2048 x 2048,想加快速度則用 1024 x 1024,取樣步數 12 步、CFG 值 1.0。對擴散模型來說,12 步算是很低。權重載入之後,輸出便會迅速產生。它跑在標準的 diffusers 函式庫上,並支援以 vLLM-Omni 提供服務。
第二個模型才是有意思的那個。Ming-Image-0.1-Design-Layer 會拿一份已經完成、已經平面化的設計,按照你交給它的圖層規劃(說明你想要拆成幾塊),把它重新拆解成透明圖層。你最後得到的東西,更接近一份可用的設計檔案,而不是單一張平面 PNG。
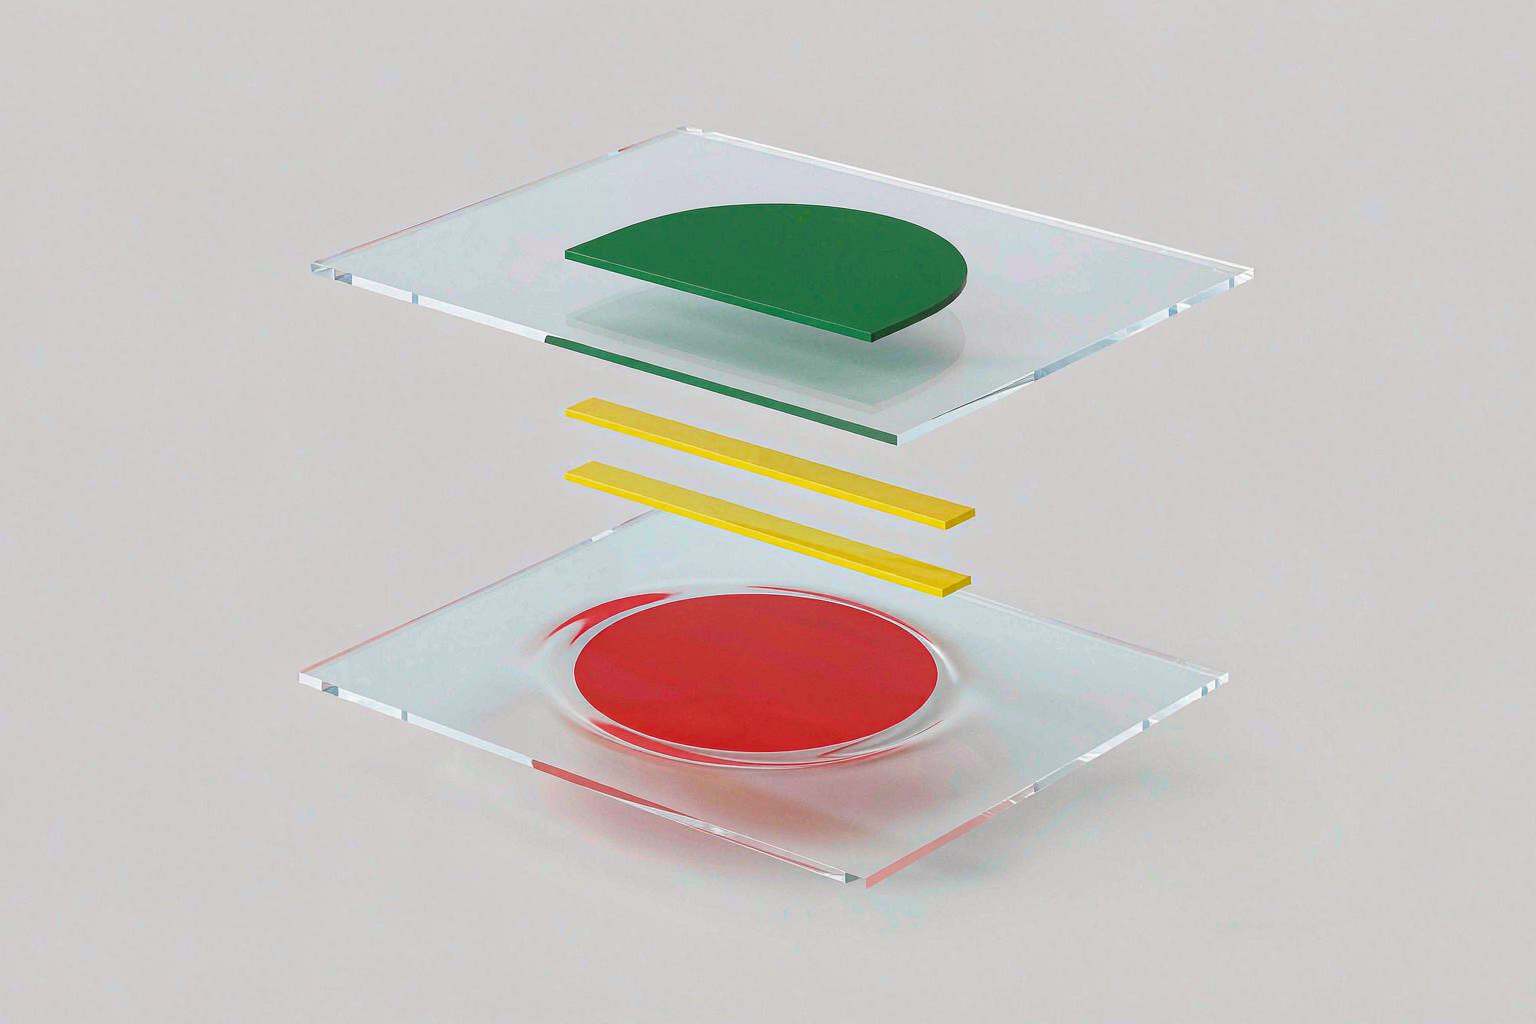
這個落差,正是多數圖像模型無法真正勝任設計工作的原因。如果客戶想把標題移個位置、把標誌換掉,平面 PNG 會逼你整張重新生成,畫布上其他所有東西也跟著一起變。有了圖層,你就能只改那一件事。螞蟻在 Crello 測試集上評估這項能力,衡量每個還原出來的圖層在顏色與形狀上有多接近。
螞蟻沒有公布的數字
沒有任何數字可以引用。模型卡指向 Artificial Analysis 的 UI/UX 設計排行榜以及 Crello 的結果,但兩者都只以圖表圖片的形式出現。內文沒有數字,也沒有指名競爭對手。從這次發布,你無法得知 Ming-Image-0.1-Design 與 Qwen-Image、Seedream 或任何商業模型相比如何,而這兩項說法除非你自己重跑一次評估,否則也無法查核。
硬體建議也有缺口。螞蟻在單張具備 80 GiB VRAM 的 CUDA GPU 上驗證了這個 6B 模型,這遠比參數量所暗示的餘裕還要多。模型卡對 24 GB 的消費級顯卡沒有任何指引,儘管專為這類顯卡打造的社群量化版本在數小時內就上線了。INT4、INT8、FP8、GGUF 與 ComfyUI 版本全都在同一天出現。
最後這個細節值得好好想一想。一家模型實驗室公布了 80 GiB 的需求,而社群的回應是讓這個模型跑在只有它三分之一的顯卡上。官方數字描述的是螞蟻測試了什麼,而不是這個模型需要什麼。任何正在評估是否採用的團隊,都應該把這個已驗證的配置當成起點,並實際查核量化版本在自己硬體上的表現。
為什麼圖層會改變工作流程
設計工作不是一連串完成的圖像,而是一連串的修改。客戶看到草稿,要求標題放大、背景調冷一點,接著又決定標誌應該放到另一側。這些要求每一項都很小。但在平面圖像上,每一項也都很昂貴,因為改動一個元素,就等於重新生成一個在其他所有地方都已獲認可的構圖。
圖層式輸出把這件事反了過來。一旦設計以獨立元件的形式存在,一次修改就只會動到與它相關的那個元件,其餘原封不動。對按時計費的代理商來說,差別反映在毛利上。對單打獨鬥的設計師來說,差別反映在這工具是否比自己做還快。
圖層另一個發揮價值的地方是交付。平面 PNG 是條死路。下游任何需要調整它的人,都得從頭來過。圖層檔案則可以直接進入設計團隊原本就在用的工具裡,這就是一個 AI 工具是「待在」工作流程旁邊,還是「加入」工作流程的差別。
這屬於哪一場編輯競賽
螞蟻並不是把產品丟進一片空白市場。縱觀整個圖像市場,編輯已成為模型分出高下的地方。GPT Image 2.5 Sunburst 位居編輯排行榜首位,其兄弟模型 Flare 緊隨其後。Nano Banana Pro 仍是無須微調就能鎖定身分的最簡單途徑,而且能融合多達十四張圖像與五個人。Seedream 5.0 把編輯與即時網路搜尋配對,當編輯需要真實參考資料時很有幫助。在開放陣營這邊,FLUX.1 Kontext 處理你自行執行的版面保留式編輯,Qwen-Image-Edit 則在開放權重編輯排名中領先。
對照這樣的陣容,Ming-Image 下的是一個狹窄的賭注。它不打算贏得通用編輯競技場。它賭的是:文字密集的設計是市場中夠大的一塊,足以支撐一個專門化模型;而圖層分解是一項通用模型不會費心去做的功能,因為它不會出現在展示影片裡。
這個賭注背後有段歷史。開放圖像模型花了兩年追逐照片寫實,開放與封閉權重之間的品質差距已經縮小很多。沒有縮小的是「產出圖片」的模型與「產出資產」的模型之間的差距。圖片只要看起來對了就算完成。資產則要能被交給別人並且修改,才算完成。Ming-Image 瞄準的是第二類,這種東西在發布貼文裡更難展示,卻在週二下午更為實用。
這到底是給誰用的
如果你大量產出設計資產,而且其中的文字必須清晰易讀,那麼這東西現在就值得一試。一個小型行銷團隊產出社群卡片、廣告變體與內部簡報,是最明確的適用對象,而 MIT 授權讓你和商業使用之間沒有任何條件阻隔。
我會從圖層模型開始,因為圖層式輸出正是你現有的圖像工具幾乎肯定做不到的事。這裡其他的一切——一個能渲染可讀文字的文字生圖模型——都有競爭對手。但能把一份完成的平面設計變成可編輯檔案交還給你,則沒有。
第一個值得跑的測試,是英文以外語言的小字級文字渲染。這正是這類模型通常失手的地方,而這次發布對此隻字未提。多語排版是多數真實設計工作背後隱藏的需求,而一個只把拉丁字母處理得好的模型,就是一個有天花板的模型。
如果你的產出是攝影而非排版,以上都不適用。Ming-Image 並無意與那些渲染俊男美女與風景的模型競爭。它瞄準的是設計中不那麼光鮮的那一半——海報需要把標題放在正確位置,產品卡需要一個人類讀得出來的價格。那一半已經等一個認真看待它的模型,等了很久。