
Hy Image 3.5 排上 OpenRouter 第九:騰訊靠 20 張參考圖擠進榜
在 OpenRouter 的圖像排行榜往下滑得夠久,你會撞到一個不合規律的名字。在 Google 第三和第四個 Nano Banana 變體之間,坐著騰訊的 Hy Image 3.5 Preview,一週處理 15.9 億 token。
那是第九名。對一個 10 月 5 日上線、幾乎沒有英文報導、而且這個產業裡大多數人把它放到供應商地圖上都會卡住的模型來說,不算差。
這個排名資料值得仔細讀,因為很容易誤讀。OpenRouter 的圖像榜是按 token 排的,這跟用量相關,但不跟品質相關。Nano Banana 2 以 57.6 億排第一,是因為它是十萬個 app 預設會去拿的那個。Hy Image 的 15.9 億,是因為有足夠多在建 pipeline 的人刻意選了它,而且價格還不是榜上最便宜的。
每百萬 token 1.60 美元,夾在 Google Flash 級距的 0.50 美元和 OpenAI GPT Image 2.5 的 8 美元之間。那是尷尬的中間,而一個模型不會偶然停在這個位置。它靠的是做到便宜級距做不到的事。
它宣稱什麼
模型卡描述的是一個統一的圖像模型——一個端點做文生圖、圖生圖和多輪編輯。值得畫線的部分:
每次請求最多二十張參考圖。 這是跳出來的那個數字。大多數圖像 API 接受一到四張參考,而且會拜託你別再多。二十張不是漸進改善,是另一個類別的任務。產品型錄。角色設定表。一個品牌的整套視覺系統,一次呼叫交出去。
輸出最高 4K。 2026 年這個級距的標準,但以這個價格值得確認一下。
中英文文字渲染。 這是模型變得有意思的地方,我等下會回來講。
建在 80B 的混合專家 Hy Image 3.0 基座上。 以它所競爭的 Flash 級距模型標準來看,這是個大的基座,這解釋了價格,也——如果宣稱成立——解釋了主體一致性。
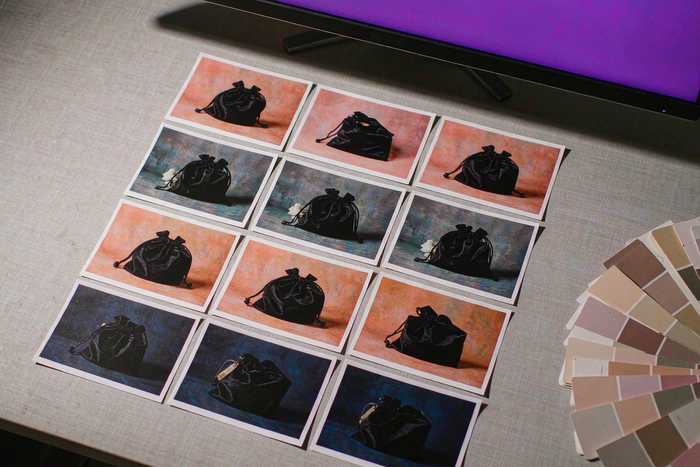
二十張參考圖的宣稱,實際上
想想你餵很多參考圖給圖像模型時會壞在哪。通常模型會把它們平均掉。給它同一件外套的五張照片,你會得到一個外套形狀的模糊,領子來自一張,鈕扣來自另一張。跨系列的主體一致性是真難題,而且難在結構上:模型必須在各自獨立的條件訊號之間追蹤身分,而不是把它們合併成單一風格。
二十張參考圖這種數字,暗示騰訊是在架構層解決了這件事,而不是在提示詞層。模型卡的措辭——「在跨編輯的主體一致性上特別強、構圖忠於提示」——正是實驗室在內部 benchmark 顯示出差距時會用的語言。
那個差距能不能撐過獨立測試是另一回事。目前還沒有我會信任的 Hy Image 3.5 第三方評測。我們有的是一個基於用量的排行榜位置、模型卡的宣稱,以及這個模型是 preview 版——那是一種保留,不是承諾。
文字渲染這個角度
生成圖片裡的拉丁文字排版,在 2025 年某個時候變成了基本門檻。現在每個認真的模型都能渲染出可辨識的招牌,大致上。中文字是另一個問題,而且十年來都是。
CJK 字形密集、成員數千,而且正確性是二元的,拉丁字母不是。一個略微變形的「a」還是讀成「a」。一個變形的「粵」就是錯字。西方實驗室在這裡有進步,但失敗還是常見得讓任何做中文設計的人早就學會事後自己合成字。
騰訊用這個價格宣稱兩種語言,是瞄準一個特定市場:龐大的中文電商與行銷產業,在那裡一張寫錯字的產品海報不是可愛的瑕疵,是被退回的交付物。這也是 token 用量可信的原因。一個修好中文排版的模型,等於從幾千條生產 pipeline 裡拿掉一整個後處理步驟。
它為什麼會出現在西方的聚合器上
這裡有個比任何單一模型都更重要的結構故事。
兩年前,你用中國圖像模型的方式是:找到廠商的 console、學它的驗證機制、接受從區域外連線延遲會更差,然後寫一個客製 client。那個摩擦力足以把大多數西方開發者擋在外面。
OpenRouter 把它壓平了。一組 key、一個 schema、一張帳單。結果是模型品質現在幾乎即時地跨過國界——而排行榜變成了真正的競爭場。騰訊不需要在舊金山辦開發者關係活動,只要它能守住一個每個創辦人都會看的榜上的第九名。
同樣的動態把位元組跳動的 Seedream 推到圖像榜的第四和第五,也把四個位元組跳動的影片模型推進影片前十。「哪個國家做出最好的模型」這場對話大致結束了;剩下的是一張誰都能檢視的價格與能力格。
真正未知的部分
有幾件事,而且都不小。
圖像的 token 計價是不透明的。 每百萬 token 1.60 美元什麼都告訴不了你,除非你知道一張圖值多少 token,而那取決於解析度,也常常取決於廠商內部的計算方式。拿它跟 Seedream 5.0 Flash 的「每張 0.018 美元起」比,不是你能只看價格欄就做的比較。
Preview 就是 preview。 行為可能改變,端點可能重新定價,你十一月 benchmark 的模型,可能不是你一月拿到的模型。
授權與資料條款從模型卡上看不出來。對任何用參考圖做商業工作的人來說——那正是二十張輸入的整個使用場景——這是試用前就該有答案的問題,不是試用後。
我會怎麼測
不是用一個漂亮的提示詞。用它宣稱擅長的東西。
拿同一個物件的十二張不同角度照片,放進同一次請求,然後要求這個物件出現在一個它從沒待過的場景裡。接著用四張參考重做一次,看它差多少。兩次之間的落差,就告訴你二十張輸入是真的能力,還是被灌水的參數。
第二個測試:一張有中文標題和拉丁副標的海報,用最終尺寸,放大到 100%。數錯字。這個測試決定它該進生產 pipeline,還是進 demo 資料夾。
排行榜說大家已經在做這件事了。在一個前三名是 Google、第四名是位元組跳動的榜上排第九,不是行銷位置——是很多開發者安靜地認定,中間那個價格級距值得。