
Hy Image 3.5 : 20 images de référence, 9e place sur OpenRouter
Descendez assez loin dans le classement d'images d'OpenRouter et vous tombez sur un nom qui ne suit pas le motif. Entre la troisième et la quatrième variante de Nano Banana de Google siège Hy Image 3.5 Preview, de Tencent, avec 1,59 milliard de tokens traités en une semaine.
C'est la neuvième place. Pas mal pour un modèle lancé le 5 octobre avec presque aucune couverture anglophone, et que la plupart des gens du secteur auraient du mal à situer sur une carte des fournisseurs.
Les données de classement méritent une lecture attentive, parce qu'elles se lisent facilement de travers. Le tableau image d'OpenRouter est ordonné par tokens, ce qui corrèle avec le volume mais pas avec la qualité. Nano Banana 2 en tête avec 5,76 B est là parce que c'est le défaut vers lequel cent mille applications se tournent. Hy Image à 1,59 B est là parce que suffisamment de gens construisant des pipelines l'ont choisi exprès, à un prix qui n'est pas le moins cher du tableau.
1,60 $ par million de tokens se place entre le palier Flash de Google à 0,50 $ et GPT Image 2.5 d'OpenAI à 8 $. C'est le milieu inconfortable, et un modèle ne tient pas une position médiane par accident. Il la tient en faisant quelque chose que le palier bon marché ne sait pas faire.
Ce qu'il annonce
La fiche modèle décrit un modèle d'image unifié — un seul endpoint pour le texte-vers-image, l'image-vers-image et l'édition multi-tours. Les points à souligner :
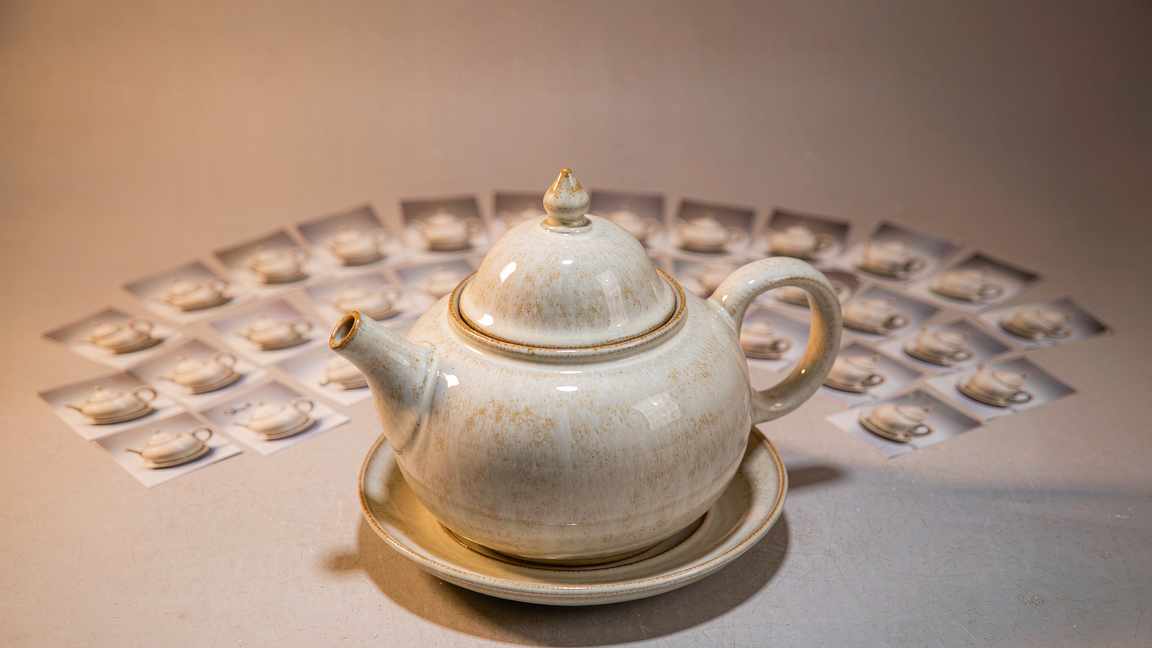
Jusqu'à vingt images de référence par requête. C'est le chiffre qui ressort. La plupart des API d'image acceptent une à quatre références, et vous supplient de ne pas en demander plus. Vingt n'est pas une amélioration incrémentale, c'est une autre catégorie de tâche. Catalogues produits. Planches de personnages. Tout le système visuel d'une marque, livré en un appel.
Sortie jusqu'à 4K. Standard pour ce palier en 2026, mais bon à confirmer vu le prix.
Rendu de texte en chinois et en anglais. C'est là que le modèle devient intéressant, et j'y reviens.
Bâti sur la base mixture-of-experts Hy Image 3.0 de 80 B. Une grosse base pour les standards des modèles de palier Flash auxquels il se compare, ce qui explique le prix et, si les affirmations tiennent, la cohérence des sujets.
Les vingt références, en pratique
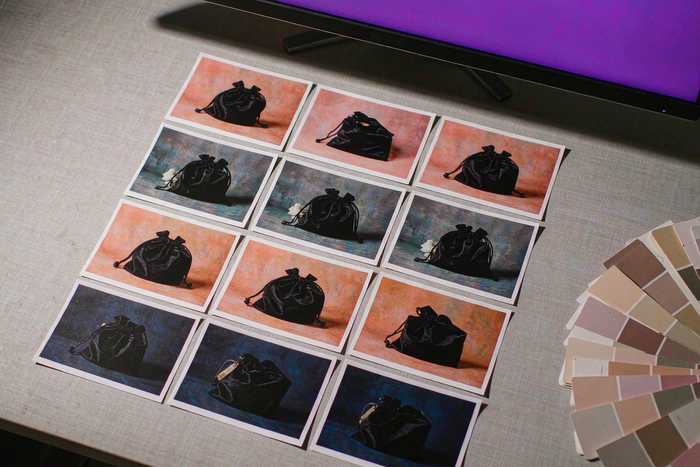
Pensez à ce qui casse quand vous donnez beaucoup de références à un modèle d'image. En général, le modèle les moyenne. Donnez-lui cinq photos de la même veste et vous obtenez un flou en forme de veste, avec le col de l'une et les boutons d'une autre. La cohérence d'un sujet sur une série est un problème réellement difficile, et il l'est pour une raison structurelle : le modèle doit suivre une identité à travers des signaux de conditionnement séparés au lieu de les fusionner en un seul style.
Vingt références est le genre de chiffre qui suggère que Tencent a résolu ça au niveau de l'architecture plutôt qu'au niveau du prompt. La formulation de la fiche — « particulièrement solide sur la cohérence des sujets à travers les éditions, composition fidèle au prompt » — est exactement le langage qu'emploie un labo quand il a un benchmark interne qui montre un écart.
Savoir si cet écart survit à des tests indépendants est une autre affaire. Il n'existe pas encore d'évaluation tierce de Hy Image 3.5 à laquelle je ferais confiance. Ce qu'on a : une position dans un classement fondée sur l'usage, les affirmations d'une fiche modèle, et le fait que le modèle est une version preview — ce qui est une précaution, pas une promesse.
L'angle du rendu de texte
La typographie latine dans les images générées est devenue un prérequis quelque part en 2025. Chaque modèle sérieux sait désormais rendre une enseigne lisible, à peu près. Le texte chinois est un autre problème, et il l'est depuis dix ans.
Les glyphes CJK sont denses, comptent des milliers de membres, et leur correction est binaire d'une façon que les formes latines ne connaissent pas. Un « a » légèrement malformé se lit encore comme un « a ». Un 粤 malformé est simplement un mauvais caractère. Les labos occidentaux ont progressé, mais les échecs restent assez fréquents pour que quiconque fait du design en chinois ait appris à composer la typo après coup.
Que Tencent revendique les deux langues, à ce prix, est une affirmation visant un marché précis : l'énorme secteur chinois du e-commerce et du marketing, où une affiche produit avec un mauvais caractère n'est pas un artefact charmant — c'est une livraison refusée. C'est aussi pourquoi le volume de tokens est plausible. Un modèle qui règle la typographie chinoise retire une étape entière de post-traitement à des milliers de pipelines de production.
Pourquoi il apparaît sur un agrégateur occidental
Il y a là une histoire structurelle qui compte plus que n'importe quel modèle pris isolément.
Il y a deux ans, pour utiliser un modèle d'image chinois, il fallait trouver la console du fournisseur, apprendre son schéma d'authentification, accepter une latence pire depuis l'extérieur de la région, et écrire un client sur mesure. C'était assez de friction pour tenir à l'écart la plupart des développeurs occidentaux.
OpenRouter a aplati tout ça. Une clé, un schéma, une facture. Résultat : la qualité des modèles circule désormais à peu près instantanément au-delà des frontières — et le classement est devenu la vraie arène concurrentielle. Tencent n'a pas besoin d'une campagne de developer relations à San Francisco s'il tient une neuvième place sur un tableau que chaque fondateur consulte.
C'est la même dynamique qui place Seedream de ByteDance en quatrième et cinquième position du tableau image, et quatre modèles vidéo ByteDance dans le top dix vidéo. La conversation « quel pays fait le meilleur modèle » est à peu près terminée ; ce qui reste est une grille prix-capacités que n'importe qui peut inspecter.
Ce qui reste vraiment inconnu
Plusieurs choses, et elles ne sont pas petites.
Le prix au token pour les images est opaque. 1,60 $ par million de tokens ne vous dit rien tant que vous ignorez combien de tokens coûte une image, ce qui dépend de la résolution et, souvent, de la comptabilité interne du fournisseur. La comparaison avec « à partir de 0,018 $ par image » sur Seedream 5.0 Flash n'est pas une comparaison qu'on peut faire depuis la seule colonne des prix.
Preview veut dire preview. Le comportement peut changer, le tarif des endpoints peut évoluer, et le modèle que vous avez évalué en novembre ne sera peut-être pas celui que vous aurez en janvier.
La licence et les conditions de données ne sont pas visibles depuis la fiche modèle. Pour quiconque fait du travail commercial avec des images de référence — ce qui est exactement le cas d'usage des vingt entrées — c'est la question à laquelle il faut une réponse avant l'essai, pas après.
Comment je le testerais
Pas avec un joli prompt. Avec ce qu'il prétend savoir faire.
Prenez douze photos d'un même objet sous différents angles, mettez-les dans une seule requête, et demandez l'objet dans une scène où il n'a jamais été. Puis recommencez avec quatre références et regardez de combien ça se dégrade. L'écart entre les deux exécutions vous dit si vingt entrées est une vraie capacité ou un paramètre gonflé.
Deuxième test : une affiche avec un titre en chinois et un sous-titre latin, en taille finale, zoomée à 100 %. Comptez les caractères faux. C'est le test qui décide si ce modèle a sa place dans un pipeline de production ou dans un dossier de démos.
Le classement dit que les gens le font déjà. Une neuvième place sur un tableau où le top trois est Google et le quatrième ByteDance n'est pas une position marketing — c'est beaucoup de développeurs qui décident, discrètement, que le palier de prix intermédiaire vaut le coup.
Articles associés
Une feuille de calcul communautaire de clics pour couper les publicités des Android chinois
Il ne touche pas au système, ne déverrouille rien, ne flashe rien. Il bascule un à un les interrupteurs que les fabricants ont déjà prévus. Le prix à payer, c'est la liste qu'il faut continuer d'écrire.
GPT Image 2.6 a tenu le prix des tokens et fait monter la facture
GPT Image 2.6 reprend chaque tarif au token de 2.5 et coûte malgré tout plus cher par image, parce qu'une part plus grande du travail se paie en tokens de sortie. Onze jours après le lancement, la grille tarifaire dit plus que le classement.
Quelqu'un a reconstruit IDM de l'extérieur et a écrit ce qu'il n'a pas touché
Une réimplémentation en Rust d'Internet Download Manager revendique 5 fois la vitesse et 86 langues. Le document le plus intéressant est le paragraphe qui explique comment elle a été construite sans rien copier.
Rune est un framework UI Rust conçu pour qu'un agent puisse vérifier son propre travail
Rune rend en headless, vide son arbre d'éléments et accepte des entrées scriptées, ce qui donne à un agent de codage un signal différable qu'aucune capture d'écran ne fournit. Le framework est en préversion et n'accepte pas de pull requests.