
Data centers de IA agora esperam por linhas de energia, não por entregas de chips
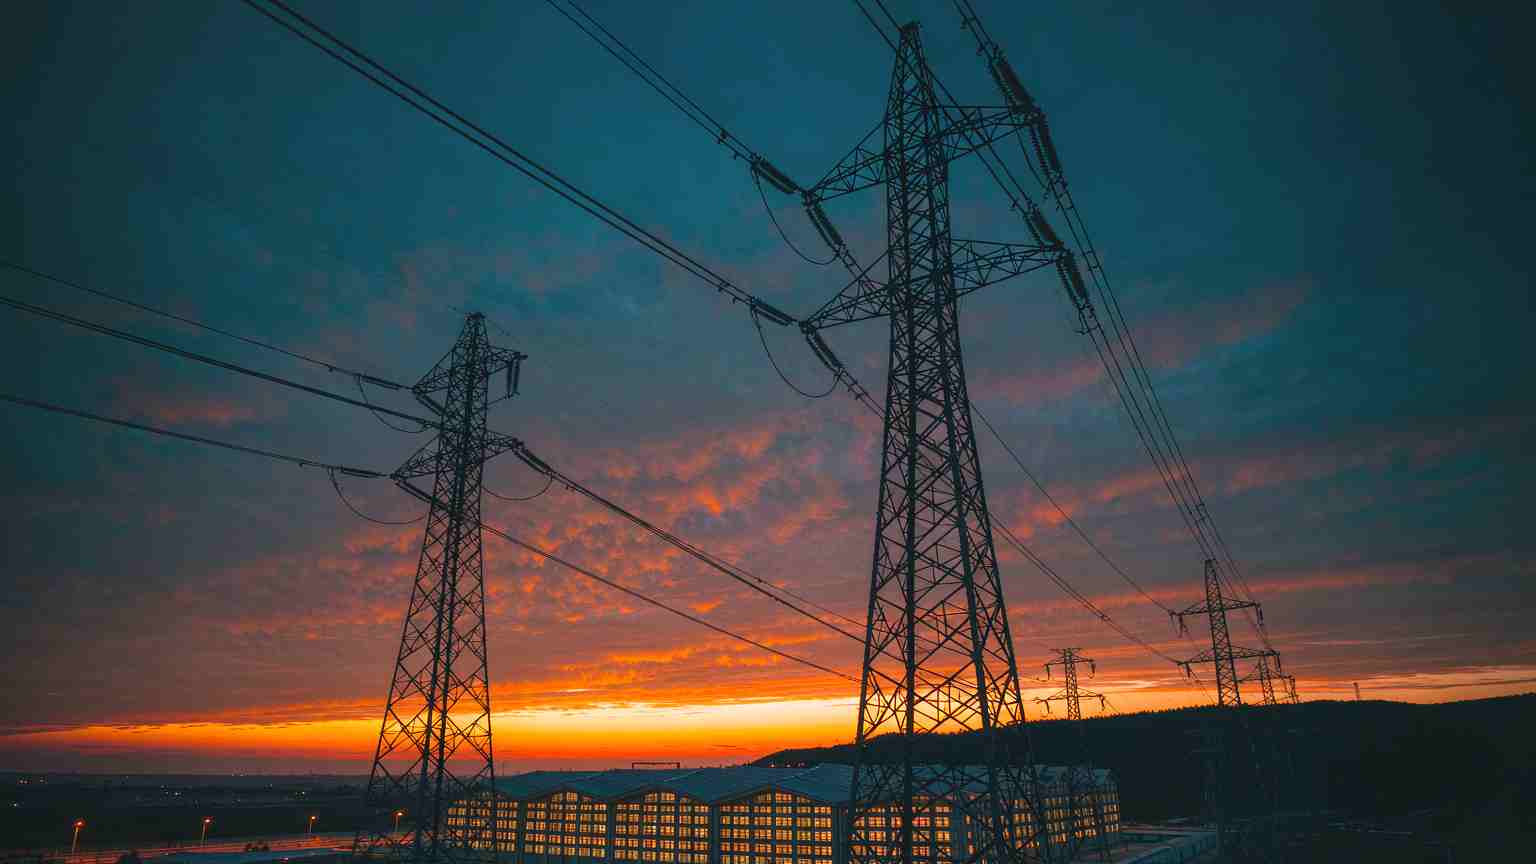
O data center de IA que a Oracle planeja em Wisconsin está atrasado, e o motivo não é o silício. O projeto aguarda aprovação regulatória para uma conexão à rede elétrica, o que coloca em risco a entrega aos clientes em 2027. Na mesma época, mais de US$ 800 milhões em nova capacidade avançaram por aprovações de rede ou de planejamento: um campus de 250 megawatts em Pyhäjoki, na Finlândia, que superou a oposição local, um projeto de US$ 270 milhões no Egito, 401 milhões de euros de financiamento da UE na Polônia e 80 milhões de euros na França. Cada um desses projetos depende de infraestrutura de energia, não do fornecimento de chips.
Durante dois anos, a conversa sobre infraestrutura de IA girou em torno dos aceleradores. Isso está mudando. A restrição que agora decide se um data center entra em operação no prazo está a montante do rack de servidores.
O rack ficou grande demais para o prédio
Um rack otimizado para IA agora demanda de 30 quilowatts a mais de 100, e algumas implantações ultrapassam 150 quilowatts. Um rack empresarial tradicional consome uma fração mínima disso. Não se trata de um aumento marginal que possa ser absorvido pelas salas elétricas e pelos circuitos de resfriamento existentes. Ele exige novas subestações, nova capacidade de transformadores e, em muitos casos, resfriamento líquido instalado no piso.
Os números do lado da eletricidade são grandes o suficiente para importar em escala nacional. O consumo dos data centers nos EUA está em cerca de 180 terawatts-hora hoje, e previsões confiáveis apontam de 400 a 600 terawatts-hora até 2030. Esse é o tipo de crescimento de demanda que transforma uma concessionária em um parceiro com poder de barganha e converte uma fila de interconexão em risco de cronograma.
O atraso da Oracle em Wisconsin é a ilustração mais clara. A empresa está construindo para clientes de IA com compromissos para 2027, e uma aprovação de transmissão pode atrasar trimestres sem que ninguém no fornecedor de chips possa fazer nada.
Os operadores estão se tornando empresas de energia
A resposta tem sido a integração vertical. Os operadores de data centers agora assinam contratos de compra de energia, investem em geração e, em alguns casos, constroem a própria conexão. O projeto Enetron, na Finlândia, precisou de uma sobreposição de zoneamento, que é o que acontece quando uma carga de 250 megawatts é grande o bastante para dominar o planejamento de uma rede local.
Isso muda a economia de um data center de uma forma fácil de passar despercebida. Historicamente, a escolha do local otimizava custo do terreno, rotas de fibra e incentivos fiscais. A energia era uma conta de luz. Agora, a disponibilidade de energia é um portão no cronograma, e o terreno mais barato perto de um centro populacional costuma ser o pior lugar para construir, porque a rede já está carregada.
É por isso que os novos projetos se concentram onde se concentram. Os países nórdicos têm capacidade hidrelétrica e ar frio. O Egito tem geração barata e proximidade com a demanda europeia e do Oriente Médio. Polônia e França estão usando dinheiro público para viabilizar conexões mais rapidamente. O padrão não tem a ver com tecnologia. Tem a ver com eletricidade e calor.
A memória acabou sendo a outra escassez
Enquanto o setor observava a energia, uma segunda restrição se apertou. A memória de alta largura de banda tornou-se o insumo mais escasso do rack. A HBM4 da Micron é negociada a cerca de 15 vezes o valor unitário da DRAM padrão em peso. É um sinal de preço forte o suficiente para reordenar cadeias de suprimentos, porque a HBM não é uma commodity que se possa trocar por uma peça mais barata quando a disponibilidade está apertada.
O desequilíbrio histórico é gritante. A taxa de processamento de computação nos chips de IA cresceu cerca de um milhão de vezes ao longo da história do setor, enquanto a largura de banda de memória cresceu por um fator de cerca de 40. Os aceleradores conseguem executar aritmética muito mais rápido do que a memória consegue alimentá-los, e é por isso que as soluções alternativas importam tanto. A quantização FP8 e FP4 reduz pela metade e a um quarto a pegada de memória de um modelo, e técnicas como mixture-of-experts ativam uma pequena fatia de parâmetros por token, de modo que um modelo com trilhões de parâmetros totais não precise mantê-los todos residentes ao mesmo tempo.
Essas técnicas não são otimizações que se aplicam quando há capacidade de sobra. Elas são a razão pela qual as cargas de trabalho cabem, e restringem quais arquiteturas de modelo são viáveis de implantar. Uma equipe que escolhe entre dois modelos agora pondera a largura de banda de memória por token tanto quanto pondera as pontuações de benchmark.
A memória decide quais arquiteturas chegam ao mercado
A restrição de memória faz mais do que limitar a oferta. Ela molda o que é construído.
Um modelo com uma janela de contexto muito grande precisa manter um grande cache de chave-valor durante a inferência, e esse cache compete com os pesos pela mesma memória. Arquiteturas que pareciam eficientes no papel tornam-se inviáveis quando só o cache já excede o que cabe em um dispositivo. É por isso que técnicas que trocam computação por memória, incluindo paginar o cache para a memória do host ou comprimi-lo, passaram de curiosidades de pesquisa a componentes padrão.
O resultado é que as decisões de arquitetura seguem cada vez mais a disponibilidade de memória, e não o contrário. Uma equipe que quer um contexto mais longo tem de decidir se o ganho de precisão justifica a conta de memória, e a resposta frequentemente depende de qual geração de acelerador ela consegue de fato obter. São decisões de cadeia de suprimentos vestidas de design de modelo.
A memória de alta largura de banda torna isso mais acentuado porque é um produto especializado com uma base pequena de fornecedores. A DRAM padrão pode ser adquirida de muitas fontes e substituída. A HBM é produzida por um punhado de fabricantes, vem em pilhas fixas e é alocada com bastante antecedência. Uma escassez não se resolve pagando mais. Resolve-se esperando.
Por que isso muda o mapa competitivo
Quando os chips eram a restrição, a empresa com o melhor acelerador levava vantagem, e os compradores faziam fila. Quando a energia e a memória são a restrição, a vantagem passa para quem consegue garantir megawatts e alocações de memória, o que favorece empresas com balanços sólidos, relações de longo prazo com concessionárias e paciência para construir geração.
Esse é um conjunto diferente de vencedores. Um provedor de nuvem bem capitalizado que assina um contrato de energia de 20 anos tem uma vantagem que uma equipe de engenharia não consegue igualar com um kernel melhor. Isso também significa que a geografia volta a importar, porque a eletricidade é local e as fábricas de memória são poucas.
Há um efeito de segunda ordem. Se as filas de interconexão continuarem longas, cresce a pressão para usar a capacidade existente de forma mais eficiente. Isso favorece técnicas como quantização e decodificação especulativa, e favorece modelos menores que podem ser servidos em hardware já instalado, em vez de hardware que ainda espera por uma subestação.
O que observar
A fila de interconexão. Se as aprovações para grandes cargas demorarem mais no ano que vem do que neste ano, mais projetos atrasarão, e o risco de cronograma se tornará uma premissa de planejamento em vez de uma surpresa.
A curva de preços da memória. O preço da HBM em relação à DRAM padrão indica quanto de prêmio os compradores estão dispostos a pagar por largura de banda. Se o prêmio diminuir, a oferta alcançou a demanda. Se aumentar, a escassez está definindo mais do roadmap.
Se os operadores continuarão comprando geração. Cada data center que se torna uma empresa de energia muda a lista de clientes do setor elétrico. Se alguns grandes operadores possuírem capacidade de geração relevante, a próxima rodada de capacidade de IA será construída onde eles puderem gerar a energia, e não onde a energia já está.
A história dos chips continua, mas ela já não define o prazo. Os projetos que entrarem em operação no prazo em 2027 serão aqueles que resolveram primeiro a conexão e a alocação de memória, e o acelerador que eles instalarem será a parte fácil.
Artigos relacionados
O ranking de modelos de vídeo que ninguém divulga: para onde as requisições realmente vão
Toda semana surge um novo ranking de geração de vídeo, e quase todos são construídos da mesma forma.
A Ai2 Tornou Open Source o Stack de Treinamento, e Não Mais um Conjunto de Pesos
Pesos são fáceis de distribuir e difíceis de aprender com eles.
Qwen3.8-Max, da Alibaba, afirma que consegue programar sozinho por uma quinzena
Contagens de parâmetros deixaram de ser novidade há algum tempo. Doze dias é o número que vale examinar.
PixelUMM descarta os dois componentes dos quais todo modelo de IA visual depende
A difusão em nível de pixel já foi proposta antes e repetidamente esbarrou no custo computacional.