
「複製物なのはモデルではなく出力」——美杜莎LoRA判決の理屈
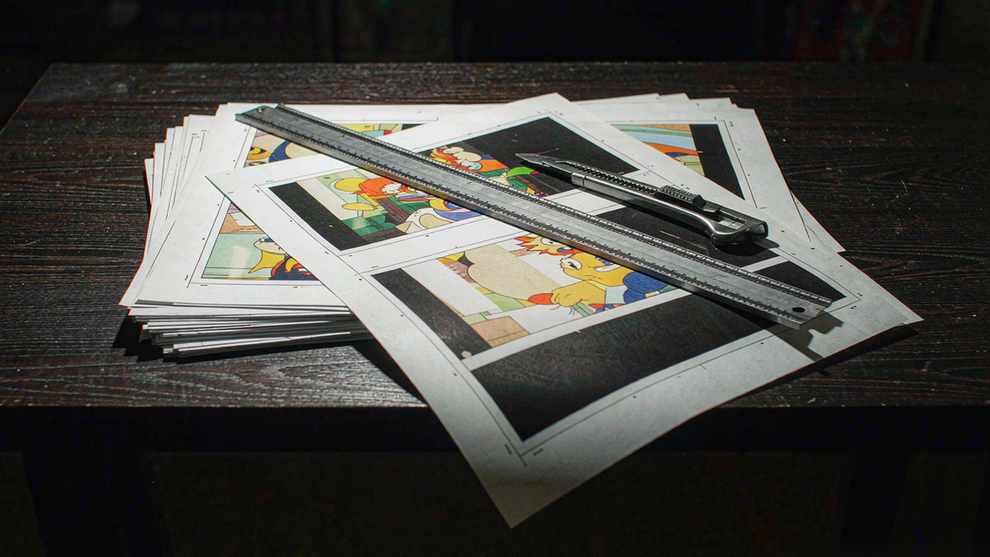
アニメのスクリーンショットが二十数枚、有料動画のサブスク、切り抜きツール、そしてプラットフォームの「LoRAを学習」ボタン。中国の著作権事件の事実関係はこれで全部だ。控訴審の判断が下りた今、結果よりも理屈のほうが役に立つ。
原告は、中国の長寿アニメ『斗破蒼穹』に登場するメドゥーサのキャラクターデザインの権利者だ。あるユーザーがそのキャラクターの二十数コマを切り出して加工し、プラットフォームのLoRA学習機能に投入して、小さなモデルを二つ作った。一つは新衣装の名を冠し、もう一つは現行バージョンの名を冠していた。彼は両方をプラットフォーム上で公開した。その後、他のユーザーがプロンプトを打つと、メドゥーサの画像が出てきた。まったく同じものもあれば、かなり近いものもあった。
原告はプラットフォームに200万元、ユーザーに20万元を求め、15万元の範囲で連帯責任を主張した。裁判所はユーザーの責任を認め、プラットフォームは免責とした。どちらの結論も重要だが、その間の理屈こそ読む価値がある。
複製とは再現であって、保存ではない
控訴審の理屈は、たった一つの法理の置き換えに乗っている。複製権の本質は「再現する」権利、つまり著作物をもう一度知覚可能にすることだ。保存することではない。学習させることでもない。もう一度立ち上げることだ。
裁判所はその連鎖を三つの環に切り、それぞれを個別に判断した。
第一の環は、スクリーンショットを撮り、切り抜いて学習用パックにすること。これは複製であり、侵害にあたる。
第二の環は、そのパックをLoRA学習に投入すること。裁判所はこれが当然に複製になるわけではないとし、そして採用した説明こそが事件の分岐点だった。LoRAが学ぶのは、重みの差分の低ランク行列だ。裁判所の言葉を借りれば、それは元画像の符号化ではなく、低ランクの統計的圧縮である。そのパラメータを寄せ集めても元の絵には戻せない。
第三の環は、ユーザーがプロンプトを出し、モデルが原作と実質的に類似するものを出力した瞬間だ。そこで複製が完成し、そこで責任が生じる。
{{INLINE1}}技術的な細部が判決を決めた理由
中国の裁判所が判決文で「LoRAには何が入っているのか」を語らなければならなかったのは、これが初めてだ。採用された答えは、多くの機械学習エンジニアが出すものと同じである。ランク分解された差分、つまり基盤モデルの振る舞いをずらす数百万個の数値であり、学習画像の検索可能なコピーは一切含まない。
これが効くのは、人が習慣的に一緒くたにする二つを切り離すからだ。著作物で学習することと、著作物を再現することは別の行為であり、後者には第二の行為者、つまりプロンプトを打った人が要る。裁判所は因果の連鎖を組み立て、その末端に特定の人間の手を置いた。
それはまた、勘に頼らない明快な基準にもなる。出力が実質的に類似していれば複製は起きており、そうでなければ起きていない。被告が実際に反論できる基準だ。「モデルがあなたの絵を見た」とは違う。
英国のGetty対Stability訴訟と比べてみるといい。専門家証言は、Stable Diffusionの重みが学習画像のコピーを保存も含有もしておらず、そこから導かれた統計的パターンだけを持つことを示した。英国の裁判所はその認定をもって二次的侵害の請求を退けた。Gettyは「侵害複製物」の解釈について上訴を許可されており、審理は11月の見込みだ。二つの法域、異なる法規で、たどり着いた技術的風景は似ている。
プラットフォームが逃れたのは、無垢だったからではなく手続きがあったからだ
プラットフォームの逃げ切りは見た目より脆い。ここは他のプラットフォームが二度読むべき箇所だ。
裁判所は「学習機能を提供すること自体が安全だ」とは言っていない。言ったのは、今回の標的型の学習を行ったのはユーザーであり、基盤モデルを選び、素材をアップロードし、パラメータを設定したのもユーザーだということだ。プラットフォームが提供したのは基盤モデル、計算資源、公開の場だ。その責任は、情報を管理する能力に見合った注意義務を果たしたかどうかにかかっており、本件ではモデルを削除し、データをミラーしていた海外プラットフォームに通知もしていた。
これは免罪符ではなくチェックリストとして読むべきだ。通知、削除、そして記録の残るエスカレーション経路——それがプラットフォームの結果を買った。LoRAを預かりながら、権利者の申し立てに何もしないプラットフォームは立場が違い、同じ裁判所もそう言うだろう。
一審から一本、糸が垂れている。ウルトラマンのLoRAをめぐる別の杭州的事件で、一審裁判所は、学習が著作物の表現上の独創性を利用することを目的としていた証拠がなく、権利者に不合理な損害もない場合、学習がフェアユースになり得るかを検討した。控訴審はその問いに到達していない。つまり中国の実務ではフェアユースの扉はまだ開いたままで、ただ誰もくぐっていないだけだ。
より大きな枠組みは9月に来た
9月7日、中国の最高人民法院は「人工知能関連紛争の審理に関する意見」を公表した。この種の紛争に対する中国初の司法ルールだ。第12条は、サービスの類型、学習データの出所、各当事者の関与の程度、講じた措置、得た利益を衡量して、開発者、提供者、ユーザーの間で責任を配分する。
さらに、非侵害を主張する開発者に立証責任を課す。学習データがどこから来たかの証拠、学習過程の記録、モデルがどう動作するかの説明を提出しなければならない。第14条は別途、AI支援による発明も特許を取得できると確認しつつ、発明者は自然人でなければならないとした。
これは美杜莎判決と同じ構造を、一般化したものだ。責任は説明能力に従う。技術的な事実を握る当事者が、それを語る負担を負う。
この理屈がまだ壊れうる場所
低ランク論は、二十枚の画像で学習した小さなLoRAにはきれいに当てはまる。学習セットが大きくなりランクが上がると怪しくなる。どこかの時点でモデルは一般化ではなく記憶をし始め、「統計的圧縮」と「非可逆なコピー」の境目が見えなくなるからだ。
Gettyの英国事件はすでにここに目印を置いている。双方の専門家が、条件次第でStable DiffusionはGettyの透かしが入った画像を出力すると認めた。学習データに透かし入りの画像があり、モデルが透かしを再現できるほど記憶していたからだ。英国の裁判所は商標に関する認定を三枚の例示画像に限定し、SDXLとv1.6についての広い主張は証拠に照らして退けた。教訓は「記憶は起きない」ではない。記憶はモデルごと、プロンプトごと、出力ごとに立証されなければならない、ということだ。
この判決が次に試されるのはそこだ。一つのプロンプトで保護されたキャラクターが確実に再生成されると原告が示せれば、第三の環が閉じ、責任が戻ってくる。今後の事件で技術的な争点になるのは、何回試したか、である。
LoRAを学習する側にとっての意味
この事件から出てくる実務ルールは複雑ではない。ライセンスを受けていない著作物のコマから学習セットを作らないこと。たとえ私的にツールを作るためだけに使うとしても。特定の保護されたキャラクターを再現することだけを目的としたモデルを公開しないこと。そしてプラットフォームを運営しているなら、マーケットプレイスより先に削除経路を作ること。
判決からは出てこないが、おそらく出てくるべきルール。モデルは複製物ではない。出力が複製物だ。つまりリスクはプロンプトに宿り、プロンプトはこのパイプラインで人間がまだ手で書いている唯一の部分だ。
関連記事
Cloudflareが自社監査ツールをOSS化、核は「反論」の仕組み
6つのフェーズ、3つの判定、そして最も重要な規則。findingを検査するエージェントは決して発見したエージェントではない。Cloudflare自身が「1回では約半分」と認めている。
LLMエージェントで作る証券会社、11万7000スター。まず免責事項を読むべき理由
アナリスト、強気派、弱気派、トレーダー、リスク管理、ポートフォリオマネージャー。組織図がそのままアーキテクチャであり、非決定性に関するREADMEの一言が最重要だ。
Markdown 1枚に22.5万スター、Karpathyの不満は4つの原則になった
コードもビルドもベンチマークもない。4つの原則を書いた CLAUDE.md が今年の能力リリース以上に注目された——その落差こそが本題だ。
Impeccable:モデル不要の62ルールでAIスロップを見抜く
どこもかしこも Inter、紫のグラデーション、カードの中のカードという光景を、24 のコマンドと 62 の決定的ルールで CI 上からトークンを使わずに止めるデザインスキル。