
„Das Modell ist nicht die Kopie“: Was ein chinesisches Gericht zu einem Medusa-LoRA sagte
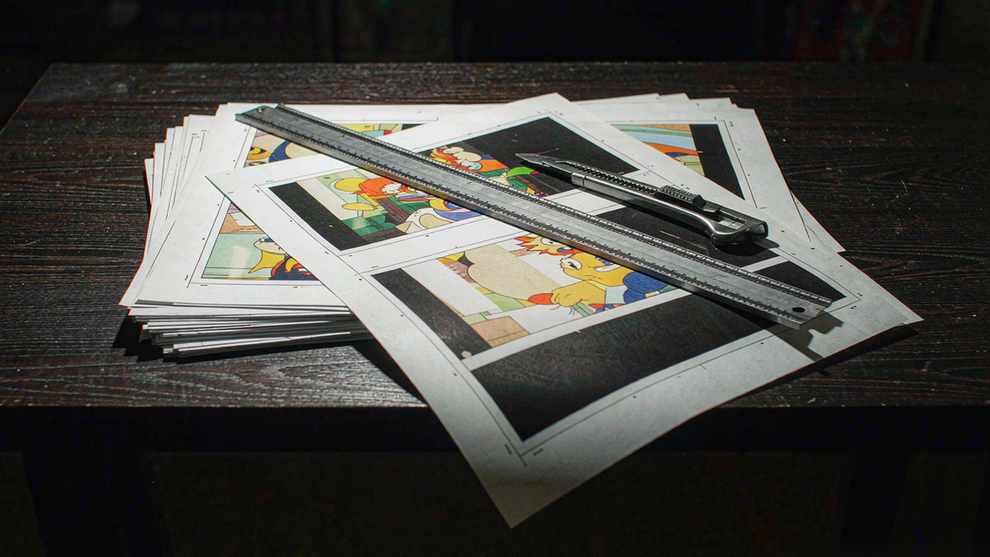
Gut zwanzig Screenshots aus einem Anime, ein bezahltes Videoabo, ein Freistellwerkzeug und ein „LoRA trainieren“-Knopf auf einer Plattform. Das ist der gesamte Sachverhalt eines chinesischen Urheberrechtsfalls, der nun in zweiter Instanz entschieden ist – und die Begründung ist nützlicher als das Ergebnis.
Die Klägerin hält die Rechte am Charakterdesign von Medusa aus Battle Through the Heavens, einer lang laufenden chinesischen Animationsserie. Ein Nutzer nahm mehr als zwanzig Einzelbilder dieser Figur, bereinigte sie, speiste sie in die LoRA-Trainingsfunktion einer Plattform und erzeugte zwei kleine Modelle – eines nach einem neuen Kostüm benannt, eines nach einer aktuellen Version. Beide veröffentlichte er auf der Plattform. Andere Nutzer tippten daraufhin Prompts ein und erhielten Bilder von Medusa, teils identisch, teils nah dran.
Die Klägerin verlangte 2 Millionen Yuan von der Plattform und 200.000 vom Nutzer, mit gesamtschuldnerischer Haftung in einem Rahmen von 150.000. Das Gericht hielt den Nutzer für haftbar und ließ die Plattform laufen. Beide Ergebnisse zählen, aber die Begründung dazwischen ist der Teil, der sich zu lesen lohnt.
Kopieren ist Vervielfältigung, nicht Speichern
Die Begründung der Berufungsinstanz ruht auf einem einzigen dogmatischen Zug: Der Kern des Vervielfältigungsrechts ist das Recht zu vervielfältigen, also das Werk erneut wahrnehmbar zu machen. Nicht, es zu speichern. Nicht, daraus zu lernen. Es zurückzuholen.
Das Gericht zerlegte die Kette dann in drei Glieder und beurteilte jedes einzeln.
Erstes Glied: die Screenshots nehmen und zu einem Trainingspaket schneiden. Das ist Vervielfältigung und verletzt das Recht.
Zweites Glied: das Paket in das LoRA-Training geben. Das Gericht hielt dies nicht zwingend für eine Vervielfältigung, und die Erklärung, die es übernahm, ist der eigentliche Wendepunkt. Ein LoRA lernt eine niedrigrangige Matrix von Gewichtsverschiebungen. Es ist, in der Formulierung des Gerichts, eine niedrigrangige statistische Kompression und keine Kodierung der Originalbilder. Diese Parameter lassen sich nicht wieder zum Originalbild zusammensetzen.
Drittes Glied: der Moment, in dem ein Nutzer einen Prompt eingibt und das Modell etwas erzeugt, das dem Original im Wesentlichen ähnlich ist. Dann ist die Vervielfältigung vollendet, und dann greift die Haftung.
{{INLINE1}}Warum das technische Detail den Fall entschied
Zum ersten Mal muss ein chinesisches Gericht in einem Urteil sagen, was ein LoRA eigentlich enthält. Die übernommene Antwort ist die, die die meisten ML-Ingenieure geben würden: ein rangzerlegtes Delta, ein paar Millionen Zahlen, die das Verhalten des Basismodells verschieben, ohne eine abrufbare Kopie irgendeines Trainingsbildes.
Das ist wichtig, weil es zwei Dinge trennt, die man gewohnheitsmäßig verschmilzt. Auf einem Werk zu trainieren und ein Werk zu vervielfältigen sind verschiedene Handlungen, und die zweite braucht einen zweiten Akteur – die Person, die den Prompt getippt hat. Das Gericht baute eine Kausalkette mit einer konkreten Menschenhand an ihrem Ende.
Es entsteht auch ein sauberer Test, der nicht auf Bauchgefühl beruht. Ist die Ausgabe im Wesentlichen ähnlich, hat die Vervielfältigung stattgefunden. Wenn nicht, dann nicht. Das ist ein Maßstab, gegen den ein Beklagter sich tatsächlich verteidigen kann, anders als gegen „das Modell hat dein Werk gesehen“.
Vergleichen lässt sich das mit dem britischen Verfahren Getty gegen Stability, in dem Sachverständige belegten, dass die Gewichte von Stable Diffusion keine Kopien der Trainingsbilder speichern oder enthalten, sondern nur daraus abgeleitete statistische Muster. Das englische Gericht nutzte diese Feststellung, um Ansprüche auf mittelbare Verletzung abzuweisen. Getty darf wegen der Auslegung von „infringing copy“ in Berufung gehen, eine Anhörung wird im November erwartet. Zwei Jurisdiktionen, verschiedene Gesetze, ein ähnliches technisches Bild.
Die Plattform kam durch das Verfahren davon, nicht durch Unschuld
Das Entkommen der Plattform ist zerbrechlicher, als es aussieht, und das ist der Teil, den andere Plattformen zweimal lesen sollten.
Das Gericht hat nicht entschieden, dass das Anbieten einer Trainingsfunktion an sich sicher ist. Es hat entschieden, dass das gezielte Training vom Nutzer durchgeführt wurde, der das Basismodell wählte, das Material hochlud und die Parameter setzte. Die Plattform lieferte ein Basismodell, Rechenleistung und einen Veröffentlichungskanal. Ihre Haftung hing davon ab, ob sie die Sorgfaltspflicht erfüllte, die ihrer Fähigkeit zur Informationsverwaltung entspricht – und hier nahm sie die Modelle herunter und benachrichtigte eine ausländische Plattform, die die Daten gespiegelt hatte.
Lesen Sie das als Checkliste, nicht als Freispruch. Meldung, Takedown und ein dokumentierter Eskalationsweg haben der Plattform ihr Ergebnis gekauft. Eine Plattform, die LoRAs hostet und nichts tut, wenn ein Rechteinhaber sich beschwert, steht anders da, und dasselbe Gericht würde das sagen.
Ein loser Faden aus erster Instanz. In einem separaten Hangzhou-Verfahren zu Ultraman-LoRAs prüfte das erstinstanzliche Gericht, ob Training als Fair Use gelten kann, wenn nichts dafür spricht, dass es auf die Ausnutzung der ausdrucksstarken Eigenart des Werks zielte, und kein unangemessener Schaden beim Rechteinhaber entsteht. Die Berufung erreichte diese Frage nicht. Die Fair-Use-Tür steht in der chinesischen Praxis also noch offen, nur ist noch niemand hindurchgegangen.
Der größere Rahmen kam im September
Am 7. September veröffentlichte der Oberste Volksgerichtshof Chinas seine Stellungnahmen zur Verhandlung KI-bezogener Streitigkeiten, die ersten justiziellen Regeln des Landes für diese Kategorie. Artikel 12 verteilt die Haftung zwischen Entwicklern, Anbietern und Nutzern und wägt dabei Art des Dienstes, Herkunft der Trainingsdaten, Grad der Beteiligung jeder Partei, ergriffene Maßnahmen und erzielten Gewinn ab.
Er belastet zudem Entwickler, die Nichtverletzung geltend machen: Sie müssen Belege zur Herkunft der Trainingsdaten, Aufzeichnungen des Trainingsprozesses und eine Erklärung der Funktionsweise des Modells vorlegen. Artikel 14 bestätigt separat, dass KI-gestützte Erfindungen patentierbar sind, der Erfinder aber eine natürliche Person sein muss.
Das ist dieselbe Struktur wie im Medusa-Urteil, verallgemeinert. Haftung folgt der Erklärungsfähigkeit. Wer die technischen Fakten hat, trägt die Last, sie zu beschreiben.
Wo die Begründung noch brechen kann
Das Niedrigrang-Argument trägt sauber für ein kleines LoRA, das auf zwanzig Bildern trainiert wurde. Es wird wackliger, je größer das Trainingsset und je höher der Rang, weil ein Modell ab einem gewissen Punkt memorieren statt generalisieren kann und die Grenze zwischen „statistischer Kompression“ und „verlustbehafteter Kopie“ nicht mehr offensichtlich ist.
Der britische Getty-Fall hat hier bereits eine Markierung gesetzt: Die Sachverständigen beider Seiten waren sich einig, dass Stable Diffusion unter bestimmten Bedingungen Bilder mit Getty-Wasserzeichen ausgibt, weil die Trainingsdaten wasserzeichenversehene Bilder enthielten und das Modell genug memoriert hat, um die Markierung zu reproduzieren. Das englische Gericht beschränkte seine markenrechtliche Feststellung auf drei Beispielbilder und wies die weitergehende Klage zu SDXL und v1.6 nach Beweislage ab. Die Lehre ist nicht, dass Memorierung nicht vorkommt. Sondern dass Memorierung pro Modell, pro Prompt, pro Ausgabe nachgewiesen werden muss.
Genau dort wird dieses Urteil als Nächstes geprüft. Kann ein Kläger zeigen, dass ein einziger Prompt eine geschützte Figur zuverlässig neu erzeugt, schließt sich das dritte Glied und die Haftung kehrt zurück. Die technische Frage wird in jedem künftigen Fall sein, wie viele Versuche es gebraucht hat.
Was das bedeutet, wenn Sie LoRAs trainieren
Die praktischen Regeln, die aus dem Fall folgen, sind nicht kompliziert. Bauen Sie keine Trainingssets aus urheberrechtlich geschützten Einzelbildern, für die Sie keine Lizenz haben, auch wenn Sie sie nur privat zum Bau eines Werkzeugs verwenden. Veröffentlichen Sie kein Modell, dessen ganzer Zweck die Reproduktion einer bestimmten geschützten Figur ist. Und wenn Sie eine Plattform betreiben, bauen Sie den Takedown-Weg, bevor Sie den Marktplatz bauen.
Die Regel, die nicht folgt, aber wahrscheinlich folgen sollte: Das Modell ist nicht die Kopie. Die Ausgabe ist es. Was heißt: Das Risiko lebt im Prompt, und der Prompt ist der einzige Teil der Pipeline, den ein Mensch noch von Hand schreibt.
Verwandte Artikel
Eine Handelsfirma aus LLM-Agenten: 117.000 Sterne – und ein Disclaimer
Analysten, Bulle, Bär, Händler, Risikoteam, Portfoliomanager: Das Organigramm ist die Architektur, und die README-Warnung zur Nichtdeterminiertheit ist darin die wichtigste Zeile.
225,000 Sterne für eine Markdown-Datei: Karpathys Klagen als Regeln
Kein Code, kein Build, kein Benchmark: Vier Prinzipien in einem CLAUDE.md bekamen mehr Aufmerksamkeit als die meisten Fähigkeits-Ankündigungen des Jahres.
Cloudflares Audit-Agent ist offen: Der Widerspruch ist das Produkt
Sechs Phasen, drei Urteile und eine Regel, auf die es ankommt: Der Agent, der einen Befund prüft, ist nie der Agent, der ihn fand. Cloudflare gibt zu, dass ein Lauf nur etwa die Hälfte findet.
Impeccable: 62 deterministische Regeln gegen KI-Slop
Inter überall, Violett-Verläufe, Karten in Karten: 24 Kommandos und 62 deterministische Regeln stoppen KI-Slop in der CI, ohne einen einzigen Token.