
Un modello anime ha imparato a leggere gli omini. Il divario da 0.37 a 0.83 è il numero interessante.
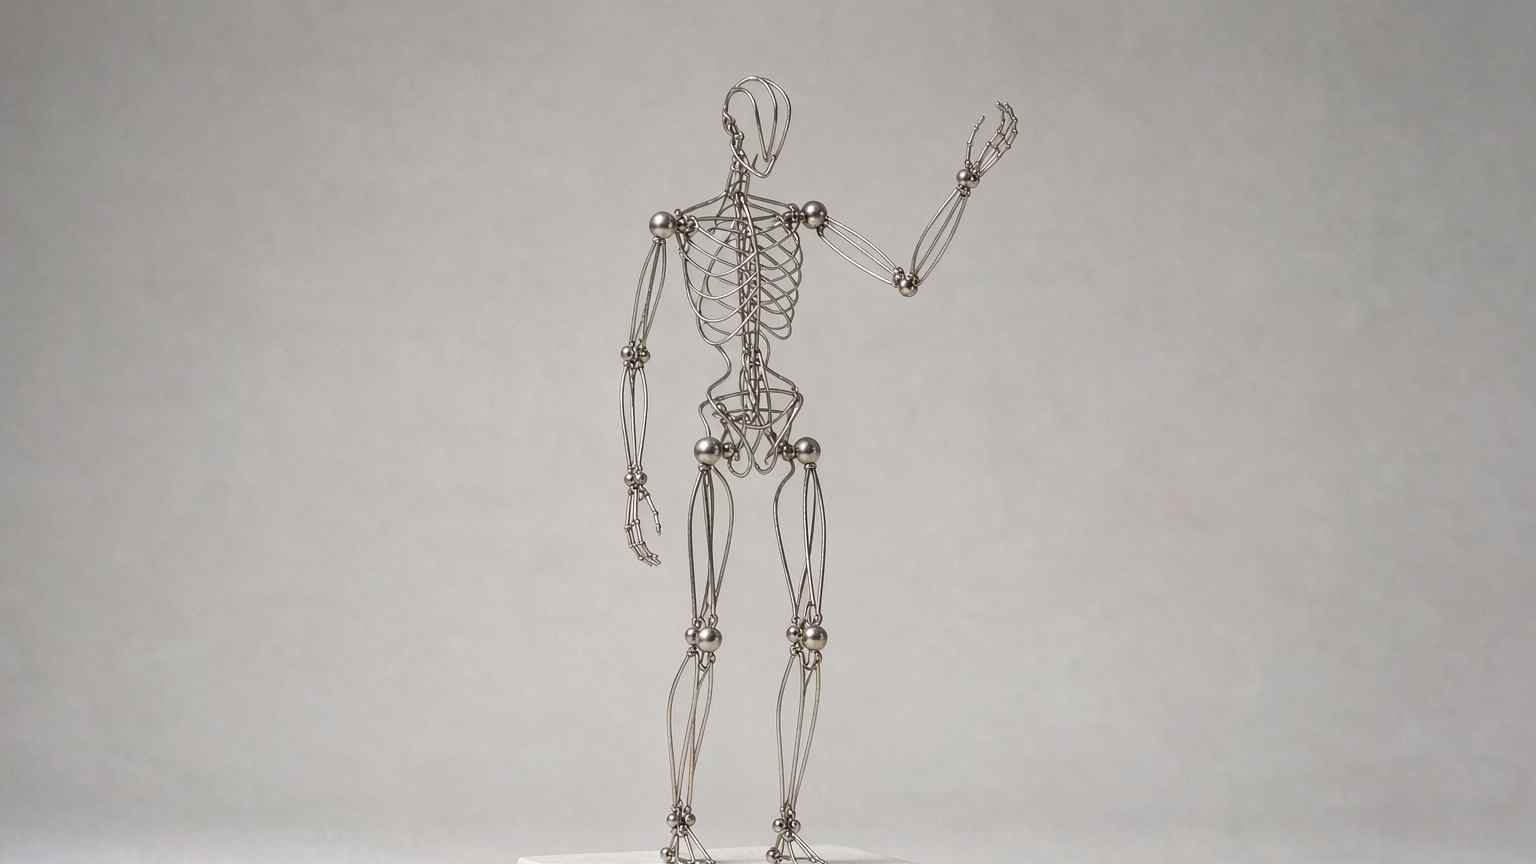
Il 2 novembre è apparso un repository chiamato Anima-Control-Pose, con una build di anteprima di una guida di posa per un modello di immagini anime. Gli passi una fotografia di riferimento, il detector incluso disegna uno scheletro sopra la persona e il personaggio segue quello scheletro.
Le note di rilascio sono brevi e insolitamente precise su quello che non funziona. Le pose di corsa, salto e seduta sono le meno affidabili. Le mani continuano a fondersi. Il detector è stato costruito per le fotografie, quindi legge male il disegno anime.
È quell'ultima riga a dirti che l'autore lo strumento lo ha usato davvero.
A cosa serve il controllo di posa, e perché l'anime ne vuole uno suo
Il condizionamento per posa è un problema risolto nella generazione di immagini in generale. Sovrapposizioni di scheletri, mappe di profondità e mappe di bordi sono input di controllo standard da un paio d'anni, e i modelli generalisti gestiscono la fotografia di una persona con una fedeltà ragionevole.
L'anime è un problema diverso. Le proporzioni sono stilizzate. Le teste sono grandi, gli arti sottili, le mani sono disegnate come cinque linee pulite invece che come geometria fotografata. Un detector addestrato sulle fotografie guarda una tavola di manga e produce uno scheletro più o meno giusto nel busto e sbagliato ovunque altro, perché gli indizi su cui si appoggia, i rigonfiamenti delle articolazioni e le ombre sulla pelle, lì non ci sono.
Quindi una pipeline anime ha bisogno di due cose insieme: un segnale di controllo che il modello riesca a seguire, e un modo per ricavarlo da quello che l'artista ha davvero in mano, che di solito è uno schizzo, una foto di riferimento o una figura abbozzata.
Anima-Control-Pose prende la strada indiretta: foto in ingresso, scheletro in uscita, il personaggio segue. È il flusso che un illustratore con una foto di riferimento di una posa vuole davvero, ed è il motivo per cui lo strumento esiste.
Il numero e cosa misura
L'autore riporta una precisione di posa che passa da circa 0.37 senza l'add-on a circa 0.83 con l'add-on, a 1024 pixel. A 512 e 768 i guadagni sono più piccoli.
Su quel numero vale la pena separare tre cose.
È una misura dell'autore, sul set di valutazione dell'autore. Non c'è nessun controllo di terzi, nessun benchmark standard e nessun protocollo dichiarato su cosa conti come posa corretta. Il valore serve come direzione e come prova che l'add-on fa qualcosa di sostanziale. Non è confrontabile con un numero di benchmark pubblicato.
La dipendenza dalla risoluzione ha senso meccanicamente. L'estrazione dello scheletro e l'aderenza alla posa peggiorano quando il personaggio occupa meno pixel, e le generazioni anime a 512 pixel sono sempre state il caso difficile per i layer di controllo. Che il guadagno lì si riduca è un limite, non una nota a piè di pagina.
Il divario tra 0.37 e 0.83 è la metà più interessante. Un modello che segna 0.37 di aderenza alla posa non è inutilizzabile; è un modello che produce un personaggio nell'atteggiamento più o meno giusto, con gli arti che fanno qualcosa di simile. Gli artisti ci lavorano rigenerando. Passare a 0.83 trasforma il rigenerare in dirigere, e questo cambia quante generazioni costa un'inquadratura.
Tre cose che ancora non sa fare
La scheda le elenca e conviene prenderle alla lettera.
Corsa, salto e seduta sono le meno affidabili. Guarda il perché. Quelle pose implicano auto-occlusione, scorcio e contatto con una superficie che non si vede. Uno scheletro codifica posizioni delle articolazioni, e le posizioni delle articolazioni sono meno informative proprio quando il corpo si piega su se stesso. L'angolo dell'anca di un personaggio seduto è invisibile in un omino.
Le mani si fondono. Le mani sono il guasto più vecchio delle immagini generative e la soluzione non è mai stata il condizionamento per posa. Un detector produce keypoint di polso e dita con poca confidenza, il modello dipinge un accenno di mano e l'artista la ridisegna. Ogni pipeline anime in produzione ha un passaggio di correzione delle mani. Questa non lo toglie.
Il detector legge male il disegno anime. Questo è quello strutturale. Lo strumento vede bene le fotografie perché è stato addestrato sulle fotografie. Se il tuo riferimento è una tavola di manga, uno schizzo o un'altra generazione IA, lo scheletro che disegna può essere plausibile e sbagliato, e uno scheletro sbagliato produce un personaggio sbagliato con sicurezza.
È quel terzo limite a definire il perimetro dello strumento. Sta all'inizio della pipeline, converte riferimenti del mondo reale in un segnale di controllo, e non è un ponte tra due immagini anime.
La baseline di 0.37 è anche un'affermazione sul modello base, e va letta così. Senza l'add-on, a un modello anime a cui chiedi di seguire uno scheletro riesce più o meno un terzo della posa. Tutto quello che un illustratore ha fatto per aggirare la cosa, dalle passate img2img all'inpainting degli arti uno alla volta, nasce da quel numero. Portarlo a 0.83 riduce il lavoro; non elimina il passaggio di controllare il risultato.
Cosa c'è dentro e quanto costa usarlo
Il pacchetto è modesto: due cartelle di nodi ComfyUI, quattro workflow di esempio con `pose_control_demo.json` come punto di ingresso e un detector da circa 316 megabyte.
ComfyUI come canale di distribuzione ormai è la norma, e ha un effetto collaterale da guardare. Un JSON di workflow è insieme documentazione, tutorial e artefatto di riproducibilità. Se riesci a caricare il file, vedi ogni parametro usato dall'autore, ed è una forma di trasparenza che quasi nessun rilascio di modello offre. Significa anche che il comportamento dello strumento è riproducibile sulla tua macchina e col tuo seed, che è l'unico modo perché l'affermazione sullo 0.83 diventi verificabile da qualcuno che non l'ha scritta.
I pesi sono non commerciali. Per un modello anime con una community ampia di appassionati è un assetto familiare: gratis per chi fa fan art, licenza separata per chi la vende. Significa anche che uno studio non può adottarlo senza una conversazione, e quella sarà la variabile decisiva per la maggior parte degli utenti professionali, qualunque sia il numero di precisione.
Lo schema che questo rilascio rappresenta
La generazione anime ha passato due anni a convergere su uno stack: un modello base, un set di LoRA di personaggi e layer di controllo per posa, line art e composizione. Ogni layer è un piccolo rilascio separato di un autore separato, spesso con un file di workflow e una scheda che elenca i difetti.
Quella struttura ha dei costi. La compatibilità tra i layer non è il lavoro di nessuno, e un aggiornamento del modello base può rompere quattro add-on in una volta. Ha anche un vantaggio che l'estremità rifinita del mercato continua a provare a comprare: le liste dei difetti sono pubbliche, perché gli autori sono utenti.
Anima-Control-Pose è un rilascio piccolo con una scheda onesta. La domanda interessante non è se 0.83 sia buono. È se l'ecosistema continui a pubblicare il numero, o se la prossima versione arrivi con un reel dimostrativo e senza denominatore.
Tieni il denominatore. È l'unica parte che ti lascia decidere.
Articoli correlati
Un foglio di calcolo comunitario di tocchi che spegne la pubblicità negli Android cinesi
Non tocca il sistema, non sblocca niente, non flasha niente. Ribalta solo gli interruttori che i produttori hanno già previsto. Il prezzo è una lista che qualcuno deve continuare a scrivere.
GPT Image 2.6 ha tenuto il prezzo dei token e alzato la fattura
GPT Image 2.6 conserva ogni tariffa per token di 2.5 e costa comunque di più per immagine, perché buona parte del lavoro passa ora nei token di output. Undici giorni dopo il lancio, la struttura dei prezzi dice più della classifica.
Qualcuno ha ricostruito IDM dall'esterno e ha scritto cosa non ha toccato
Una reimplementazione in Rust di Internet Download Manager promette 5 volte la velocità e 86 lingue. Il documento più interessante è il paragrafo che spiega come è stata costruita senza copiare nulla.
Rune è un framework UI per Rust costruito perché un agente possa verificare il proprio lavoro
Rune renderizza headless, esporta il suo albero di elementi e accetta input scriptato, dando a un agente di coding un segnale diffabile che nessuno screenshot può offrire. Il framework è in pre-release e non accetta pull request.